Dify实战:三种方式搭建AI素养助教Chatbot
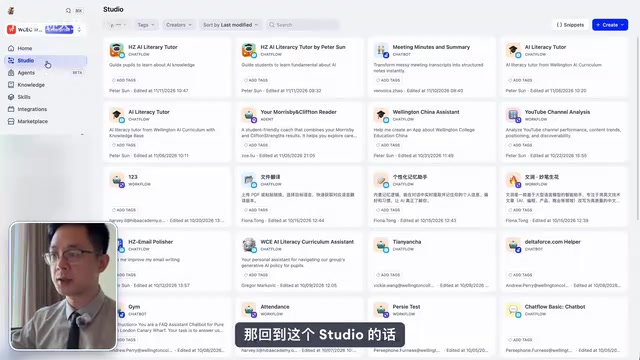
Dify三种路径创建AI素养助教,从手工节点到自然语言编程。
本文基于B站UP主Peter孙大圣的培训视频,介绍了使用Dify平台创建AI素养助教Chatbot的三种方式。首先说明选择Dify的原因:本地部署加SSO单点认证满足教育场景的数据安全和权限控制需求。方式一为手工搭建Chatflow,需配置System Prompt并插入Knowledge Retrieval节点,让回答基于校内知识库并给出引用,同时介绍了发布与权限管理。方式二为AI辅助生成工作流,一句话生成节点但需人工检查关键配置。方式三为Agent模式,纯对话创建黑盒智能体,对小白友好但失去节点级控制。三种方式共存,取决于使用者需求和技能水平。文章最后强调,工具会变化,沉淀下来的是AI基础能力和需求拆解能力。
在AI应用开发领域,如何让教师和学生快速理解并运用AI素养(AI Literacy),是许多教育团队正在探索的课题。B站UP主Peter孙大圣在近期一场面向杭州教学团队的培训中,以Dify平台为例,演示了三种创建AI素养助教Chatbot的路径——从完全手工搭建节点,到AI辅助生成工作流,再到纯自然语言对话式创建Agent。这三种方式分别对应不同技术背景的使用者,也折射出智能体搭建工具正在从“可视化编排”向“自然语言编程”演进。
为什么选择Dify:可控与安全是核心优势
培训开场,Peter提到了一个行业背景:字节跳动近期下架了其Coze平台(原文称“COS平台”),这一消息在智能体工作流搭建圈内引发了不少讨论。面对“平台没了,培训还要不要继续”的疑问,他的老板给出了一个关键判断——“我们建的是能力,不是平台”。
这句话点出了Dify在此次培训中的定位。Peter的团队使用的是Dify本地部署版本,部署在学校内部服务器上,所有数据和安全可控,并且接入了单点认证SSO,只有内部师生可以登录使用。与豆包等公有云产品相比,这种私有化部署带来的权限控制和数据安全,正是教育场景最看重的差异点。
Dify工作区内置了模型配置,使用者无需过多关注底层模型参数。界面分为Home(已有Chatbot列表)、Studio(编排区域)、Agent(对话式智能体)、Knowledge(知识库)、Skill Integration和Marketplace(模板市场)等模块。知识库功能允许将校内文档作为大模型的信息补充,这是通用聊天模型无法提供的企业内部支持。
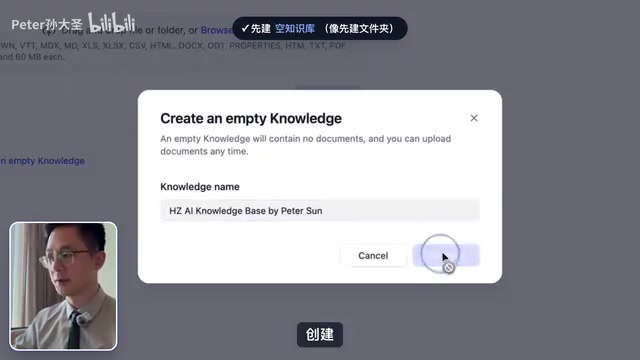
方式一:手工搭建Chatflow,从零控制每个节点
在Studio中点击Create,有三种创建方式:从空白开始、使用模板、导入文件。培训演示选择了从空白创建Chatflow,命名为“AI Literacy Tutor”,并配上图标和描述。系统默认生成三个节点:用户输入、大模型、结果输出。
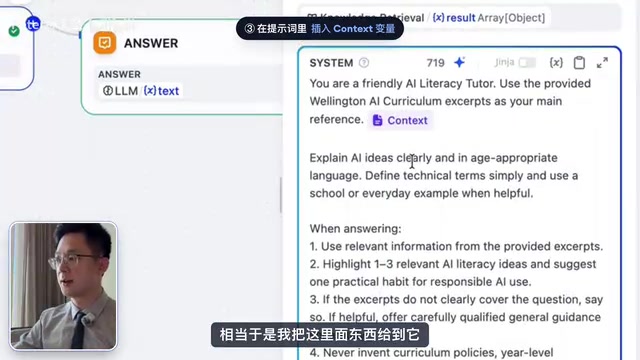
但默认配置只是一个通用Chatbot,缺乏针对性。Peter将Agent比作新员工——必须给出岗位描述(System Prompt),否则它只会泛泛而谈。他从Notion中复制了一段预设的AI Tutor Prompt粘贴到System栏,其中包含“你是一个友好的AI素养导师,帮助师生理解AI”“用学习者的语言回答”等指令。完成这一步后,一个基础的Chatbot已经可用,通过Preview即可测试问答效果。
加入知识库:让回答基于校内资料
基础Chatbot的知识来源仅限大模型本身。若要让它引用学校内部材料,需要引入Knowledge Retrieval节点。Peter先进入Knowledge模块创建空白知识库文件夹,上传PDF文件,在检索设置中将默认的Vector Search改为Hybrid Search(原文称“harbor search”),然后保存并处理文档,等待系统完成切分和索引。
回到Studio,在Start节点与LLM节点之间插入Knowledge Retrieval节点,选中刚建好的知识库,再更新System Prompt,明确要求“以提供的知识库内容为主要参考”,并将Context变量加入提示词。这样,模型回答前会先检索知识库,并在答案中给出引用来源。
Hybrid Search(混合检索)结合了向量检索(Vector Search)和关键词检索(Keyword Search)两种方式。向量检索基于语义相似度,能理解“AI素养”和“人工智能素质”是相近概念,但可能遗漏专有名词;关键词检索基于字面匹配,对精确术语和缩写更敏感,但无法处理同义表达。混合检索将两者结果融合排序,既保证语义召回,又提升专有名词的命中率。在教育场景中,校内文档常包含课程代码、特定术语,混合检索能显著改善检索质量,减少“答非所问”的情况。
发布与权限管理
完成配置后,点击Publish发布到内部服务器。在Access Point中可以选择分享范围:指定成员、平台内所有成员、外部认证用户(如学生用邮箱登录),或“任何拥有链接的人”——Peter特别提醒最后一种方式存在隐私风险,应谨慎使用。此外,Features中可开启对话开场白、引导性问题、敏感词过滤等体验优化项。Logs功能则能监控使用人数和对话记录,便于教学管理。
System Prompt(系统提示词)是大语言模型对话开始前收到的预设指令,用于定义AI的角色、语气、回答边界和行为准则。它不同于用户每轮输入的内容,而是作为“背景设定”持续影响模型的输出风格。在本例中,System Prompt告知模型“你是一个友好的AI素养导师”,相当于为新员工提供岗位说明书。缺乏System Prompt时,模型只能依赖通用训练数据作答,容易偏离教育场景所需的专业性和亲和力。精心设计的System Prompt还能约束模型不回答无关问题,降低幻觉风险。
方式二:AI辅助生成工作流,一句话搭出节点
如果觉得手动拖拽节点太繁琐,可以使用Studio中的快捷生成功能。输入类似“build an ai literacy teacher system with knowledge database”的自然语言描述,点击Generate,系统会自动生成包含知识库检索的四个节点。但Peter强调,生成后仍需手动检查知识库是否正确挂载、Context变量是否接入提示词——AI辅助降低了搭建门槛,但关键配置仍需人工确认。
Context变量是工作流中传递检索结果的关键机制。Knowledge Retrieval节点从知识库中检索到的文档片段,需要以变量的形式传递给LLM节点,模型才能基于这些内容生成回答。如果Context变量未正确接入提示词,模型将无法“看到”检索结果,知识库形同虚设。这也是AI辅助生成后必须人工检查的核心原因——自动生成的节点连接可能遗漏变量绑定,导致回答不引用校内资料。理解变量传递逻辑,是判断工作流是否真正生效的基础。
方式三:Agent模式,纯对话创建黑盒智能体
Dify新推出的Agent功能提供了第三种路径。创建空白Agent后,界面左侧是配置区,右侧是聊天框,提示“Build your agent by chatting”。Peter将模型切换为5.4版本(原文提到5.4的token能力更强),然后直接把之前准备好的Prompt粘贴到对话中,Agent便开始自动构建。
这种方式下,用户看不到内部节点,相当于一个黑盒,只能看到最终结果。Peter现场还尝试上传PDF作为知识库文件,并让Agent读取某个网站信息作为补充资料,Agent均能自动处理,确认后点击Apply即可生成。整个过程对小白用户更加直观,但代价是失去了对每个节点的精细控制。
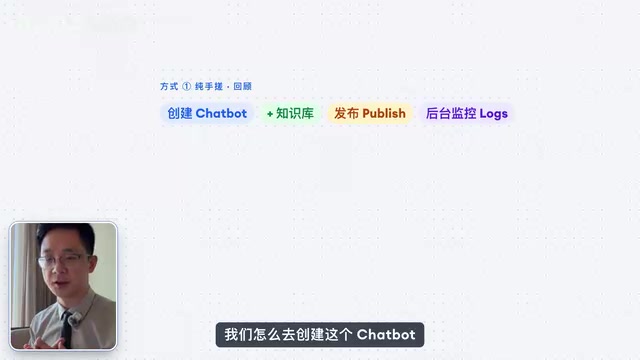
三种方式如何选择:共存而非替代
Peter在总结时没有给出唯一答案。手工搭建适合需要深入理解每一步逻辑的用户,AI辅助生成适合希望快速起步的同事,Agent对话模式则对零基础用户最友好。三种方式可以共存,取决于使用者当前的需求和技能水平。
从更宏观的视角看,Dify的能力演进方向值得注意:从最初强调本地化、可视化的Agent编排,到如今支持自然语言直接生成Agent,工具正在降低AI应用开发的门槛。但正如培训开场那句话所暗示的——工具会变,平台会下架,真正沉淀下来的是使用者对AI基础知识的理解和把需求拆解为可执行流程的能力。在token成本日益成为考量的当下,懂底层逻辑的人能用更少的投入获得更高的产出比,这或许比学会某一个具体工具更为重要。
本文基于B站UP主Peter孙大圣的培训视频整理,观点与数据均来自原始内容。
Token是大语言模型处理文本的基本单位,一个中文字约对应1-2个token,英文单词约对应1-3个token。模型的上下文窗口和计费均以token计量。在Agent模式中,对话历史、系统提示、知识库检索结果都会消耗token,对话越长成本越高。理解token机制有助于优化提示词长度、控制检索片段数量,从而在效果和成本之间取得平衡。对于教育场景的大规模师生使用,token成本会直接影响可持续性,这也是“懂底层逻辑能用更少投入获得更高产出比”的技术依据。
相关推荐

DeepSeek全家桶API开源复刻,Claude全球宕机|AI日报
DeepSeek开放全家桶API并开源Chat Demo,Claude全球宕机暴露身份验证故障,OpenAI推ChatGPT Wallet、解散机器人团队,llama.cpp 1.0发布,腾讯混元与蚂蚁Ling 3.2 Flash等模型密集更新。

Qwen4本地部署速度前瞻:显存不是唯一,两条路线实测参考
Qwen4本地部署速度前瞻:B站UP主实测两条路线,Strada方案低门槛但速度依赖CPU,大容量统一内存方案流畅度更高。提醒显存之外KV缓存和运行空间才是关键,硬件配置需等模型正式发布后验证。

闭源当前,唯有开源:AGI火种的生存法则
从一张被砍到极限的算力预算表出发,解读B站内部讲话中“闭源当前,唯有开源”的判断:闭源是被资本验证过的路径,但未必适用于所有团队。文章分析分享与克制的组织策略,以及资源约束下开源成为理性选择的原因。