Qwen4本地部署速度前瞻:显存不是唯一,两条路线实测参考

本地部署大模型别只盯显存,KV缓存与运行空间才是关键刚需。
文章围绕「Qwen4 发布前是否该囤显卡」这一热点,指出本地部署大模型的真正瓶颈不在模型权重,而在常被忽略的 KV 缓存与运行空间。作者梳理了两条主流路线:Strada 方案将热门专家模块放显存、其余交给内存与 CPU,门槛低但速度完全依赖 CPU,调用频繁时延迟飙升;大容量统一内存方案减少数据搬运,为模型和缓存留足余量,实测输出速度流畅。文章提醒用户不要只看模型能否装下,要为 KV 缓存留足余量,并强调 Qwen4 的正式配置需待发布后验证,不建议盲目囤卡。最后以「输出速度还是上下文长度」作为选型核心权衡点。
Qwen4尚未正式发布,已经有不少人开始囤显卡准备本地部署。但显存越大就越好用吗?B站UP主“千万在这边RGB Fresh Next”用一段实测给出了提醒:本地部署大模型,除了模型权重本身,KV缓存和运行空间才是真正吃显存的刚需。很多人买了贵显卡却跑成PPT,问题往往出在没有把这部分空间算进去。
两条主流本地部署路线
围绕“小显存能不能跑大模型”这个核心问题,UP主拆解了两条路线,分别对应不同的硬件配置和性能预期。
路线一:Strada方案——低门槛,但速度受限于CPU
Strada方案的思路是“分工”:热门模型的专家模块放在显存,其余部分交给内存和CPU,甚至可以把部分数据放在硬盘中。它的优势是门槛低,普通配置也能尝试大模型部署。
代价也很直接:速度完全依赖CPU。当调用频繁度上升时,延迟会飙升,显存省下来的部分需要整机硬件配合才能补回来。这条路线适合预算有限、愿意用速度换可运行性的用户。
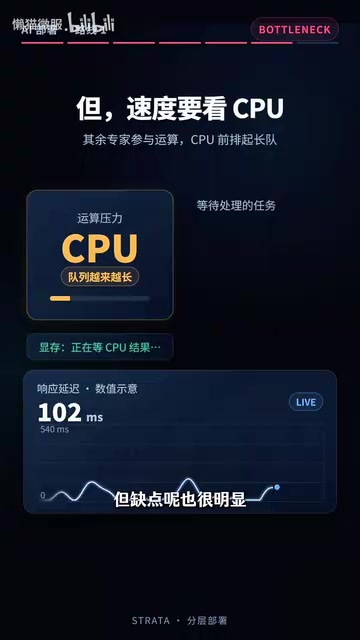
混合专家(MoE)架构 是理解 Strada 方案「专家模块放显存、其余放内存」的前提。MoE 模型由多个前馈专家网络加一个路由门控组成,每个 token 只激活其中少数专家,因此总参数量可以远大于单次计算实际用到的参数量。这种「参数多、激活少」的特性使按需加载成为可能:把高频专家常驻显存,冷门专家留在内存或硬盘,按路由结果动态调取。代价是路由切换会引入额外的数据搬运和同步开销,调用越密集,CPU 与内存带宽越容易成为瓶颈。
路线二:大容量统一内存——追求速度的首选
另一条路线以大容量统一内存为核心,UP主以搭载128G内存、CPU与GPU共享空间的方案作为参考。统一内存减少了数据搬运,同时给模型和KV缓存留出了足量余量。
据其实测,这套配置在面对相关模型时输出速度可以流畅拉满。具体参数和表现仍需以Qwen4正式发布后的验证为准。
统一内存(Unified Memory) 指 CPU 与 GPU 共享同一物理地址空间,数据无需在两者之间显式拷贝。在传统独立显卡架构中,模型和 KV 缓存必须完整驻留显存,超出即报错或被迫卸载到内存并反复搬运;统一内存则允许模型按需驻留在共享池中,GPU 直接访问,省去 PCIe 传输开销。其代价是共享内存的带宽通常低于专用显存,实际吞吐取决于芯片的内存带宽规格。苹果 M 系列、AMD APU 及部分服务器平台均采用此类设计,这也是「128G 内存跑大模型」体验差异很大的根本原因。
关键提醒:别只看模型大小
UP主给准备入手的用户提了两个醒。第一,不要只看模型能不能装进去,硬件一定要给KV缓存和运行空间留出足够余量。第二,Qwen4的正式配置和运行表现要等模型发布后再验证,不要盲目冲硬件。
这也解释了一个常见误区:显存数字大不等于跑得顺。KV缓存随上下文长度增长,长对话场景下占用会显著上升,忽略这部分需求,再贵的显卡也可能卡顿。
KV 缓存(Key-Value Cache) 是 Transformer 推理阶段的一项关键内存开销。自回归生成时,模型每输出一个 token,都要重新计算它与之前所有 token 的注意力;为避免重复计算,框架会把每一层注意力中的 Key 和 Value 张量缓存下来,后续 token 直接复用。缓存大小约与「层数 × 注意力头数 × 头维度 × 序列长度 × 批大小 × 精度字节数」成正比,因此上下文越长、并发越多,占用增长越明显。以 7B 级模型、FP16 精度为例,几万 token 的长上下文就可能占用数 GB 甚至十几 GB 显存,这正是「模型权重装得下却跑不动」的常见原因。
输出速度与上下文长度,怎么选?
UP主最后抛出一个值得思考的问题:本地部署时,你更看重输出速度,还是更看重处理资料的长度?
这个选择直接对应两条路线。追求速度选统一内存方案,追求低门槛可运行选Strada方案。两者并非绝对对立,但预算分配逻辑不同。对于等待Qwen4开源、准备做适配的用户来说,先想清楚自己的核心场景,再决定硬件投入方向,比盲目囤卡更实际。
相关推荐

12k星开源神器free-claude-code:免费模型接入Claude客户端
free-claude-code开源项目获1.2万星,通过反向代理层将免费模型接入Claude客户端,支持61家模型源、RTK上下文压缩和智能熔断多Key轮换,本文深度解析其工作原理、部署方式与性能实测。

团队如何共用 Claude Code?约定文件、评审与权限边界
团队共用 Claude Code 时,如何通过约定文件统一上下文、建立代码评审机制并设置权限边界?本文基于实际演示,梳理三个关键实践,帮助团队安全高效地利用 AI 编程助手。

DeepSeek开放App全套API能力,Qwen4定档11.17|AI日报
DeepSeek将官方App的联网搜索、文件解析、OCR、语音识别与合成等能力开放为API并开源前端Demo;阿里Qwen4定档11月17日主打编程与Agent;腾讯混元HY4安全指数登顶并开源Flash TopK大幅提速;OpenAI解散机器人团队。