Dllog:操作失败时才回放调试日志的新思路
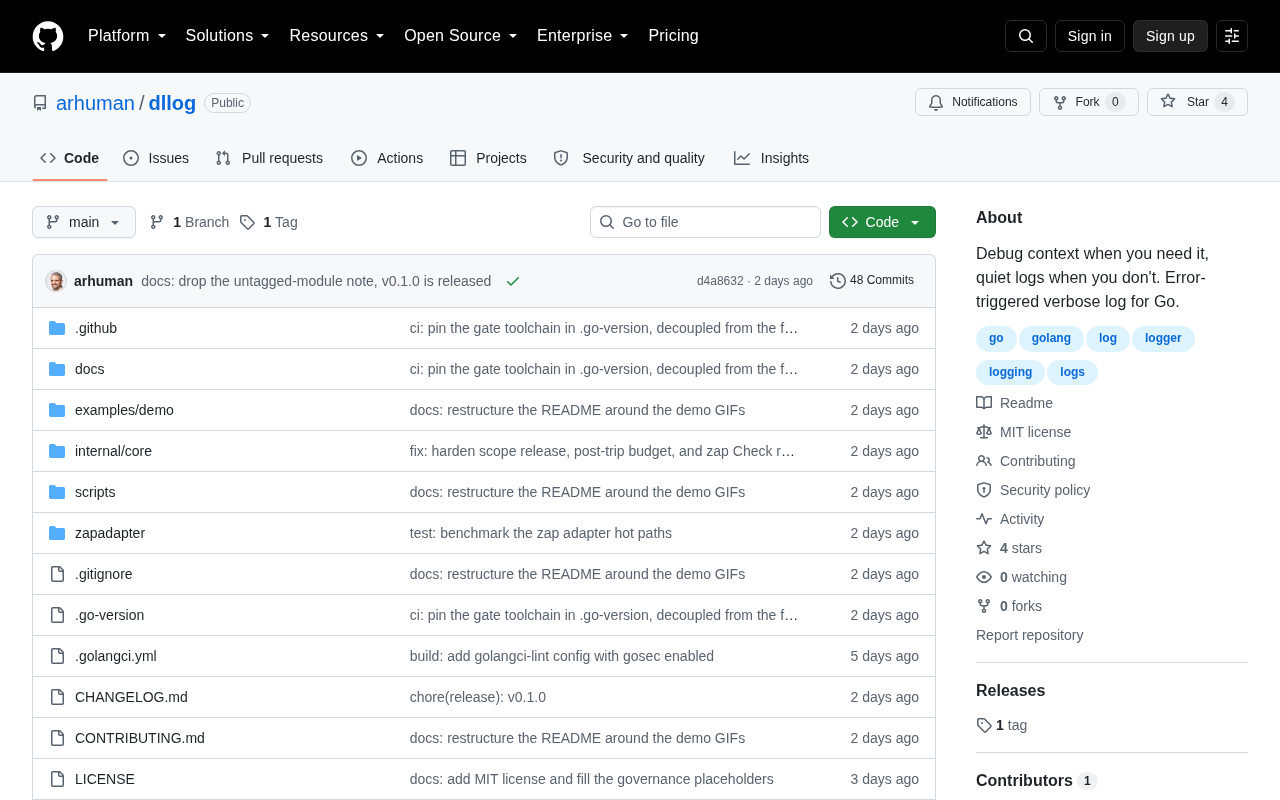
Dllog将调试日志暂存内存,操作成功即丢弃、失败时才回放,以此打破日志系统的「全开或全关」困境。
Dllog 是一个针对日志系统长期痛点的早期工具:开发者要么开启详细日志承受性能与存储代价,要么关闭详细日志牺牲可观测性。Dllog 的解法是将调试日志暂存于内存缓冲区,操作成功时直接丢弃,失败时才将完整调试上下文「回放」输出。这种以操作成败为开关的「延迟持久化决策」模式,让故障排查获得充分细节的同时,避免了正常路径上的日志开销。它最适合请求成功率高、有明确操作边界的服务场景;潜在局限包括内存压力、跨操作问题难追踪及失败边界定义复杂度。项目目前仍处早期,社区验证有限,其核心价值更多在于设计思路层面的启发。
从一个常见痛点说起
每个开发者都遇到过这样的场景:线上服务突然报错,但日志里只有一句干巴巴的错误信息,缺少足够的上下文来定位问题。想要更详细的日志?那就得在生产环境把日志级别调到 DEBUG——可这样一来,正常运行时海量的调试日志会淹没磁盘、拖慢性能,还带来存储与检索成本。
开发者社区 Hacker News 上出现的一个名为 Dllog 的项目,正是针对这一矛盾提出了新的解法。它的核心理念可以概括为一句话:平时不写详细日志,只在操作失败时才回放(replay)出完整的调试日志。
Dllog 的核心思路
传统日志系统的困境在于「全或无」——要么开启详细日志承受性能与存储代价,要么关闭详细日志牺牲可观测性。Dllog 试图打破这种二元选择。
它的基本工作方式是:在一次操作(operation)执行过程中,将调试级别的日志暂存在内存缓冲区中,而不是立即写入持久化存储。当这次操作成功完成时,这些缓冲的调试日志会被直接丢弃;只有当操作失败时,才把之前积累的完整调试上下文「回放」并输出出来。
这种设计的巧妙之处在于,它让开发者能够在故障发生时获得排查所需的完整细节,同时又避免了正常路径上的日志开销。换句话说,你为「失败」付出可观测性成本,而不是为「所有请求」都付出。
为什么这个思路值得关注
从可观测性(observability)的演进来看,这类「按需详细」的思路并非孤例。近年业界讨论较多的采样日志、错误优先追踪等理念,本质上都在回答同一个问题:如何在成本与信息量之间取得平衡。
Dllog 把这个平衡点放在了「操作边界」上——以单次操作的成败作为决定日志去留的开关。这对于请求-响应式的服务、批处理任务、事务型操作等有明确起止边界的场景尤为契合。
在可观测性领域,与 Dllog 思路最接近的已有实践是「基于尾部的采样」(tail-based sampling)——在分布式追踪系统(如 Jaeger、Tempo)中,收集器先缓存一条请求的全部 span,等到整条链路完成后再决定是否保留。这与 Dllog 的「延迟持久化决策」如出一辙,区别在于 Dllog 把这一机制下沉到了单进程的日志层面,无需分布式收集基础设施。另一个相关概念是「环形缓冲日志」(ring buffer logging),常见于 Linux 内核(dmesg)等系统软件:日志持续写入固定大小的内存环形区域,触发特定条件时才 flush 到磁盘。Dllog 本质上是把这一思想与「操作成败判定」结合,让触发条件更贴近业务语义。理解这两个前置概念,有助于评估 Dllog 在不同技术栈中的可移植性与替代方案选择。
适用场景与潜在局限
这类工具最适合的场景是那些大部分时候都成功、偶尔失败的操作。因为绝大多数调试日志都会被丢弃,真正落盘的只是少数失败案例的详细上下文,收益比很高。
不过它也存在需要权衡的地方:
- 内存开销:调试日志需要在操作期间驻留内存,对于长时间运行或产生海量日志的操作,缓冲区可能带来内存压力。
- 跨操作问题难追踪:如果问题不体现为单次操作的明确失败,而是缓慢的性能退化或间歇性异常,这种「失败才回放」的模型可能会漏掉线索。
- 失败定义的边界:什么算「失败」需要开发者显式约定,异常、超时、业务逻辑错误各自如何处理,都需要在集成时考虑清楚。
「操作边界」的概念在不同编程范式下有不同的自然映射:在同步请求-响应模型中,它通常对应一次 HTTP 请求或 RPC 调用的生命周期;在异步或事件驱动架构中,则可能是一个消息消费周期或 saga 事务;在批处理任务中,对应单条记录或单个 chunk 的处理流程。Dllog 的有效性高度依赖开发者能否在代码中为每次操作清晰地标记「开始」与「结束/成败」。对于嵌套操作(子操作失败但父操作被捕获后继续运行),日志的归属与回放策略需要额外设计,否则可能出现「失败被吞掉、日志也随之丢弃」的静默故障风险。这一点在集成时值得重点测试。
一个仍处早期的项目
需要客观说明的是,Dllog 目前是一个刚在 Hacker News 上以「Show HN」形式发布的早期项目,社区关注度还很有限(发布时仅有个位数的投票、暂无评论讨论)。这意味着它的成熟度、生态支持和实战验证都还有待时间检验。
对于关注可观测性工具演进的工程师而言,Dllog 的价值更多在于它提供的设计思路——把日志的持久化决策延迟到操作结果已知之后。这种「延迟决策」的模式,即便不直接采用该工具,也能为自研日志中间件提供启发。
小结
Dllog 用一个简单而务实的想法回应了日志系统长期存在的成本与信息量矛盾:让详细日志只在真正需要它的时候出现。它不是万能方案,但对于有明确操作边界、追求低开销高可观测性的服务来说,是一个值得留意的方向。是否值得引入,取决于你的系统是否契合它的假设——大多数操作成功,而失败时你需要完整的现场。
相关推荐
研发正在分叉:Token充裕型与Token匮乏型研究的未来之争
科技观察者指出研发世界正分叉为Token充裕型与Token匮乏型两条道路,头部AI团队和新型实验室凭借算力优势快速领跑。本文解析这一分化背后的算力竞争逻辑及其对高等教育研究的警示。
Atlas世界模型解析:下一视角预测如何统一生成与重建
Atlas世界模型以"下一视角预测"为核心,统一像素级生成与重建任务,为空间智能建模提供新思路。本文解析这一设计理念的技术意义与潜在价值。
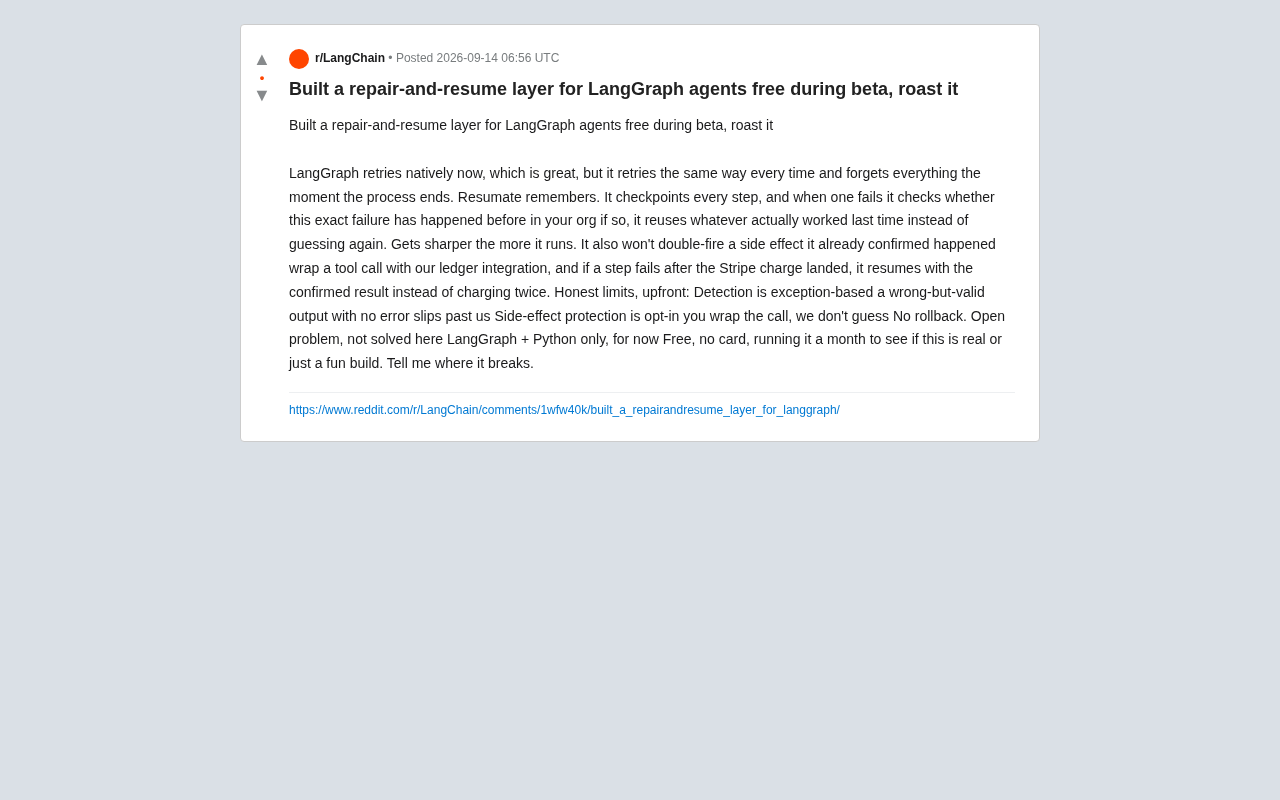
Resumate:为LangGraph智能体打造的修复与续跑层解析
开发者为LangGraph智能体打造修复与续跑层Resumate,通过检查点记忆失败、复用有效方案并防止Stripe扣款等副作用重复触发。本文解析其核心机制、坦诚局限与工程价值。