DRO未必最优?新研究提出MRO与SNR实现Wasserstein鲁棒回归的极小极大后悔率

论文揭示DRO在高维下后悔次优,提出MRO与SNR达极小极大最优率。
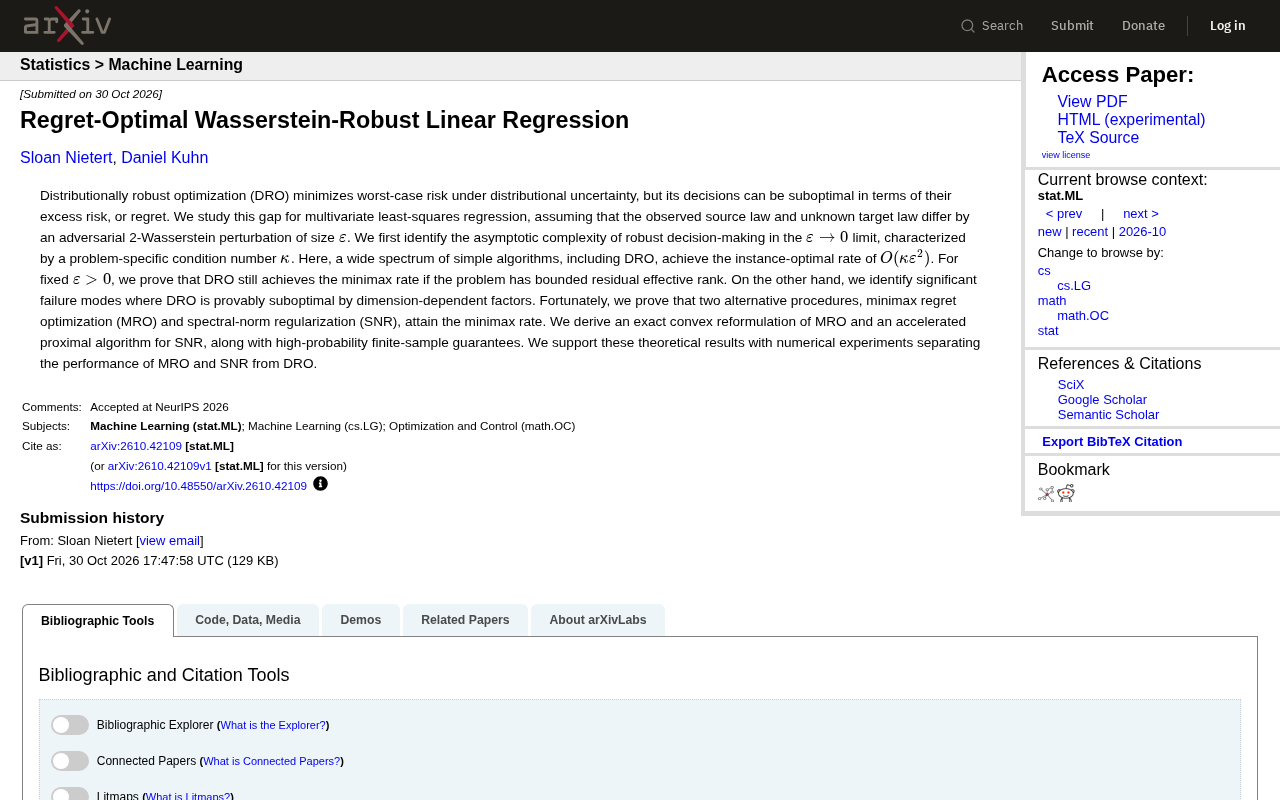
本文围绕《Regret-Optimal Wasserstein-Robust Linear Regression》一文,探讨分布鲁棒优化(DRO)在多元最小二乘回归中的次优性问题。文章首先回顾了以Wasserstein距离构造模糊集的DRO框架,指出在扰动ε→0的渐近极限下,DRO及多种简单算法均可达到依赖条件数κ的实例最优率O(κε²)。然而对于固定ε>0,当残差有效秩无界或维度较高时,DRO会以维度相关因子次优,构成显著失效模式。为此作者提出两种替代方案:极小极大后悔优化(MRO)直接最小化最坏情况后悔并具有精确凸重构;谱范数正则化(SNR)通过谱范数惩罚控制鲁棒性并配备加速近端算法。两者均被证明达到极小极大最优率并提供高概率有限样本保证,数值实验验证了其相对DRO的优势。
分布鲁棒优化(DRO)通过在分布不确定性下最小化最坏情况风险来提升模型鲁棒性,但决策的“后悔”(regret)——即超额风险——可能并非最优。最近一篇论文《Regret-Optimal Wasserstein-Robust Linear Regression》深入研究了多元最小二乘回归中DRO的次优性问题,并提出了两种替代方案:极小极大后悔优化(MRO)和谱范数正则化(SNR),它们能在更广泛条件下达到极小极大最优率。
问题背景:当鲁棒性遭遇后悔
在分布鲁棒优化中,我们假设真实分布与观测分布之间存在对抗性扰动,通常用Wasserstein距离度量。具体到线性回归,假设源分布与目标分布之间的2-Wasserstein扰动大小为ε,DRO最小化最坏情况下的均方误差。然而,这种保守策略可能以牺牲平均性能为代价,导致相对于已知真实分布时的最优线性预测器产生显著的后悔。
论文首先分析了ε→0的渐近极限,识别出决定鲁棒决策复杂度的条件数κ。有趣的是,在这个极限下,包括DRO在内的多种简单算法都能达到实例最优率O(κε²)。这意味着当扰动很小时,DRO的后悔是可控的。
Wasserstein距离是定义在概率分布空间上的度量,衡量将一个分布“搬运”成另一个分布所需的最小代价。给定两个分布 μ 和 ν,其 p-Wasserstein 距离定义为 (W_p(\mu,\nu) = \inf_{\gamma\in\Gamma(\mu,\nu)} (\mathbb{E}_{(x,y)\sim\gamma}[|x-y|^p])^{1/p}),其中 (\Gamma(\mu,\nu)) 是所有以 μ 和 ν 为边缘分布的联合分布的集合。在 DRO 中,Wasserstein 距离用于构造以经验分布为中心、半径为 ε 的“模糊集”,即所有与经验分布距离不超过 ε 的分布。与 KL 散度等度量相比,Wasserstein 距离能够感知底层空间的几何结构,因此对支撑集扰动更敏感,特别适合处理数据分布偏移问题。p=2 时对应平方欧氏代价,在最小二乘回归中自然出现。
实例最优率(instance-optimal rate)指算法在每一个具体问题实例上的收敛速率,而非仅在最坏情况下的统一次优率。相比之下,极小极大率(minimax rate)刻画的是算法在所有问题实例上的最坏情况最优性。实例最优率通常依赖于问题本身的局部几何性质——例如条件数 κ、残差有效秩等——因而能给出更精细的性能刻画。在本文中,ε→0 时 DRO 达到的 O(κε²) 正是一个实例最优率:它随着条件数 κ 的增大而变差,反映了问题病态程度对估计难度的直接影响。区分实例最优与极小极大最优是理解 DRO 何时“足够好”、何时“次优”的关键。
DRO的失效模式与替代方案
对于固定的ε>0,论文证明:如果问题具有有界残差有效秩,DRO仍能达到极小极大率。但在某些情况下,DRO被证明会以维度相关的因子次优——这是DRO的显著失效模式。
为克服这一局限,作者提出两种替代流程:
- 极小极大后悔优化(MRO):直接最小化最坏情况下的后悔,而非风险。论文推导出MRO的精确凸重构,使其可高效求解。
- 谱范数正则化(SNR):通过对回归系数施加谱范数惩罚来控制鲁棒性,并设计了加速近端算法。
这两种方法均能达到极小极大率,且作者提供了高概率有限样本保证。数值实验进一步分离了MRO、SNR与DRO的性能差异,验证了理论发现。
有效秩(effective rank)是矩阵秩的一种连续化度量,用于刻画矩阵谱的“集中程度”。对于半正定矩阵 (\Sigma),其有效秩定义为 (\mathrm{erank}(\Sigma) = \mathrm{tr}(\Sigma)/|\Sigma|_{\mathrm{op}}),即迹与谱范数之比,取值介于 1 和维度 d 之间。当特征值均匀分布时有效秩接近 d,当少数特征值主导时有效秩远小于 d。在本文的回归设定中,“残差有效秩”指残差协方差矩阵的有效秩。DRO 的次优性恰好出现在残差有效秩无界或随维度增长的情形:此时 DRO 的误差界中会出现维度相关因子,导致其相对于极小极大最优率产生不可忽视的后悔。这一概念解释了为何高维或重尾残差场景下 DRO 表现不佳。
谱范数正则化(spectral norm regularization)是指对回归系数矩阵(多元情形下 (W\in\mathbb{R}^{d\times k}))的谱范数 (|W|{\mathrm{op}})(最大奇异值)施加惩罚。与 Frobenius 范数惩罚不同,谱范数惩罚直接控制映射在所有方向上的最大拉伸,因而与最坏情况风险的控制天然契合。在本文中,SNR 通过对 (|W|{\mathrm{op}}) 加罚来间接限制模型对分布扰动的敏感度,其理论优势在于该惩罚的对偶结构与 Wasserstein 扰动的对偶形式相匹配。加速近端算法(如基于 Nesterov 加速的近端梯度法)之所以适用,是因为谱范数的近端算子可通过奇异值阈值(soft-thresholding)闭式求解,每次迭代仅需一次 SVD,从而在大规模问题上保持可扩展性。
对鲁棒机器学习实践的启示
这项研究提醒我们,DRO并非在所有场景下都是后悔最优的。当残差有效秩无界或维度较高时,DRO可能显著次优。实践者若关心相对于真实分布最优解的后悔,应考虑MRO或SNR作为替代。MRO的凸重构使其易于集成到现有优化框架,而SNR的加速近端算法则适合大规模问题。
论文的有限样本保证也为实际应用提供了可靠性依据。未来,这种后悔视角可能扩展到其他鲁棒学习问题,推动更精细的鲁棒性-性能权衡。
关键要点
- DRO在ε→0时可达实例最优率,但固定ε下可能因维度因子次优。
- MRO和SNR被证明能达到极小极大率,且提供有限样本保证。
- MRO有精确凸重构,SNR有加速近端算法,均具实用价值。
- 数值实验验证了理论结果,分离了不同方法的性能。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。