软件定制团队该不该All in大模型?ChatGPT自己给出了答案

大模型并非万能,应根据场景理性选择技术方案
通过采访ChatGPT本身,探讨哪些场景适合接入大模型。结论是:逻辑固定的场景用传统方案更优;大模型适合需要语义理解和复杂决策的行业;工业场景中大模型只能做分析辅助不能替代实时控制;Token成本虽在下降但总支出可能上升。核心原则是技术服务于业务,避免为了AI而AI。
引言:一场与AI的坦诚对话
当所有人都在讨论"All in大模型"的时候,一位软件定制团队的开发者做了一件有趣的事——直接采访ChatGPT本身,让大模型来回答"是否所有场景都该接入大模型"这个问题。
答案出乎意料地理性:别为了AI而AI。
这场对话涵盖了场景选择、成本分析、行业适配等多个维度,对于ToB开发者和软件定制团队来说,具有很强的参考价值。以下是这场对话中提炼出的核心观点与深度分析。
固定逻辑场景:大模型并非最优解
对话中首先探讨的核心问题是:处理逻辑固定、数据格式确定的场景,是否需要接入大模型?
ChatGPT给出了明确的回答——不需要。如果处理逻辑和数据格式都很固定,传统的规则驱动或脚本系统往往更高效、更可控。在这些固定流程下,应该优先保留现有方案。
理解这一观点,需要先了解大模型的本质局限。大模型(LLM,Large Language Model)基于Transformer架构,通过对海量语料的统计学习来预测下一个最可能出现的Token。这种概率预测机制使它天然擅长处理语义模糊、答案开放的问题,但也意味着它的输出本质上是"最可能正确"而非"一定正确"。对于逻辑确定的任务,这种概率性反而是缺陷——你无法像调用一个函数那样保证它每次都返回完全一致的结果,这在工业级系统中是不可接受的风险。
以一个典型的本地化应用场景为例:利用OCR脚本进行屏幕监控,读取识别数据后判断数值是否达到阈值,再触发语音提示或发送提示信息。这类场景的判断逻辑和触发条件都比较简单,本地化脚本程序完全够用。
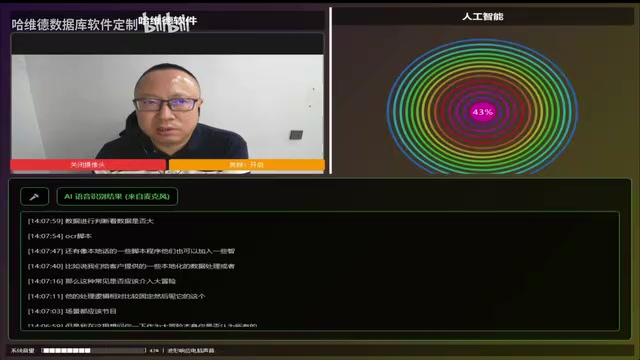
这个观点揭示了一个被很多团队忽视的事实:技术选型的核心不是"新不新",而是"合不合适"。 大模型的优势在于处理模糊性、复杂性和开放性问题,而对于确定性强的任务,传统方案在效率、成本和可控性上都更胜一筹。
个人场景与小型业务:本地化代码更务实
对话进一步聚焦到个人工作场景:逻辑固定、数据格式确定的情况下,该选大模型还是本地代码?
ChatGPT的建议依然是本地化代码。理由很直接:
- 成本更低:无需支付API调用费用
- 逻辑更简单:不需要处理prompt工程、上下文管理等额外复杂度
- 可控性更强:输出结果确定,不存在"幻觉"风险
值得一提的是"幻觉"(Hallucination)问题——这是大模型领域的专业术语,指模型生成看似合理但实际错误的内容。由于大模型是基于概率的文本预测系统而非真正的逻辑推理引擎,当遇到训练数据覆盖不足的问题时,它倾向于"编造"一个听起来合理的答案,而不是承认不知道。对于需要精确输出的业务场景,这种特性是致命的。而Prompt工程(Prompt Engineering)——即精心设计输入提示词以引导模型输出——本身就需要额外的技术积累和持续调试成本,进一步抬高了引入大模型的门槛。

大模型在个人场景下往往带来不必要的复杂度和额外成本。这一点对于很多正在考虑"要不要给产品加个AI功能"的小型团队来说尤为重要——不是每个功能都需要AI加持,用户要的是问题被解决,而不是解决方案有多酷。
哪些行业真正需要接入大模型?
当然,大模型并非没有用武之地。ChatGPT指出了几个真正需要大模型能力的行业方向。
适合大模型的行业特征
- 金融行业:需要大量数据支撑的风险评估和动态决策
- 医疗健康:复杂的诊断辅助和模式识别
- 制造业:异常检测和数据分析(注意:不是实时控制)
- 供应链管理:复杂条件判断和动态优化
这些行业的共同特点是:决策需要大量数据支撑、动态的模式识别以及复杂的条件判断。大模型在这些场景中能够大幅提升效率和决策精准度。更准确地说,这些场景的核心特征是存在大量非结构化信息需要理解——医疗病历中的自然语言描述、金融报告中的语义分析、供应链中的多变量动态博弈。这正是大模型基于海量语料训练所形成的跨领域知识图谱能够发挥价值的地方。
关键区分:分析辅助 vs 实时控制
对话中特别讨论了生产型企业的场景。在与PLC配合进行生产流程管理时,大模型可以作为辅助工具——帮助分析复杂数据、生成报告、识别异常模式,但绝不能直接替代PLC的实时控制。

这里有必要解释PLC(Programmable Logic Controller,可编程逻辑控制器)在工业自动化中的核心地位。PLC是专为工业环境设计的嵌入式计算机,采用确定性操作系统(RTOS),能够以毫秒甚至微秒级的响应时间执行控制指令,并在极端温度、振动、电磁干扰等恶劣环境下稳定运行。其设计哲学的核心是"确定性"——相同输入必须产生相同输出,且在规定时间窗口内必须完成响应。相比之下,大模型的API调用通常需要数百毫秒到数秒的延迟,且响应时间受网络、服务器负载等多重因素影响而不稳定。在生产线上,哪怕一次响应超时都可能导致设备损坏或安全事故,这是架构设计上的根本性冲突。因此,大模型在工业场景的正确定位是离线分析层:处理历史数据、生成优化建议、辅助人工决策,而执行层的实时控制权必须保留在PLC手中。
核心的实时控制仍然需要依赖专门的工业自动化系统。这个区分非常重要:大模型擅长的是"思考",而不是"执行"。在工业场景中,毫秒级的响应延迟都可能造成严重后果,这不是大模型能承担的责任。
Token成本趋势:单价降但总支出升
对话中还涉及了一个开发者非常关心的话题——Token成本走势。
ChatGPT引用了行业趋势数据:经济级模型的Token成本每年大约减少一半,领先级模型也会逐步下降。这是一个好消息。

要理解这一趋势的实际意义,需要先了解Token的计量方式。Token是大模型处理和计费的基本单位,大约对应0.75个英文单词或0.5个中文字符。每次API调用的费用由输入Token(你发送的内容,包括系统提示词、历史对话、用户输入)和输出Token(模型生成的内容)两部分构成。一个包含详细背景说明的业务系统Prompt,光系统提示词部分就可能消耗数千Token,加上多轮对话的上下文积累,单次调用成本会显著高于简单问答场景。从行业数据看,GPT-4级别模型的API价格自2023年以来确实经历了大幅下降,这主要得益于推理效率优化、硬件成本下降以及市场竞争加剧。
但这里有一个容易被忽略的陷阱:虽然单位成本下降,但整体消耗会因为使用量的增长而上升。 随着大模型在更多环节被调用,每次交互消耗的Token量也在增加(更长的上下文、更复杂的prompt),企业的总体AI支出可能不降反升。
这意味着企业需要更精细化地管理Token消耗:
- 精准界定哪些环节真正需要大模型介入
- 优化prompt设计,减少不必要的Token浪费
- 建立监控机制,追踪每个业务模块的Token消耗
- 采用混合架构,简单任务用规则引擎,复杂任务才调用大模型
给ToB开发者的实操决策框架
综合这场对话的核心观点,可以为软件定制团队总结出一套清晰的技术选型决策框架。
优先选择本地化方案的场景
- 处理逻辑固定、数据格式确定
- 本地化数据处理、局域网内操作
- 模拟人工操作的自动化脚本
- 与PLC等硬件配合的实时控制
- 个人或小型团队的轻量级需求
考虑接入大模型的场景
- 需要自然语言理解和生成
- 涉及复杂模式识别和动态决策
- 数据分析和报告生成
- 非结构化数据处理
- 需要持续学习和适应的业务逻辑
在实际操作中,混合架构(Hybrid Architecture)正在成为ToB领域的主流实践:用规则引擎、状态机或传统算法处理确定性强的业务流程,仅在需要语义理解、内容生成或复杂推理的节点调用大模型API。这种架构不仅能大幅降低Token消耗,还能通过缩小大模型的决策边界来降低幻觉风险,同时保留了系统的整体可预测性。
核心原则:技术服务于业务,而不是业务迁就技术。 在大模型热潮中保持冷静,根据实际场景做出理性选择,才是对客户和团队真正负责的态度。
结语
这场对话最有价值的地方在于——连大模型自己都在说"不要盲目使用大模型"。这不是谦虚,而是技术理性。对于ToB软件定制团队来说,真正的竞争力不在于用了多少AI,而在于能否为客户选择最合适的技术方案。在"All in大模型"的喧嚣中,保持清醒的判断力,或许才是最稀缺的能力。
核心要点
- 逻辑固定、数据格式确定的场景不需要大模型,传统规则驱动和本地脚本更高效可控
- 大模型适合金融、医疗、制造业等需要复杂判断和动态模式识别的行业,但不能替代PLC等实时控制系统
- Token单位成本预计每年减半,但企业总体AI支出可能因使用量增长而上升
- 工业场景中大模型定位是分析辅助而非实时控制,核心控制仍需专业工业系统
- ToB开发者应根据场景特征理性选择技术方案,避免为了AI而AI
相关推荐
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta旗下个人AI智能体Muse上线仅六天下载量突破90万,连续登顶美国App Store与Google Play双榜,超越ChatGPT、Claude等明星产品。本文深度解析Muse的核心能力、入口优势与AI Agent赛道的竞争格局。
 行业洞察
纳德拉提出Loopcraft框架:用反馈循环构建AI生态系统
微软CEO纳德拉发表Loopcraft(循环工艺)文章,提出通过技术、商业、生态三重反馈循环构建前沿AI生态系统的方法论,解析微软AI战略布局及对行业的深层启示。
 行业洞察
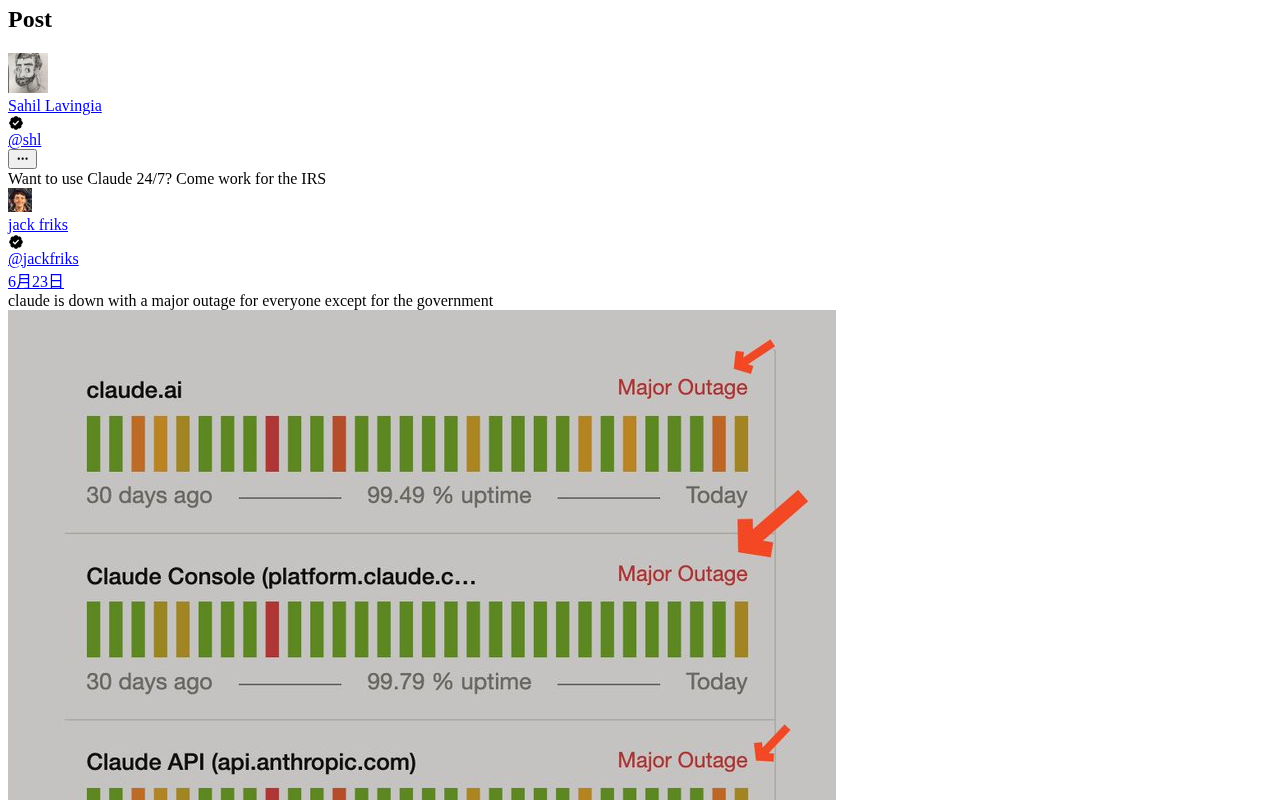
美国国税局IRS全面引入Claude AI,联邦政府AI化进程加速
美国国税局IRS正在招募可全天候使用Claude AI的员工,标志着Anthropic成功打入联邦政府核心部门。本文分析IRS引入AI的战略意义、税务场景应用前景及对行业的深远影响。