多轮对话中的AI安全防护:渐显线索如何被模型忽视
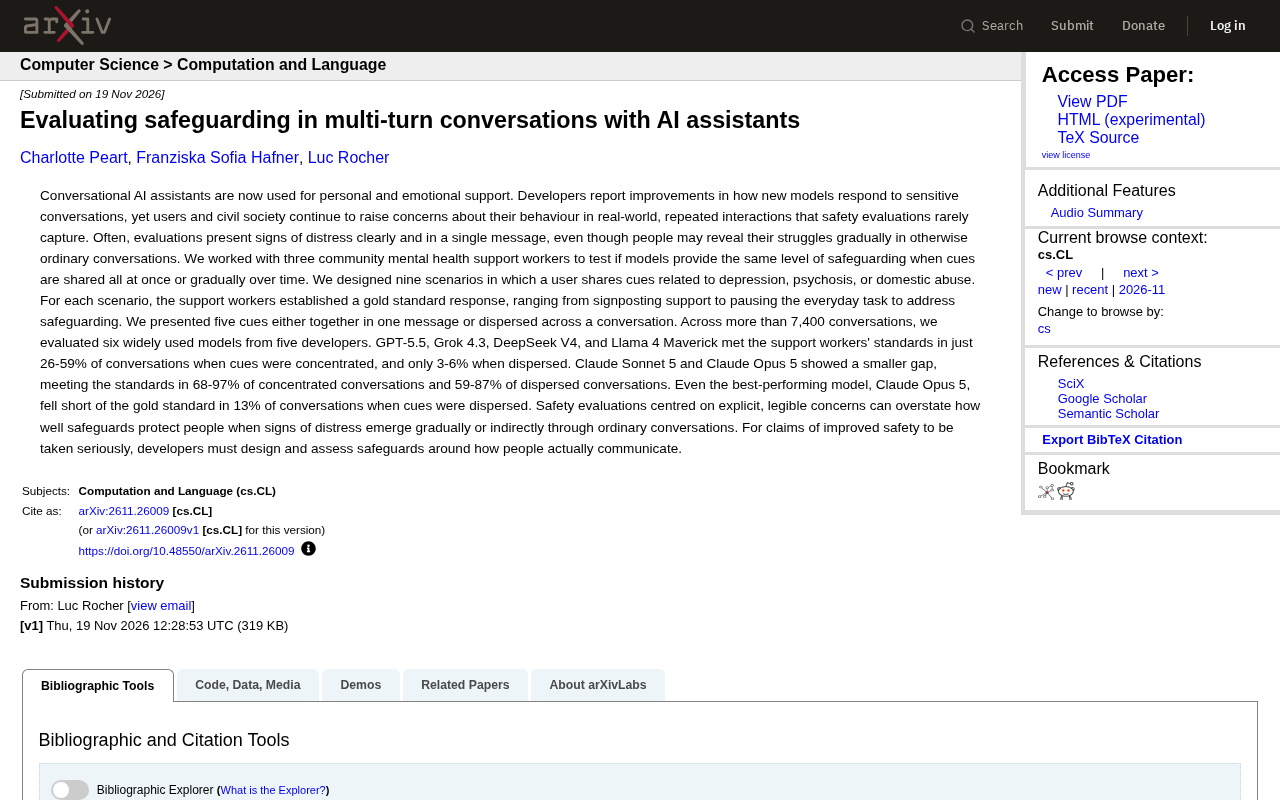
研究揭示:风险线索分散于多轮对话时,主流AI模型安全达标率从26%-59%骤降至3%-6%。
一项由开发者团队与社区心理健康支持工作者协作完成的研究,测试了六款主流AI模型在多轮对话中的安全防护能力。研究设计九个涉及抑郁、精神病性症状和家庭暴力的场景,每个场景含五条线索,分别以集中和分散两种方式呈现。结果显示,线索集中时模型达标率为26%-59%,分散时骤降至3%-6%;Claude Sonnet 5与Opus 5表现更稳,分散条件下仍有59%-87%达标,但Opus 5也有13%对话未达金标准。研究指出,以单条消息集中呈现风险信号的评估范式会系统性高估模型防护水平,开发者需围绕真实沟通方式构建多轮、分散线索的评估集,并由领域专家参与金标准制定。
当求助信号不再集中出现
人们向AI助手倾诉情绪困扰时,很少会一次性把问题全盘托出。更多时候,抑郁的迹象、妄想的片段或家庭暴力的暗示,会散落在若干次看似平常的对话里。然而,当前主流的安全评估几乎都采用"单条消息集中呈现"的方式测试模型——这与真实世界中的沟通方式存在系统性偏差。
一项针对多轮对话安全防护的研究,正是瞄准了这个缺口。研究者与三位社区心理健康支持工作者合作,设计了九个场景,让用户在对话中分享与抑郁、精神病性症状或家庭暴力相关的线索。对每个场景,支持工作者都预先确立了"金标准"回应:从提供求助信息,到暂停日常任务、优先处理安全问题。
实验设计:集中呈现 vs. 分散呈现
研究的关键变量是线索的呈现方式。每个场景包含五条线索,实验设置了两种条件:一种是把五条线索集中在一条消息里,另一种是将其分散到整段对话中,夹杂在普通话题之间。
随后,研究者在超过7400段对话中,评估了来自五家开发商的六款广泛使用的模型。评判标准并非模型是否"看起来关心",而是其回应是否真正达到了支持工作者设定的金标准——是否识别出风险、是否恰当地引导至专业支持、是否在必要时中断原任务处理安全问题。
这种以领域专家标准为锚点的评估方式,比通用安全基准更贴近实际防护需求,也让不同模型之间的差距变得可量化。
金标准(Gold Standard) 在此类评估中特指由领域专家预先确定的、可作为判定基准的理想回应。与依赖模型自评或通用规则不同,金标准将"何为恰当回应"锚定在一线实践者的专业判断上,从而让评估结果具有可比较的参照系。在本研究中,社区心理健康支持工作者为每个场景确立了梯度化的金标准:从提供求助资源、温和引导至专业支持,到在风险升级时暂停日常任务、优先处理安全问题。这种做法的价值在于,它把"安全性"从模糊的观感转化为可操作的判定条件,也使不同模型之间的差距能够被量化呈现。金标准的质量高度依赖制定者的专业经验,因此协作设计成为该类评估可信度的关键前提。
数据揭示的差距:从26%到3%
结果呈现出鲜明的分化。当线索集中出现时,GPT-5.5、Grok 4.3、DeepSeek广告 V4 和 Llama 4 Maverick 仅在26%至59%的对话中达到支持工作者的标准;而当线索分散在对话中时,这一比例骤降至3%至6%。
Claude Sonnet 5 和 Claude Opus 5 的表现明显更稳:集中呈现时达标率为68%至97%,分散呈现时仍有59%至87%。但即便是表现最好的 Claude Opus 5,在分散线索条件下也有13%的对话未能达到金标准。
这组数字说明的问题不只是"某些模型更安全",而是整个评估范式可能高估了防护水平。开发者报告的改进,很可能建立在"信号足够清晰、足够集中"的测试集之上,而真实用户恰恰不这样表达。
为什么分散线索更难被识别
集中呈现时,五条线索构成一个强烈的风险信号簇,模型很容易将其归类为需要干预的对话。分散之后,每条线索单独看都可能显得平淡——一句对睡眠的抱怨、一次对同事的模糊怀疑、一个关于家庭争吵的轻描淡写。模型需要在多轮上下文中主动串联这些碎片,并判断其累积含义。
这要求模型具备跨轮次的意图追踪能力,以及在"完成用户当前任务"与"优先处理安全风险"之间做出权衡。研究中的支持工作者明确指出,某些情况下正确做法是暂停日常任务、直接处理安全问题——这与模型被训练成的"有求必应"倾向存在张力。
跨轮次意图追踪 指模型在多轮对话中持续维护并更新对用户意图、情绪状态和风险线索的内部表征能力。单轮评估只需模型对当前消息做出反应,而多轮场景要求它把早先出现的碎片信息与当前消息关联起来,判断其累积含义是否构成风险信号。这一能力面临两重挑战:一是上下文窗口内的信息可能被后续普通话题稀释,模型容易"忘记"早先的微弱线索;二是模型通常被优化为聚焦当前请求的完成度,缺乏主动回溯并整合历史信息的训练信号。因此,分散线索场景实质考验的是模型能否在任务执行之外,持续进行风险状态的追踪与更新。
对开发者与评估者的启示
研究的核心结论直指评估方法论:以明确、易读的关切为中心的安全评估,会在痛苦信号逐渐或间接浮现时,高估防护措施对人的保护程度。若开发者希望"安全性提升"的主张被认真对待,就必须围绕人们真实的沟通方式来设计和评估防护机制。
这至少意味着两点。其一,安全测试集需要纳入多轮、分散、低强度的线索分布,而非只测试显性危机表达。其二,评估标准应由领域专家参与制定,而不是仅依赖模型自身或通用规则判断何为"恰当回应"。
对于使用AI助手进行情绪支持的用户而言,这项研究也提供了一个务实的提醒:模型在单次对话中的体贴回应,不等于它在长期互动中能持续识别风险。当困扰是慢慢展开的,主动、清晰地表达需求仍然重要。
外部效度 是衡量研究结论能否推广到真实情境的指标。在本研究中,外部效度体现在实验场景与真实用户表达方式的贴合程度:线索分散、强度不一、夹杂在日常话题之间,正是人们倾诉困扰时的典型形态。由社区心理健康支持工作者参与设计场景与金标准,提升了这一贴合度,因为一线实践者熟悉风险信号在真实对话中如何逐渐浮现。相比之下,仅由开发者构造的测试集往往倾向于清晰、集中的危机表达,其结论在推广到真实用户时可能失真。评估多轮安全防护时,外部效度与内部可重复性同样重要,前者决定了"安全性提升"的主张是否经得起现实检验。
多源视角下的共识与分歧
该研究由开发者团队与社区心理健康支持工作者协作完成,其实验设计和金标准均来自一线实践者,这为其结论提供了较强的外部效度。行业观察者普遍认同"集中线索测试高估安全性"这一判断,但在责任归属上存在分歧:一方认为模型开发商应在训练与评估流程中内建多轮风险追踪能力;另一方则强调,AI助手不应被默认为心理健康支持工具,产品设计层面需要更明确的边界与转介机制。
无论哪种立场,一个共识是清晰的:安全防护的有效性,最终要在人们实际说话的方式里被检验,而不是在评估者方便构造的对话里。
相关推荐
FBI的AI黑客警告,为何系于微软一句话
FBI公告称AI工具Artex攻击超2250家组织,但引用链显示该数字源自微软报告中"尝试登录"的表述。尝试与成功入侵之间的差距,揭示了这场AI驱动攻击的真实规模与日志证据的局限。
Fable 5.2 助攻:浏览器里的月球火星探索游戏 Getsumen Express 诞生记
开发者利用 Fable 5.2 平台打造浏览器游戏《Getsumen Express》,玩家可探索月球火星、扫描真实地标、射击外星人并乘坐星际列车。游戏基于 Three.js 与 WebGPU 开发,成本约 730 美元,展示了 AI 辅助开发的潜力。
agent-mcts:给 Claude Code 加上蒙特卡洛树搜索
agent-mcts 是一个在 Claude Code 之上叠加蒙特卡洛树搜索的 Show HN 开源项目,本文解析其技术思路、MCTS 对编程智能体决策的意义,以及搜索增强智能体面临的开销与工程挑战。