多模态错误检测:1.5B语言模型如何揪出胸片报告中的不一致
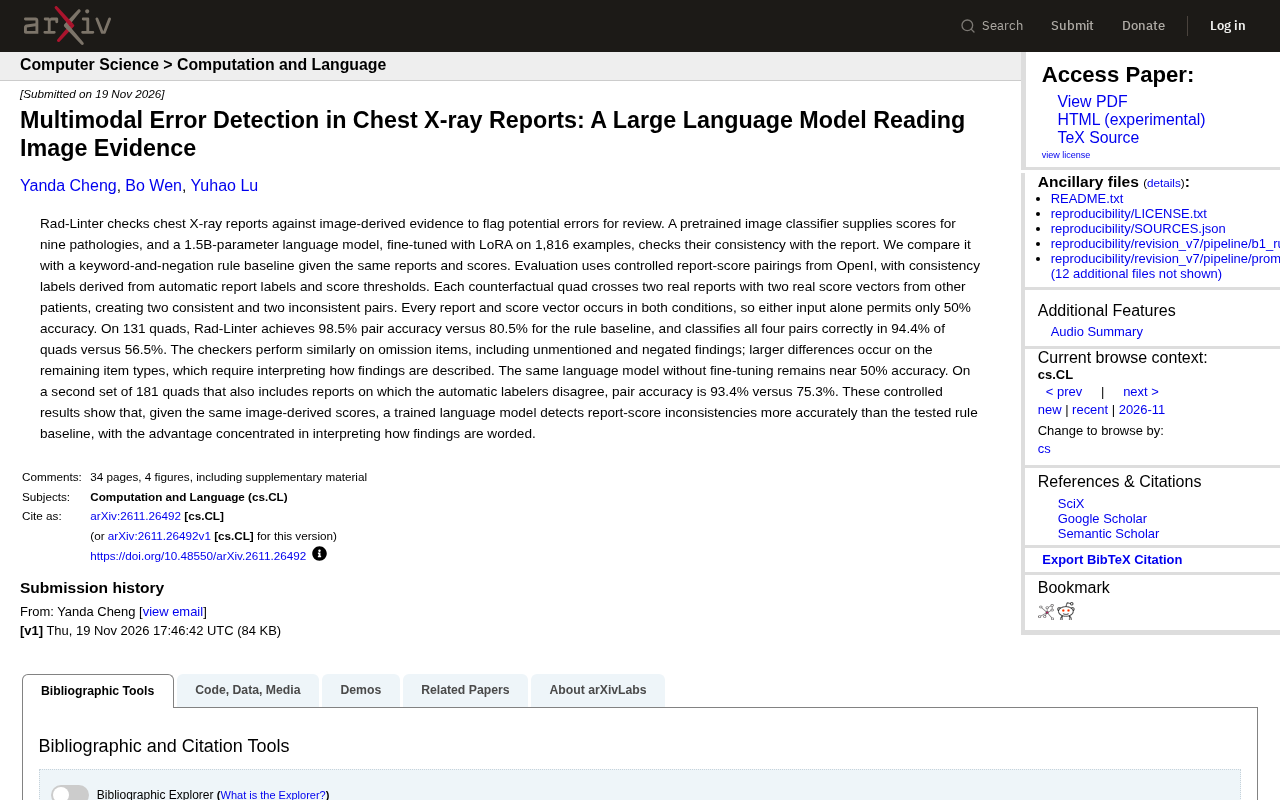
Rad-Linter用分类器分数与微调语言模型交叉验证胸片报告一致性,准确率98.5%远超规则基线。
一项新研究提出 Rad-Linter,利用预训练图像分类器为胸片输出九种病理的置信分数,并用 1.5B 参数的语言模型(经 LoRA 微调)判断报告文字与分数向量是否自洽。研究采用反事实四元组进行受控评估,迫使模型必须联合理解两种模态。在 131 个四元组上,Rad-Linter 配对准确率达 98.5%,规则基线为 80.5%;严格标准下正确率 94.4% 对 56.5%。优势集中在需要理解报告措辞的项目,而非简单遗漏或否定检测。未微调的同一模型准确率仅约 50%,说明监督微调是关键。研究指出图像分类器误差会传导,自动标注不一致时准确率下降,定位为预筛工具而非替代医生。
医学影像报告中的错误可能直接影响患者安全。一项新研究提出 Rad-Linter,利用预训练图像分类器与微调语言模型,交叉验证胸片报告与图像证据的一致性,并以受控实验证明其检测能力显著优于传统规则方法。
问题背景:报告与图像可能“各说各话”
放射科医生撰写的胸片报告,需要与图像本身显示的病理表现保持一致。然而,报告中的文字描述可能与图像证据存在微妙的不一致——例如,报告遗漏了图像中清晰可见的发现,或者用否定、模糊的措辞掩盖了实际的异常。这类错误难以通过简单的关键词匹配发现。
研究团队构建了一个“报告-证据”配对检查框架:先由预训练图像分类器给出九种病理的置信分数,再由语言模型判断报告文字与这些分数是否自洽。
方法核心:分类器打分 + 语言模型找矛盾
Rad-Linter 的流程分为两步:
- 图像侧:一个预训练的图像分类器为每张胸片输出九种病理的分数,作为图像层面的“证据”。
- 文本侧:一个仅有 1.5B 参数的语言模型,在 1,816 个样本上用 LoRA 进行微调,学习判断报告与分数向量之间的逻辑一致性。
为了凸显语言模型的贡献,研究还设置了对照基线:基于关键词与否定规则的检查器,使用完全相同的报告和分数。
受控评估怎么做到“关键信息在交叉中”
研究采用 OpenI 数据集构建了反事实四元组(counterfactual quad)。每一组包含两份真实报告和两个来自其他患者的真实分数向量,交叉配对后产生两对一致、两对不一致的组合。关键在于,每份报告和每个分数向量都在一致与不一致条件中各出现一次——这意味着,仅凭报告文字或仅凭分数,准确率上限只有 50%。这迫使模型必须真正联合理解两种模态才能做出判断。
LoRA(Low-Rank Adaptation) 是一种参数高效微调技术。它不直接更新预训练语言模型的全部权重,而是在部分层中注入低秩矩阵,仅训练这些新增的小参数。这样可将可训练参数量降低几个数量级,显著减少显存占用和训练成本,同时基本保持全量微调的效果。对于 Rad-Linter 这类仅需判断报告与分数一致性的任务,LoRA 使 1.5B 模型能在 1,816 个样本上快速适配,而无需大规模算力。
反事实四元组(counterfactual quad) 是一种受控评估设计:每组包含两份真实报告和两个来自其他患者的真实分数向量,交叉配对形成两对一致、两对不一致的组合。由于每份报告和每个分数在一致与不一致条件中各出现一次,模型无法仅凭单模态信息(报告文字或分数向量)获得高于 50% 的准确率,必须联合理解两种模态才能正确判断。这种设计有效排除了捷径学习,使评估更具说服力。
结果:98.5% 对 80.5%,优势集中在措辞理解
在 131 个四元组上,Rad-Linter 的配对准确率达到 98.5%,而规则基线为 80.5%。在更严格的“四对全部判断正确”标准下,Rad-Linter 的正确率为 94.4%,规则基线仅为 56.5%。
说个细节,当四元组中包含自动标注器意见不一致的报告时(第二组 181 个四元组),Rad-Linter 的配对准确率为 93.4%,规则基线为 75.3%,优势依然保持。
优势来自哪里?理解“怎么说”而非“有没有”
作者进一步拆解了错误类型。在遗漏类项目(包括未提及的发现和否定表述)上,两种检查器表现相近。真正拉开差距的是其余项目类型——这些项目需要理解发现是如何被描述的,而不仅仅是是否出现某个关键词。这说明语言模型的优势不在于模式匹配,而在于对语言细微含义的把握。
另一个关键对照是:同一个语言模型如果不进行微调,准确率停留在 50% 左右,与随机猜测无异。这意味着模型并非“天生”具备这种判断能力,监督微调是必要的。
局限与启示
这项工作的价值在于提供了高度受控的评估范式:反事实四元组设计排除了单一模态的捷径,使得比较结果更具说服力。不过,研究也指出了局限——图像证据完全依赖于分类器的分数,分类器本身的误差会传导至检查环节;自动标注器不一致的样本中,准确率有所下降,说明真实世界的复杂性仍然构成挑战。
从应用角度看,Rad-Linter 的定位是“预筛”工具:在报告进入复核流程前标记潜在不一致,而非替代放射科医生的最终判断。1.5B 参数的规模也意味着部署成本相对可控,为临床工作流中的自动化质控提供了一种轻量可行的路径。
图像分类器作为证据来源的局限性:Rad-Linter 的图像侧证据完全来自预训练分类器的输出分数。这意味着分类器的敏感度和特异度直接决定了检查的上限。若分类器对某种病理(如气胸、结节)的识别能力不足,或存在系统性偏差,则语言模型再强也无法纠正。此外,分类器输出的九种病理分数是离散的置信度,可能丢失图像中的细微空间信息。未来工作可探索引入多分类器集成或可解释性热图,以提供更丰富、更可靠的图像证据。
相关推荐
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。