多模态人物概念模型:小样本下鲁棒身份识别
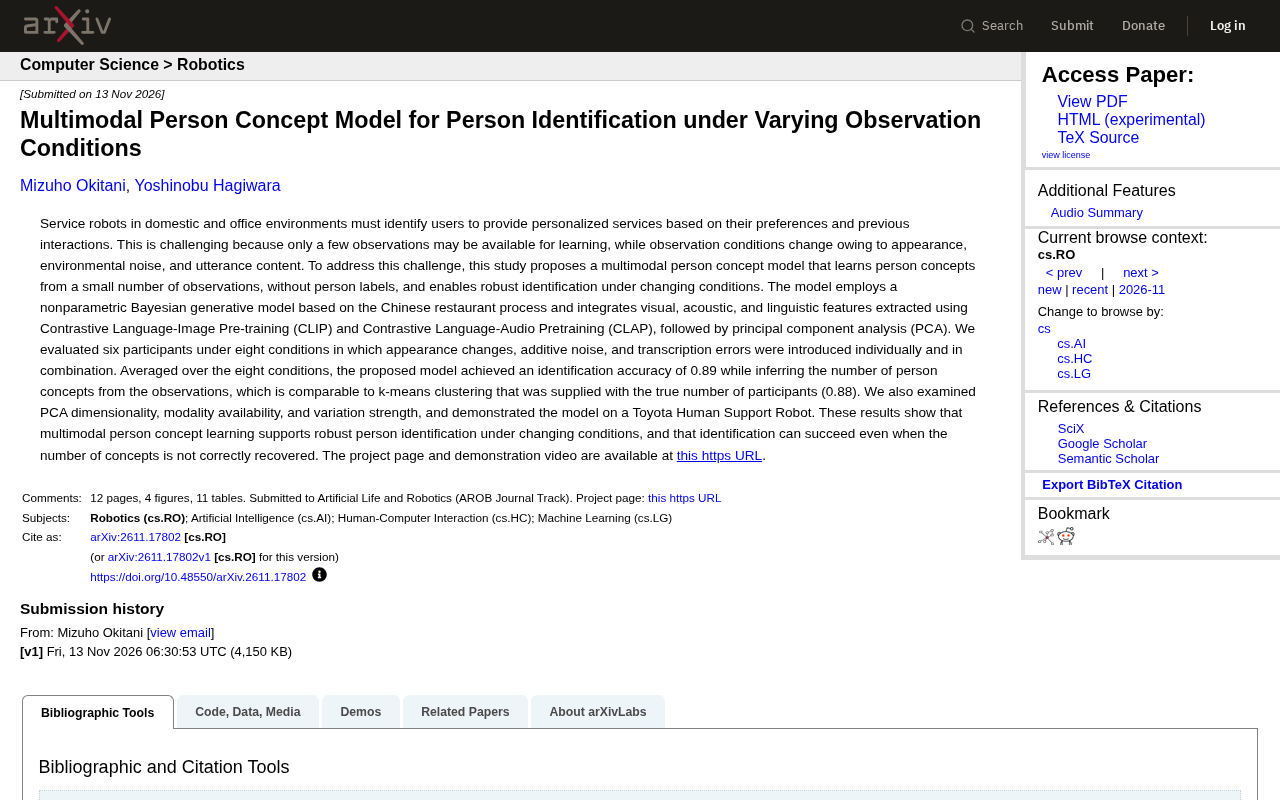
非参数贝叶斯多模态模型从少量无标签观察中学习人物概念,平均识别准确率达0.89。
本研究针对服务机器人在小样本和变化条件下识别用户的需求,提出了一种多模态人物概念模型。该模型基于中餐馆过程的非参数贝叶斯生成框架,融合CLIP视觉特征、CLAP声学特征和语音转写语言特征,无需人物标签即可从少量观察中推断人物概念数量并实现鲁棒识别。在六名参与者、八种变化条件(外观变化、噪声、转写错误及其组合)下的实验表明,平均识别准确率为0.89,与已知参与者数量的k-means聚类(0.88)相当,且对概念数量估计误差不敏感。研究还分析了PCA维度、模态可用性和变化强度的影响,并在丰田Human Support Robot上演示了可行性。多模态互补是鲁棒性的关键,但实验规模较小、依赖预训练特征提取器以及未处理概念漂移等局限仍需未来工作解决。
在家庭或办公环境中,服务机器人需要识别用户以提供个性化服务。然而,机器人往往只能获得少量观察数据,且观察条件会因外观、环境噪声和话语内容而变化。如何从少量无标签观察中学习人物概念并实现鲁棒识别,是一个关键挑战。本研究提出了一种多模态人物概念模型,通过非参数贝叶斯生成模型整合视觉、声学和语言特征,在八种变化条件下平均识别准确率达到0.89,与已知参与者数量的k-means聚类相当。
核心挑战:小样本与变化条件
服务机器人识别用户时面临双重困难:一是学习样本极少,可能只有几次互动记录;二是观察条件动态变化,包括外观改变(如换装)、环境噪声干扰、语音转写错误等。传统方法依赖大量标注数据,难以适应这种场景。本研究的目标是让机器人像人类一样,从少量观察中形成“人物概念”,并在条件变化时保持识别稳定性。
技术方案:非参数贝叶斯+多模态特征
模型采用基于中餐馆过程的非参数贝叶斯生成模型,无需预先指定人物数量,而是从观察中推断概念数量。特征提取方面,视觉特征使用CLIP(对比语言-图像预训练)模型,声学特征使用CLAP(对比语言-音频预训练)模型,语言特征则来自语音转写文本。所有特征经过主成分分析(PCA)降维后融合。这种设计让模型能够同时利用外貌、声音和说话内容等多模态信息,且无需人物标签进行训练。
中餐馆过程(CRP) 是非参数贝叶斯模型中常用的先验,用于描述数据点如何按概率分配到无限多个潜在类别中。在人物概念学习场景中,它允许模型在观察数据逐渐增多时,动态决定是否需要创建新的人物概念(类别),而无需事先指定人数。其核心机制是:每个新观察以一定概率加入已有概念(概率与已有观察数成正比),或以一定概率形成新概念(概率与浓度参数成正比)。这种特性使模型天然适合小样本、类别数未知的开放世界识别任务。
CLIP(Contrastive Language–Image Pre-training) 是OpenAI提出的视觉-语言预训练模型,通过大规模图文对进行对比学习,将图像和文本映射到同一嵌入空间。其图像编码器能提取具有语义意义的视觉特征,对光照、视角和部分外观变化有一定鲁棒性。CLAP(Contrastive Language–Audio Pre-training) 则采用类似思路,将音频与文本描述对齐,提取声学特征。两者均作为冻结的特征提取器使用,无需针对人物识别任务重新训练,这降低了小样本场景下的过拟合风险,但也意味着特征质量受预训练数据分布影响。
实验设置与结果
研究招募了六名参与者,在八种条件下进行评估:外观变化、加性噪声、转写错误,以及它们的组合。平均来看,提出模型的识别准确率为0.89,而使用真实参与者数量的k-means聚类准确率为0.88。说个细节,模型在推断人物概念数量时并不总是完全正确,但识别性能仍保持稳定,说明概念数量估计的误差对识别任务影响有限。实验还分析了PCA维度、模态可用性和变化强度的影响,并在丰田Human Support Robot上进行了演示。
多模态融合的价值与局限
多模态融合是模型鲁棒性的关键。视觉、声学和语言特征互补,当某一模态受干扰时,其他模态可以提供支持。例如,外观变化主要影响视觉特征,但声学和语言特征仍能帮助识别。然而,模型也存在局限:实验规模较小(仅六人),在更大规模人群中的表现有待验证;特征提取依赖预训练模型(CLIP、CLAP),其泛化能力可能影响整体性能;此外,模型未明确处理时间序列上的概念漂移,长期交互中的适应性仍需探索。
概念漂移(Concept Drift) 指数据分布随时间发生变化,导致已学习的概念模型逐渐失效。在长期人机交互中,用户的外观(如发型、服饰)、声学环境甚至说话方式都可能缓慢改变,若模型不能及时更新人物概念,识别性能会下降。本文的静态生成模型未显式建模时间维度,因此概念漂移是实际部署中需要关注的问题。常见应对策略包括滑动窗口重估计、在线变分推断或引入遗忘机制,这些可作为未来扩展方向。
对服务机器人交互的启示
这项研究展示了非参数贝叶斯方法在少样本人物识别中的潜力。机器人无需大量标注数据即可逐步构建人物概念,并根据新观察动态调整。这对于个性化服务至关重要——机器人可以记住用户偏好,并在外观或环境变化时仍能正确识别。未来方向包括扩展到大규模人群、整合更多模态(如深度信息)、以及实现在线学习与概念更新。项目页面和演示视频已公开,为后续研究提供了基础。
相关推荐
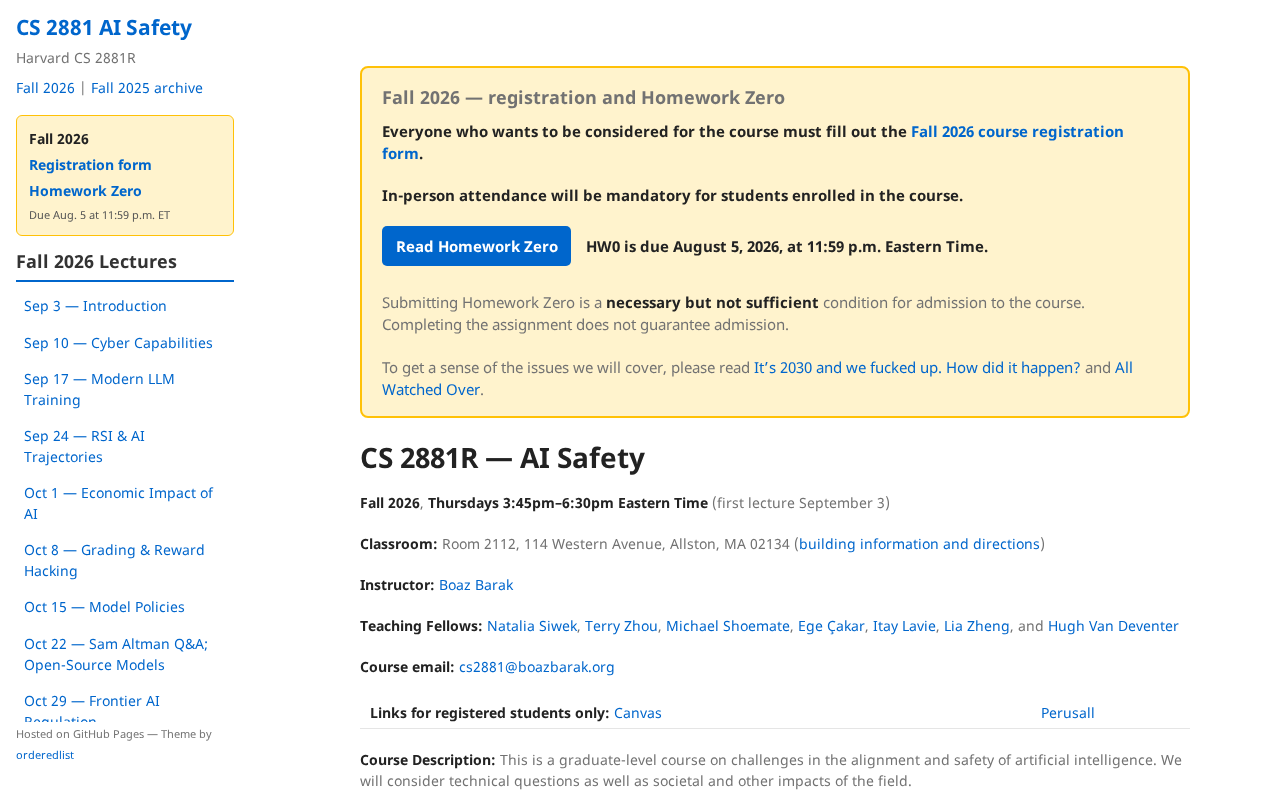
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。