多目标对齐新研究:如何预测目标冲突并覆盖权衡取舍

MODPO通过目标权重旋钮在多个价值目标间灵活平衡,但AI标注数据的系统性偏差会干扰目标冲突预测。
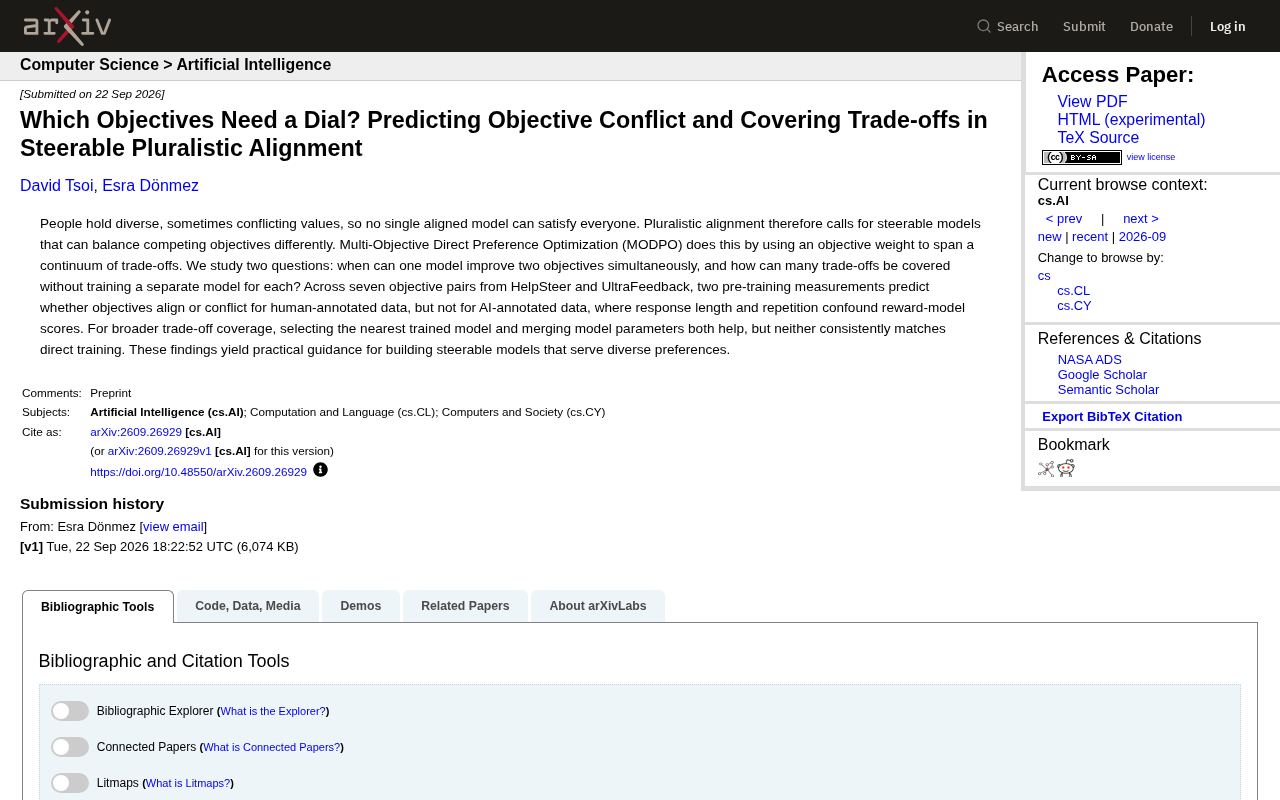
这篇论文研究「可调控的多元对齐」问题:既然人类价值观多元且相互冲突,单一对齐模型无法普适,研究者提出用MODPO(多目标直接偏好优化)在竞争目标间构建连续的权衡谱线,赋予模型可调节的「旋钮」。核心发现有三:一是预训练阶段的两项指标可以预测目标之间是协同还是冲突,但该规律仅对人类标注数据成立,AI标注数据因回复长度与重复度的干扰而失效;二是模型选择与参数合并两种低成本方法可以扩大权衡组合的覆盖范围,但性能上无法持续追平直接针对目标训练的模型;三是RLAIF实践需警惕AI标注数据中的系统性偏差,否则会导致多目标分析结论失真。论文的价值在于提供了务实的实证指导,而非声称给出了完美解决方案。
为什么单一对齐模型无法满足所有人
人们持有多元甚至相互冲突的价值观,这意味着任何一个经过对齐训练的AI模型都不可能让每个人都满意。一个追求「绝对诚实」的用户,与一个更看重「回答友善委婉」的用户,往往对同一条回复有着截然不同的评价标准。这种根本性的分歧,正是当前大模型对齐研究面临的核心难题之一。
这篇来自arXiv的最新研究(arXiv:2609.26929)聚焦于「可调控的多元对齐」(Steerable Pluralistic Alignment),核心思路是:与其训练一个试图取悦所有人的模型,不如构建能够在不同目标之间灵活切换、平衡的模型。用一个形象的比喻,就是给不同的目标装上一个可以调节的「旋钮」(Dial),让模型根据需求在多个价值维度间移动。
MODPO:用权重跨越权衡的连续谱
研究的技术基础是多目标直接偏好优化(Multi-Objective Direct Preference Optimization,简称MODPO)。与传统的单目标DPO不同,MODPO引入了一个「目标权重」参数,通过调节这个权重,模型可以在多个相互竞争的目标之间形成一条连续的权衡谱线。
举例来说,如果一端是「最大化帮助性」,另一端是「最大化安全性」,MODPO允许你在这两端之间选择任意一个平衡点,而不是被迫二选一。这为服务多元用户偏好提供了理论上的灵活性。
两个关键问题
研究者提出并试图回答两个具体问题:
- 何时能同时改进两个目标? 也就是说,两个目标究竟是彼此协同(一荣俱荣)还是彼此冲突(此消彼长)。
- 如何在不为每个权衡点单独训练模型的前提下,覆盖尽可能多的权衡组合? 因为为每一种偏好组合都训练一个专属模型,成本高得难以承受。
直接偏好优化(DPO)是目前主流的大模型对齐方法之一,它通过让模型从人类标注的「偏好对」(即对同一问题的两条回复,一条被标记为更好)中学习,直接优化模型参数,省去了强化学习中显式训练奖励模型的复杂步骤。传统DPO只针对单一目标(如「有用性」)进行优化,无法同时兼顾多个相互竞争的目标。MODPO在此基础上引入目标权重向量,使得同一套训练框架可以通过调整权重在不同目标之间平滑过渡。从几何意义上看,这条「权衡谱线」构成了多目标优化理论中的帕累托前沿(Pareto Frontier)的一个近似——即在不损害其中一个目标的前提下,无法继续提升另一个目标的边界集合。
目标是协同还是冲突?预测方法的发现
研究在 HelpSteer 和 UltraFeedback 两个数据集上,横跨七组目标配对进行了系统实验。一个重要发现是:两个预训练阶段的测量指标,能够预测目标之间是协同还是冲突——但这一结论仅对人类标注的数据成立。
对于AI标注的数据,情况变得复杂。研究指出,回复的长度(response length)和重复度(repetition)会干扰奖励模型的打分,成为混淆因素。换句话说,AI标注的偏好数据中,模型可能因为回复更长或存在重复内容而给出更高分,而非真正基于目标本身的质量。这一发现对当前大量依赖AI反馈(RLAIF)的对齐实践提出了警示:AI标注数据中的系统性偏差,可能让目标冲突的预测失效。
AI反馈强化学习(RLAIF,Reinforcement Learning from AI Feedback)是一种用AI模型(通常是更强大的语言模型)替代人类标注者来生成偏好数据的方法,旨在降低人工标注的高昂成本和规模瓶颈。然而,AI标注者本身带有系统性偏好:研究普遍发现,许多奖励模型对更长的回复给出更高分(即使质量未必更高),对措辞流畅但内容重复的回复也容易打高分。这类「捷径偏差」会导致RLAIF训练的模型学会「写长文」或「重复内容」来刷高奖励,而非真正优化目标本身。本文的发现进一步表明,这种偏差还会破坏目标间冲突关系的可预测性,使得基于AI标注数据的多目标分析结论不可靠。
覆盖更多权衡:模型选择与参数合并
针对「如何覆盖更广泛的权衡组合」这一问题,研究比较了几种方案:
选择最近的已训练模型
第一种思路是,当需要某个特定的权衡点时,直接选用参数上最接近的已训练模型来近似。这种方法有一定效果,能够在一定程度上避免重新训练。
合并模型参数
第二种思路是通过合并(merging)多个已训练模型的参数,来生成新的权衡组合。这同样被证明是有帮助的。
不过,研究给出了一个诚实的结论:无论是选择最近模型还是合并参数,都无法持续稳定地达到直接针对目标训练的效果。也就是说,这些「捷径」可以降低成本、扩大覆盖范围,但在性能上仍然存在与直接训练之间的差距。
模型参数合并(Model Merging)是一种无需重新训练、通过直接对多个模型的权重进行算术运算来生成新模型的技术。最简单的方式是线性插值:对两个在相同基础模型上分别微调得到的模型,按比例对其参数进行加权平均,得到一个「混合」模型。直觉上,如果模型A针对目标X优化、模型B针对目标Y优化,将二者参数以0.5:0.5合并,理论上可以得到一个在两个目标上都有一定表现的中间模型,而无需单独训练一个权重为0.5的MODPO模型。这一方法的吸引力在于极低的计算成本,但其局限性也显而易见:参数空间的线性插值未必对应目标性能的线性插值,模型能力在合并后可能出现非线性损耗。
对构建可调控模型的实践启示
这项研究的价值不在于提出一个完美的解决方案,而在于为构建服务多元偏好的可调控模型提供了务实的指导:
- 在使用预训练指标预测目标冲突时,必须警惕数据来源。人类标注与AI标注的数据可能得出不同的结论,AI标注中的长度和重复偏差尤其需要控制。
- 想要低成本覆盖更多权衡点,模型选择和参数合并是可行的折中方案,但要接受它们与直接训练之间的性能差距。
- 多元对齐的本质,是承认价值观的多样性无法被单一模型消解,需要在工程实现上给予「可调控性」足够的重视。
随着大模型越来越深入地参与人们的决策与表达,如何让AI系统尊重并服务于多元、甚至冲突的价值观,将持续是对齐研究的关键方向。这篇论文以扎实的实证分析,为这一议题添加了值得参考的一块拼图。
相关推荐
Linux 发行版该停止纠结桌面了:底层才是真正价值
一位资深 Linux 创作者认为,多数发行版把精力浪费在桌面美化和品牌差异化上,而内核、驱动、软件仓库等底层才是真正价值所在。本文梳理其核心论点与内在矛盾。
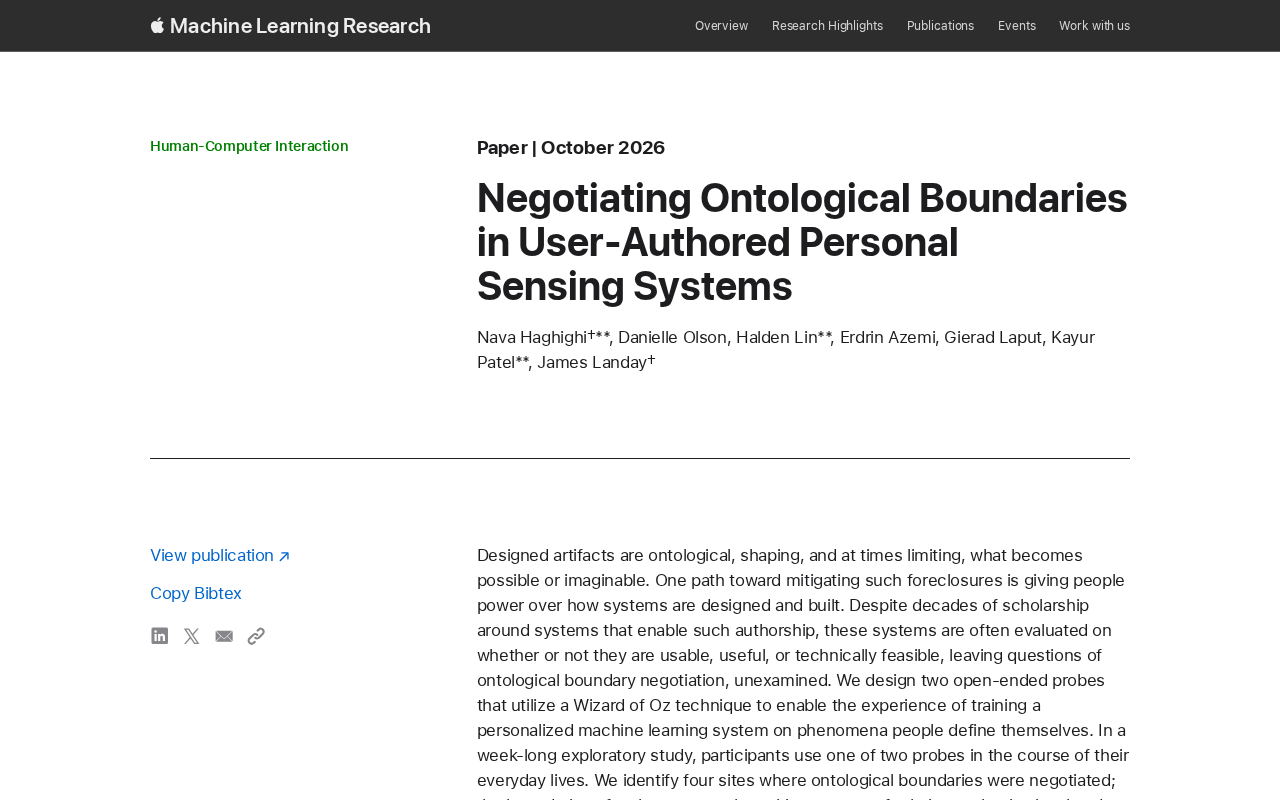
用户自建个人感知系统:谁在定义技术的边界?
一项HCI研究通过绿野仙踪探针,探讨用户自建个人感知系统时如何与技术预设的本体论边界协商,揭示了超越可用性的设计评估新维度。
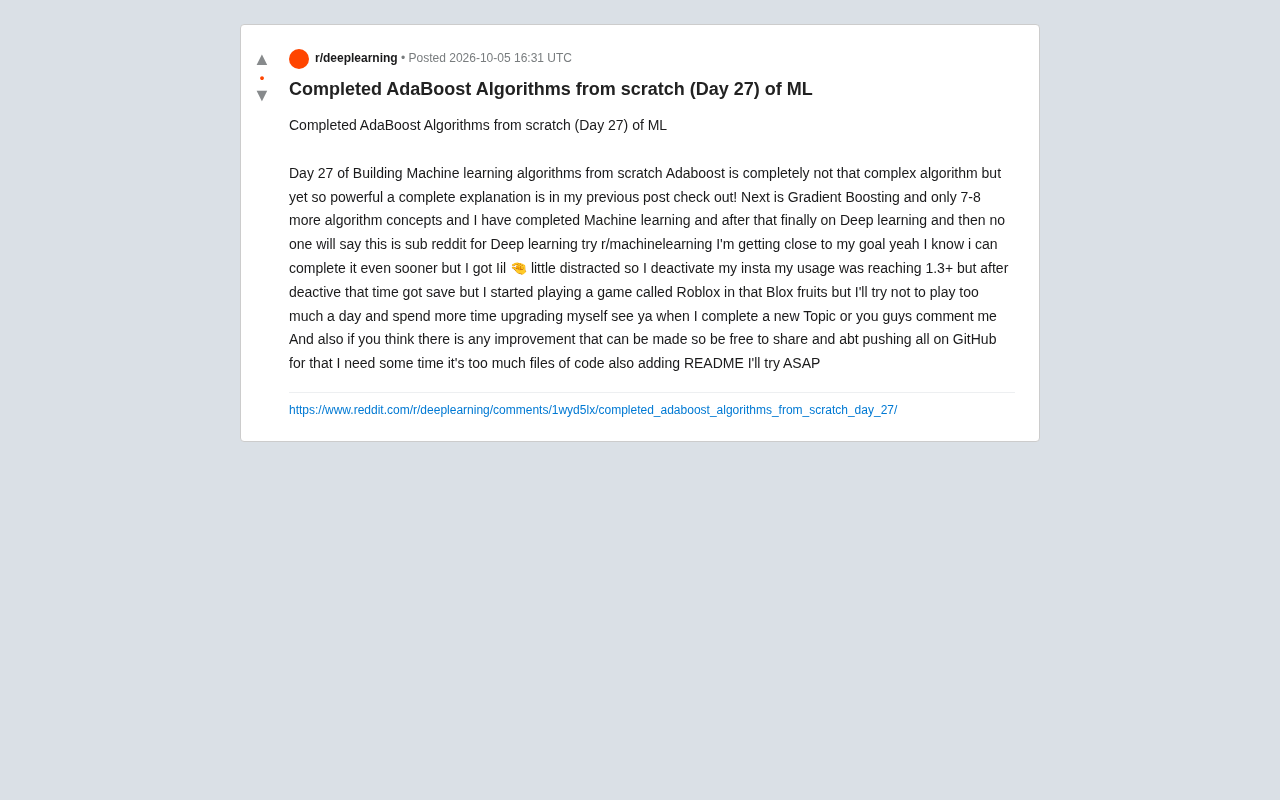
从零实现AdaBoost:机器学习手写算法第27天实录
一位Reddit学习者从零手写实现AdaBoost算法,分享机器学习第27天进度。本文解析AdaBoost核心原理、从零实现的价值,以及从集成学习到深度学习的自学路线规划。