从零实现AdaBoost:机器学习手写算法第27天实录
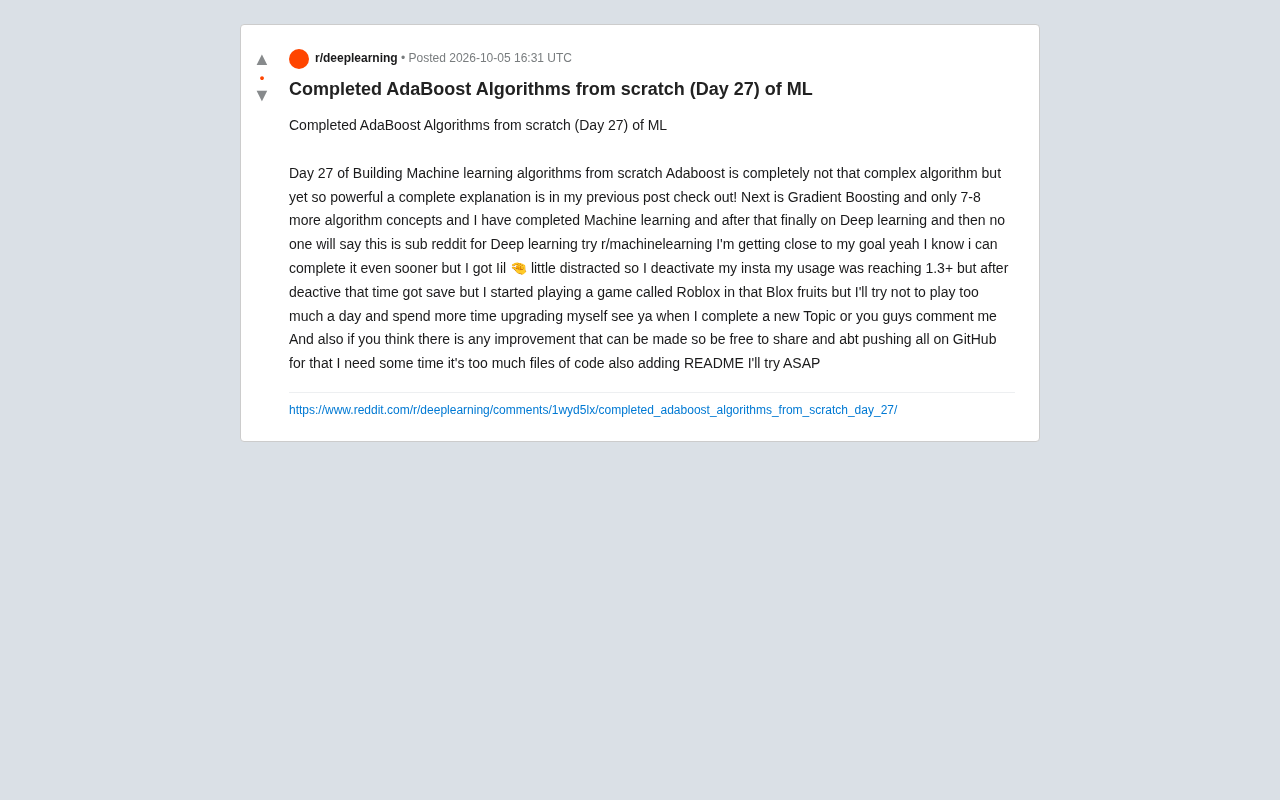
一位学习者用27天手写实现AdaBoost,以坦诚的自律挑战记录诠释ML自学方法论。
一位Reddit用户正在进行「从零构建机器学习算法」的每日打卡,第27天完成了AdaBoost的手写实现。文章以此为切入点,阐述了AdaBoost「串联弱学习器并自适应调整样本权重」的核心机制,指出亲手推导指数损失函数与权重更新公式才是真正理解算法的关键。该学习者还展示了清晰的进阶规划:下一站为Gradient Boosting,再经7-8个算法后转向深度学习。文章同时关注了学习者坦诚分享的自律困境——停用Instagram却转而沉迷游戏——认为这种对自身弱点的坦白比纯粹的技术展示更具参考价值。作者还计划将所有代码开源至GitHub。文章最终提炼出「从零实现、路径规划、坦然面对弱点、开放分享」四条自学方法论,强调真正掌握ML在于写了多少行自己真正理解的代码。
一个坚持手写ML算法的学习者
在各类机器学习教程泛滥的今天,直接调用 scikit-learn 几行代码就能跑通一个模型已成常态。但也有一批学习者选择了一条更艰难的路——从零实现每一个经典算法。一位 Reddit 用户正在进行的「从零构建机器学习算法」系列已经来到了第 27 天,这一天他完成了 AdaBoost 的手写实现。
这种学习方式的价值在于,当你亲手推导损失函数、实现权重更新逻辑时,对算法底层机制的理解会远超单纯调包。AdaBoost 作为集成学习中的经典方法,正是检验这种理解深度的好试金石。
AdaBoost:看似简单却强大
作者在分享中给出了一个颇为中肯的评价:「AdaBoost 其实并不是那么复杂的算法,却又如此强大。」这句话精准概括了 AdaBoost 的特点。
核心思想回顾
AdaBoost(Adaptive Boosting,自适应提升)的核心逻辑并不难理解。它通过串联多个「弱学习器」(通常是深度为 1 的决策树,即决策树桩)来构建一个强分类器。其关键机制在于:
- 每一轮训练后,算法会提高被错误分类样本的权重,降低被正确分类样本的权重;
- 下一个弱学习器会更加「关注」前一轮分错的样本;
- 最终将所有弱学习器按其表现加权组合,得出预测结果。
正是这种「让后续模型纠正前序模型错误」的自适应机制,使得一组表现平平的弱分类器能够组合出强大的整体性能。理解了这一点,手写实现的难点就集中在样本权重更新和学习器权重计算这两处公式上。
在权重更新的数学层面,AdaBoost 的严谨性体现在两个关键公式上。第一个是弱学习器权重(也称「话语权」)的计算:$\alpha_t = \frac{1}{2} \ln\frac{1-\varepsilon_t}{\varepsilon_t}$,其中 $\varepsilon_t$ 是该轮的加权错误率。错误率越低,这个学习器在最终投票中的权重就越大;若错误率接近 0.5(随机猜测水平),权重趋近于 0,意味着该学习器几乎不贡献任何信息。第二个是样本权重更新公式:正确分类的样本权重乘以 $e^{-\alpha_t}$,错误分类的样本权重乘以 $e^{+\alpha_t}$,然后归一化。这两个公式共同来源于对指数损失函数 $L = \sum_i e^{-y_i F(x_i)}$ 的逐步最小化推导,这也是 AdaBoost 与普通加权投票方案的本质区别——它的权重更新策略在数学上是有严格依据的,而非启发式规则。
为什么值得从零实现
AdaBoost 的代码量相对可控,但涉及的数学推导——尤其是指数损失函数与权重更新的关系——是真正考验理解的地方。亲手实现一遍,能帮助学习者彻底弄清「为什么这样更新权重」而非仅仅知道「怎么更新」。
学习路线:距离目标越来越近
作者透露了接下来的学习规划,展现出一条清晰的进阶路径:
- 下一站:Gradient Boosting(梯度提升)
- 机器学习收尾:还剩 7-8 个算法概念即可完成整个 ML 阶段
- 终极目标:转向深度学习(Deep Learning)
从 AdaBoost 到 Gradient Boosting 是一条自然的进阶路线。两者同属 Boosting 家族,但梯度提升用梯度下降的思路来优化损失函数,为后续理解 XGBoost、LightGBM 等工业界主流算法打下基础。这样的学习顺序安排得相当合理。
Gradient Boosting(梯度提升)与 AdaBoost 最根本的区别在于优化框架的泛化程度。AdaBoost 本质上是在指数损失函数下的特例,而 Gradient Boosting 将「训练下一个弱学习器」的过程重新诠释为:拟合当前模型在任意可微损失函数上的负梯度(即「伪残差」)。这一思想由 Friedman 于 2001 年提出,使得同一套框架可以适配分类、回归、排序等不同任务,只需更换损失函数即可。正因为这种通用性,Gradient Boosting 成为后续 XGBoost(2016)、LightGBM(2017)、CatBoost 等工业级框架的理论基石。从 AdaBoost 过渡到 Gradient Boosting 的学习路径,帮助学习者从「一个具体算法」跃升到「一类优化思想」的层次,是集成学习阶段最重要的认知升级之一。
自律与分心:真实的学习者状态
值得一提的是,作者坦诚地分享了学习过程中的真实状态,这比单纯的技术炫耀更具参考价值。他提到为了节省时间停用了 Instagram——此前使用时长一度达到 1.3 小时以上。但省下的时间又部分流向了 Roblox 的「Blox Fruits」游戏,他表示会尽量控制每天的游戏时间,把更多精力放在自我提升上。
这种对自身拖延与分心的坦白,恰恰是长期学习项目中最常见的挑战。坚持 27 天本身就说明了问题——保持连续性远比追求速度更重要。
开放协作的态度
作者还表达了几点开放姿态:
- 欢迎改进建议:主动邀请社区对其实现提出优化意见;
- GitHub 开源计划:由于代码文件数量庞大,加上需要补充 README 文档,完整上传需要一些时间,但他承诺会尽快完成。
这种边学边分享、接受社区反馈的方式,正是开源学习文化的典型体现。对于同样走在 ML 自学路上的人来说,跟随这样一个公开的进度记录,本身就是一种激励。
给自学者的启示
这篇看似简单的进度分享,折射出几个值得借鉴的学习方法论:
- 从零实现而非调包:牺牲效率换取对底层机制的深度理解;
- 规划清晰的进阶路径:从集成学习循序渐进到深度学习;
- 坦然面对自身弱点:主动管理分心源,接受不完美但持续的进度;
- 保持开放与分享:通过公开记录和开源获得反馈与动力。
无论是刚入门还是已有基础的学习者,这种「每日一算法」的实践节奏都提供了一个可参考的范本。真正掌握机器学习,从来不是看了多少教程,而是动手写了多少行自己真正理解的代码。
相关推荐
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
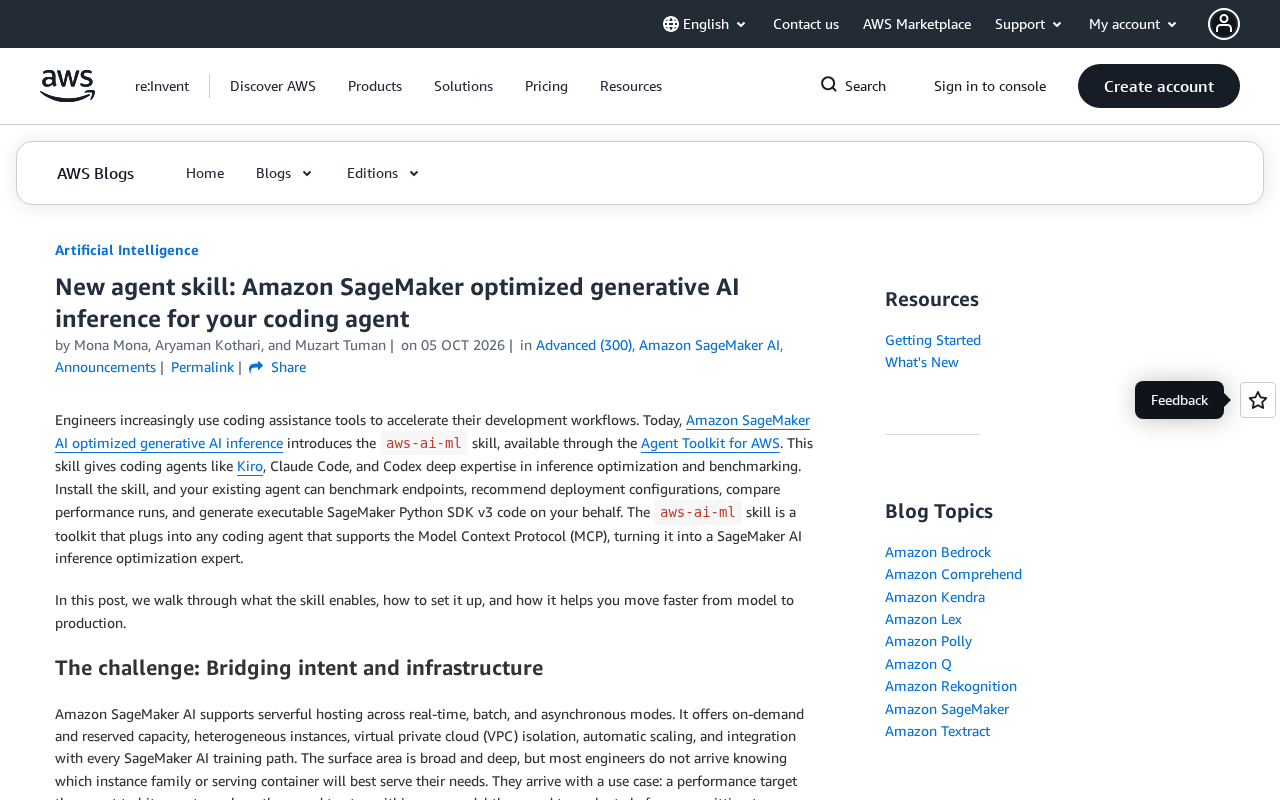
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。
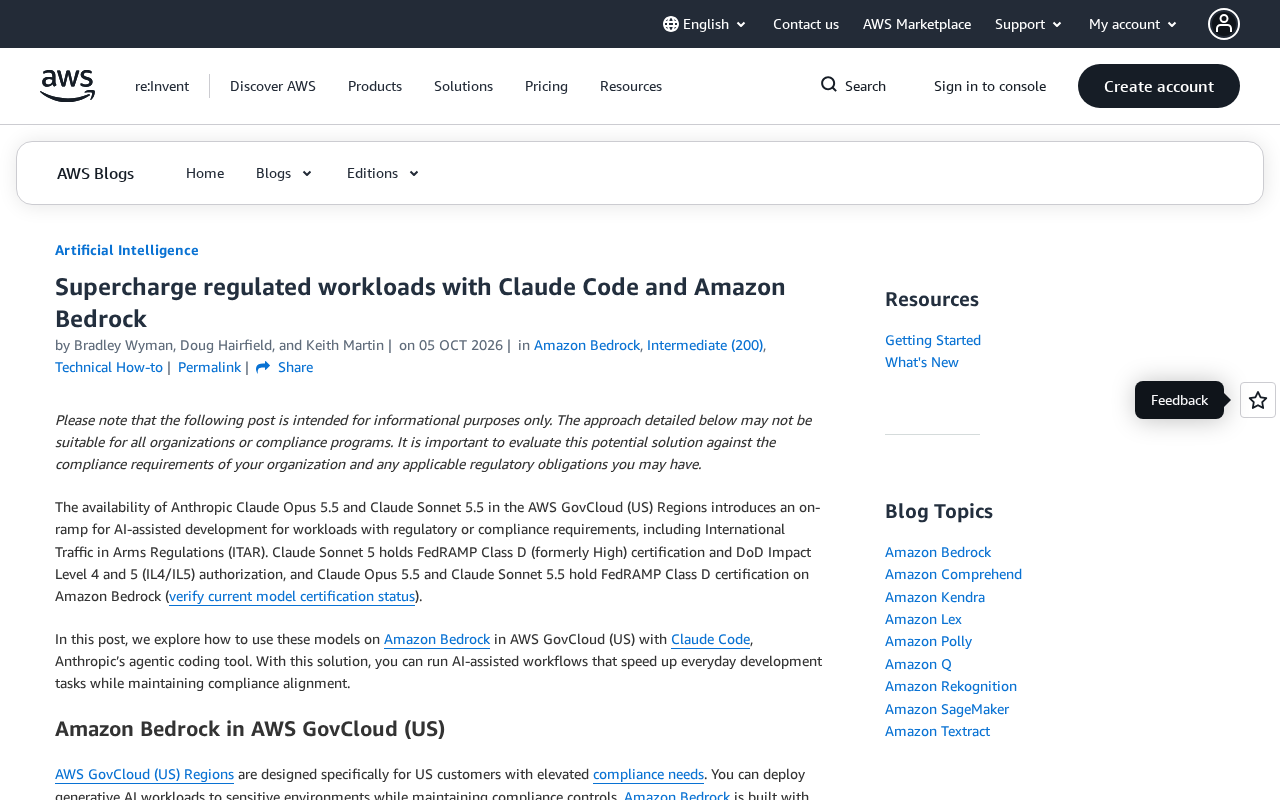
Claude Code 登陆 AWS GovCloud:合规监管工作负载的 AI 编程新选择
Anthropic Claude Opus 5.5 与 Sonnet 5.5 登陆 Amazon Bedrock 的 AWS GovCloud (US) 区域,支持 Claude Code 智能体编程,为 ITAR 等受监管工作负载提供合规对齐的 AI 辅助开发能力。