多智能体辩论真有效吗?小模型实验揭示其本质是集成采样

大规模实验证明多智能体辩论的收益本质是集成采样效应,预算匹配后无法超越自洽采样。
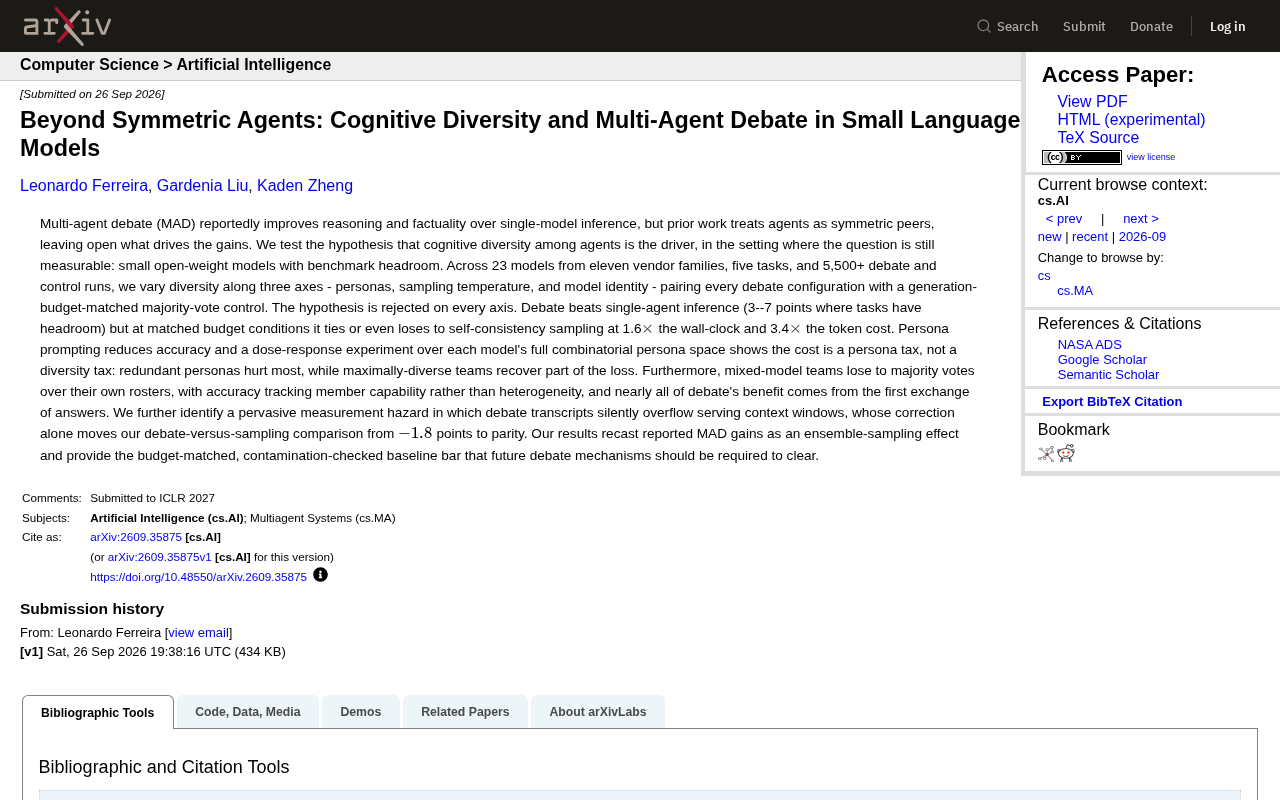
一篇最新 arXiv 论文通过覆盖 23 个模型、5 项任务、逾 5500 次实验的大规模研究,系统性地拆解了多智能体辩论(MAD)的收益来源。研究者在角色设定、采样温度、模型身份三个维度引入认知多样性,并为每种辩论配置设置了生成预算匹配的多数投票对照组。结果显示,辩论在三个维度上均无法超越同等算力下的自洽采样,却要付出 1.6 倍墙钟时间和 3.4 倍 token 成本。角色扮演提示反而以"角色税"的形式拉低准确率,混合模型团队也输给了自身成员的简单多数投票。论文还揭示了上下文窗口溢出这一普遍测量隐患,并据此呼吁未来 MAD 研究必须跨过预算匹配且经过污染检查的基准线,才能真正证明机制的独立价值。
多智能体辩论的效果被高估了?
多智能体辩论(Multi-Agent Debate, MAD)近年来被视为提升大语言模型推理能力与事实准确性的有效手段。核心思路很直观:让多个模型实例像同行专家一样互相质疑、辩论,最终得出比单模型推理更可靠的答案。然而,一篇最新的 arXiv 论文对这一广泛流传的假设提出了尖锐质疑。
研究者指出,此前的工作大多把参与辩论的智能体当作对称的同行(symmetric peers),却没有真正回答一个关键问题:辩论带来的收益究竟来自哪里?是来自智能体之间的"认知多样性"(cognitive diversity),还是仅仅因为投入了更多的计算预算?
大规模实验设计:把认知多样性拆成三个维度
为了在结论仍可度量的场景下验证假设,作者选择了具备基准提升空间的小型开源权重模型作为实验对象——这些模型尚未在测试任务上饱和,因此任何改进都能被清晰观测到。
实验规模相当扎实:
- 覆盖 11 个厂商家族的 23 个模型
- 涉及 5 项任务
- 累计运行 5,500+ 次辩论与对照实验
研究者沿三个维度系统性地引入多样性:角色设定(personas)、采样温度(temperature) 和 模型身份(model identity)。更关键的是,每一种辩论配置都配对了一个生成预算匹配的多数投票对照组(majority-vote control),确保比较是在同等算力下进行的,而不是简单地"多花钱换性能"。
生成预算匹配(generation budget matching) 是本研究方法论的核心控制手段。在多智能体辩论中,N 个模型经过 R 轮交互,总共会生成远超单次推理的 token 量;若直接与单次推理结果相比,任何提升都可能只是"用更多算力换来的"。预算匹配的做法是:统计辩论配置在整个流程中消耗的总 token 数,然后用同等数量的 token 让单一模型进行多次独立采样并投票,以此作为对照。这一设计将"协作机制本身是否有效"与"更多算力是否有效"解耦,是判断多智能体范式是否具备独立价值的必要条件。
核心发现:认知多样性假设被全面否定
结论出人意料——在三个维度上,认知多样性驱动收益的假设全部被拒绝。
辩论确实能击败单智能体推理,在有提升空间的任务上带来 3 到 7 个百分点的提升。但一旦把预算对齐,辩论相对于自洽采样(self-consistency sampling) 只能打平甚至落败,而代价却是 1.6 倍的墙钟时间 和 3.4 倍的 token 成本。
换句话说,辩论看似有效,实际上性价比远不如单纯多次采样再投票。
角色扮演不是多样性红利,而是"角色税"
论文一个颇具洞察力的发现是:给智能体分配不同角色(persona prompting)反而降低了准确率。通过在每个模型完整的角色组合空间上做剂量-反应实验,作者证明这一代价是角色税(persona tax),而非多样性税。
具体表现为:冗余、重复的角色伤害最大,而配置得当、最大化差异的团队能挽回部分损失。这说明问题不在于"让模型扮演不同角色"这一思路本身,而在于强行赋予角色会干扰模型的原生推理能力。
混合模型团队反被自己的多数投票击败
另一组实验同样发人深省:由不同模型组成的混合团队,输给了对同一组模型直接做多数投票的结果。准确率的高低更多取决于成员本身的能力,而非团队的异质性程度。
更有意思的是,辩论的几乎全部收益都来自第一轮答案交换。后续多轮辩论并没有带来实质性提升——这进一步暗示,所谓辩论收益,本质上是一种集成效应,而非真正意义上的"思想碰撞"。
自洽采样(Self-Consistency Sampling) 是由 Wang et al.(2022)提出的一种无需多模型协作的推理增强方法:对同一问题用较高温度多次采样,生成若干条独立的推理链,最终通过多数投票选出答案。其核心优势在于成本可控、延迟低,且只需一个模型实例。自洽采样已被证明在数学推理、常识问答等任务上能稳定提升准确率,因此成为衡量任何多智能体协作方案"是否物有所值"的天然基准。本文正是以此为对照,揭示出辩论框架在相同 token 预算下并不能带来超越自洽采样的额外收益。
一个被忽视的测量陷阱:上下文窗口溢出
除了推翻假设,论文还揪出了一个普遍存在的测量隐患:辩论过程中的对话记录会悄无声息地溢出服务端的上下文窗口。
这个技术细节看似微不足道,却直接影响了实验结论的可信度。作者发现,仅仅修正这一溢出问题,就能把辩论对采样的比较结果从 -1.8 分 拉回到持平。这提醒所有做相关实验的研究者:不控制上下文窗口的溢出,很可能得出带有偏差的结论。
上下文窗口溢出在多轮多智能体场景中尤为隐蔽:随着辩论轮次增加,历史对话的 token 累积量很容易超出模型服务端设定的最大上下文长度,此时不同平台的处理策略各异——有的静默截断最早的消息,有的从中间截断,有的直接返回空响应。这些行为通常不会触发显式报错,导致研究者误以为模型"读完了"全部历史信息。截断后智能体实际上是在信息残缺的状态下作答,等效于做了一次带噪声的单次推理,这会系统性地压低辩论条件的准确率,从而人为拉大"辩论 vs. 采样"的负向差距。本文修正该问题后,原本 -1.8 分的劣势消失,再次印证控制实验环境的重要性。
研究意义:为未来的辩论机制立下基准线
这项研究最大的价值,在于重新定义了对已报告 MAD 收益的解读——它把这些收益归因为一种集成采样效应(ensemble-sampling effect),而非认知多样性带来的独特优势。
作者据此提出了一条明确的基准要求:任何未来声称有效的辩论机制,都必须先跨过一条预算匹配、且经过污染检查(contamination-checked) 的基线门槛。也就是说,新方法不能只跟单模型比,而要跟同等算力下的自洽采样比,否则很难证明其真正的价值。
对工程实践者而言,这一结论有直接的成本意义:在预算有限的场景下,与其构建复杂的多智能体辩论框架,不如对单模型做多次采样再投票,既省钱又省时。而对研究者而言,这篇论文提供了一套更严格的评估范式,值得纳入后续 MAD 研究的标准流程。
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。