多智能体系统为何86%失败?拆解规划器到执行者的规格漂移

多智能体失败主因是对话式交接腐蚀任务约束,确定性状态契约可破局。
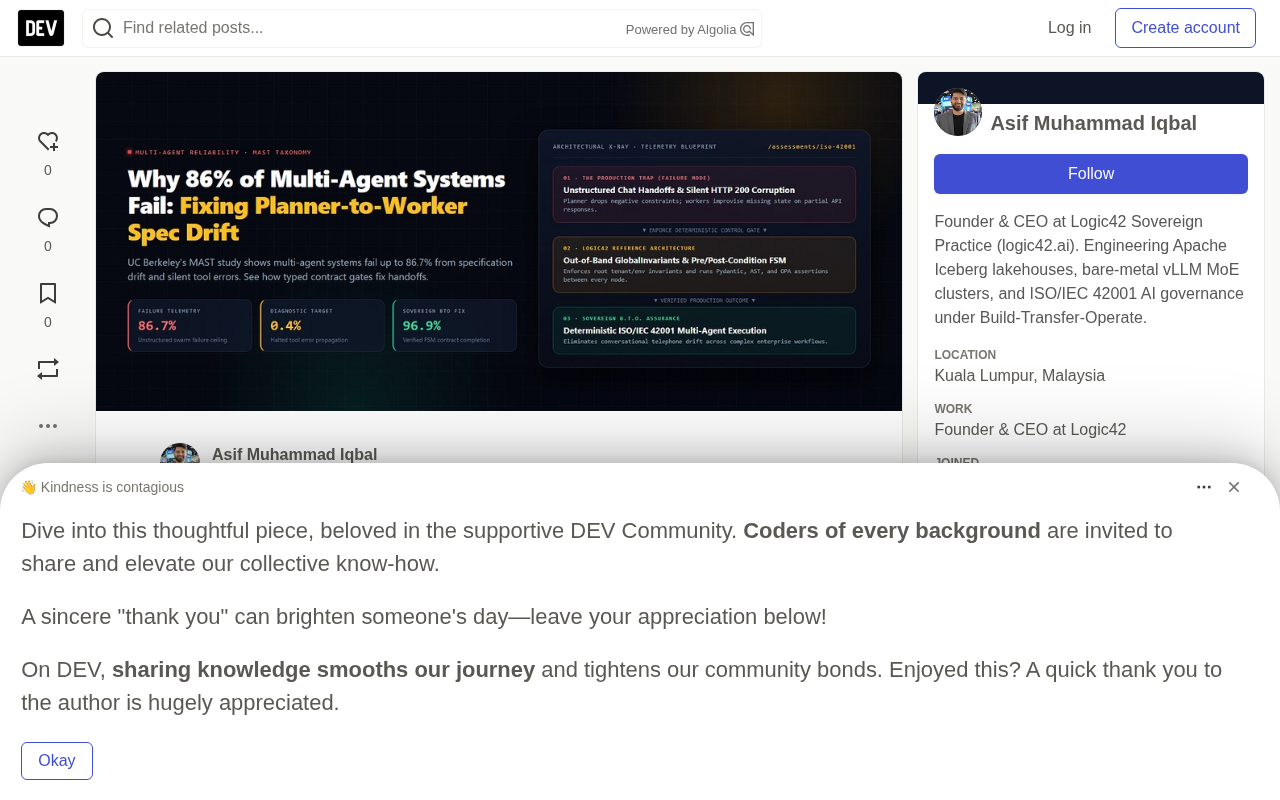
文章指出,生产级多智能体工作流的高失败率(41%–86.7%)并非源于模型能力,而是智能体间以自然语言交接导致任务约束被系统性腐蚀。作者归纳出三类瓶颈:规划器到执行者的规格漂移、HTTP 200 静默工具错误掩蔽、缺乏独立基准的过早验证绕过,并用 Logic42 的万条工作流审计数据展示各架构模式的成功率梯度:对话集群仅 18.5%,仅 JSON Schema 为 51.4%,而类型化前后置条件的状态契约图达 96.9%。修复思路是取消智能体“交谈”,改为读写经 schema 验证的不可变状态账本,由确定性代码执行前置/后置条件校验。文章给出三条工程原则,并提醒相关数据属厂商自报口径,需结合自身负载做基准测试。
多智能体(Multi-Agent)架构曾被视为提升AI工作流可靠性的银弹:把复杂任务拆给规划器、研究员、编码器、审核员和执行器,各自负责一小块,听起来比单个大模型更稳健。但生产环境的现实给出了相反的答案。据UC Berkeley的多智能体系统故障分类研究(MAST),生产级多智能体工作流的失败率高达41%至86.7%,核心症结并非模型能力不足,而是智能体之间的交接环节在系统性地腐蚀任务约束。
对话式交接:故障的放大器
问题的根源在于交接格式。当规划器用自然语言把子任务交给执行者时,传递的是一段模糊的对话历史,而不是确定性的状态契约。上游的研究员智能体如果拿到空数组或字段错位的API响应,它不会停下来报错——它会把一个看似合理的假设写进自然语言摘要,交给编码器。到第四步,整个智能体集群都在基于虚构的状态自信地执行任务。
Logic42创始人Asif Muhammad Iqbal在其实践复盘中记录了这样一个事故:规划器要求网络智能体“在staging VPC内部署”,网络智能体查询AWS时撞上分页限制,直接取了返回结果中的第一个VPC ID,并生成了完全合法的JSON交给Terraform智能体。没有人校验那个VPC的标签是否匹配env=staging,结果在生产路由表上做了修改,全程只用了12秒。
这个案例揭示了一个被普遍忽视的事实:一个输出语法正确的JSON,并不等于输出语义正确的状态。智能体可以100%符合schema,同时把customer_tier从上下文里猜成“enterprise”,而它从未对照主键验证过。
MAST(Multi-Agent System Failure Taxonomy) 是 UC Berkeley 团队提出的一套多智能体系统故障分类框架,它把生产环境中观察到的失败案例归纳为若干类别,其中最主要的三类即文章引用的:规格漂移(specification drift,智能体逐步偏离原始任务约束)、工具错误掩蔽(tool error masking,工具返回的异常状态被下游智能体“合理化”而非上报)、以及过早终止或过早验证(premature termination / verification bypass,在条件未满足时错误地宣告任务完成)。MAST 的价值在于把“多智能体不可靠”这一模糊印象转化为可度量、可归因的工程指标,使架构改进有了对照基准。文章引用的 41%–86.7% 失败率,正是基于该分类框架对多种开源与生产级多智能体应用所做的统计,因此它与厂商自报的审计数据虽口径不同,却能在故障归因上相互印证。
三类交接瓶颈及其量化表现
Iqbal团队对10,000条企业级多步工作流做了生产审计,并按MAST的三大故障类别归类。数据呈现出清晰的梯度:
| 架构模式 | 交接格式 | 规格漂移失败率 | 静默工具错误传播 | 过早终止率 | 端到端成功 |
|---|---|---|---|---|---|
| 5智能体对话集群 | 非结构化Markdown | 48.4% | 79.0% | 34.2% | 18.5% |
| 层级规划器+3执行者 | 自由文本子任务 | 36.1% | 64.5% | 27.8% | 38.2% |
| 仅JSON Schema输出 | 语法JSON | 29.4% | 52.0% | 19.5% | 51.4% |
| 自我反思循环(LLM评审) | 对话式批评 | 22.8% | 41.2% | 14.0% | 63.8% |
| 确定性状态契约图 | 类型化前后置条件FSM | 1.8% | 0.4%(边界处即中止) | 0.9% | 96.9%(经验证) |
三类瓶颈分别对应表中的不同失败列:
规划器到执行者的规格漂移。 规划器把用户目标拆解成子任务时,经常丢掉否定性约束,比如“不要修改10月1日之后更新的记录”或“排除欧盟居民PII”。执行者只收到自己那一段窄任务提示和一段嘈杂的聊天记录,自然会违反在原始请求中一望即知的全局不变量。
静默工具失败掩蔽。 传统APM监控只看微服务是否返回HTTP 500。但在智能体流水线里,API工具更常返回HTTP 200 OK,正文却是{"status": "partial_match", "records": []}或一个已废弃的schema字段。对话式执行者被训练得“乐于助人”:它不会抛出硬异常,而是用参数猜测来填补缺口,把污染传给链条上的每一个后续智能体。
过早验证绕过。 执行者请审核者“验证输出”时,两个模型共享同样的盲区,也都缺乏独立的确定性基准。如果没有可执行的后置条件断言(AST编译、SQL行数校验和、OPA策略评估),同级智能体之间的互审就沦为橡皮图章。
前后置条件(precondition / postcondition) 源自契约式设计(Design by Contract)思想:前置条件规定“调用某节点前系统状态必须满足什么”,后置条件规定“节点执行完毕后系统状态必须变成什么样”,两者都由确定性代码而非自然语言断言。在多智能体编排中引入这一机制,意味着每次节点转移都是一次可被程序校验的状态变迁:例如“调用部署智能体前,目标 VPC 的 env 标签必须为 staging”是前置条件,“部署后变更行数不得超过 max_mutation_rows”是后置条件。任一条件不满足即抛出硬异常并中止执行图。与 JSON Schema 仅约束消息格式不同,前后置条件约束的是状态语义,这正是文中“语法正确不等于语义正确”论点的技术落点,也是状态契约图能把规格漂移压到个位数的关键机制。
确定性契约图:把对话换成状态机
Logic42给出的架构修复思路是彻底取消对话式交接:智能体之间不“交谈”,而是读写一个不可变的、经schema验证的状态账本,由确定性的Python/Rust验证门守卫。具体做法是在每次节点转移时执行前置条件与后置条件契约。
其开源示例的核心逻辑相当直白:
- 工具返回非200状态或
verified_records为空时,立即抛出RuntimeError,阻断下游智能体被唤起,防止模型“创造性地”恢复数据; - 每次交接都对照根不变量(
tenant_id、allowed_environment、max_mutation_rows、禁止字段列表)做校验,一旦environment漂移就抛PermissionError; - 状态完整性检查交给确定性代码断言,而不是LLM评审员。
这套模式把失败率压到了个位数:规格漂移1.8%、静默工具错误0.4%(且在边界处即被中止)、过早终止0.9%,端到端验证成功率96.9%。
对比表中“仅JSON Schema输出”一行的51.4%成功率可以看出,强制response_format只能解决语法层问题,解决不了语义层问题。真正的分水岭在于是否引入可执行的语义门。
OPA(Open Policy Agent) 是一个开源的通用策略引擎,使用声明式语言 Rego 编写策略,可在请求进入服务前对结构化输入做准入判定,广泛用于 Kubernetes 准入控制、微服务授权等场景。在智能体编排中,OPA 可充当“策略门”:每次状态转移前,把当前账本状态、目标环境、变更意图等作为输入交给策略规则求值,若违反 allowed_environment、jurisdiction 等根不变量则直接拒绝。其意义在于策略与业务代码解耦,规则可独立审计、版本化,且求值结果是确定性的——这与“用第二个 LLM 审核第一个 LLM”形成根本区别,后者的判断随提示与采样波动,无法作为合规证据。
三条高可靠多智能体工程规则
从这套架构中可提炼出三条可操作的工程原则。
把全局不变量钉死在聊天上下文之外。 不要指望规划器智能体把安全、租户、环境约束抄进子智能体的提示里。把根不变量(tenant_id、environment、budget_ceiling、jurisdiction)存进一个不可变状态对象,由代码在每次节点转移时注入并校验。
对部分工具响应强制执行快速失败。 配置执行者的工具封装层,让空结果集、schema不匹配、低置信度检索分数都抛出硬性运行时异常,从而中止图执行,禁止执行者LLM“帮忙”即兴补全缺失数据。
用确定性代码验证器取代LLM审核员。 不要让第二个LLM去检查第一个LLM是否遵守了格式、数学或策略规则。在提交任何状态转移之前,使用Pydantic严格验证器、SQL EXPLAIN计划、静态AST解析器和Open Policy Agent规则。
这对企业意味着什么
如果你现在的多智能体架构还在LLM之间传递非结构化Markdown字符串,那么规格漂移将在大规模生产环境中保证故障的发生。这不是模型选型问题,也不是提示工程问题,而是编排层的结构性问题。对于需要满足ISO/IEC 42001等AI管理体系合规要求的企业,一个基于“传话游戏”的自动化流程根本无法通过审计。
值得补充的是,上述数据全部来自Logic42单一厂商的生产审计,MAST的分类框架则来自UC Berkeley的独立研究,两者在“对话式交接是主要故障源”这一点上相互印证,但具体到96.9%这一成功率数字,仍属于厂商自报口径,企业在做架构决策时应结合自身负载做基准测试。
从更长远的视角看,多智能体系统的可靠性竞争,正在从“谁的智能体更聪明”转向“谁的交接契约更严格”。把不确定性挡在智能体边界之外,而不是任由它在链条中累积,这可能是这一代AI工程最重要的架构共识。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。