Eagle-4 发布:推理速度超 DFlash2 与 DSpark,Qwen3.8-27B 实测 3.59 倍加速

Eagle-4 发布,在 Qwen3.8-27B 上实现 3.59 倍推理加速,超越 DFlash2 与 DSpark。
Reddit 社区热帖显示,Eagle-4 正式发布,在 Qwen3.8-27B 模型上实现相对基线 3.59 倍的推理加速,全面领先 DFlash2(2.80×)、DSpark(2.57×)和 MTP(2.22×)。Eagle 系列延续投机解码思路,通过轻量草稿模型生成候选 token 再由目标模型验证,Eagle-4 的加速跃升推测来自草稿接受率或并行验证效率的实质改进,但原帖未披露技术细节。当前局限是仅支持 Qwen3.8-27B 单一模型,尚未集成 llama.cpp 与 vLLM,社区对数据反应积极,后续框架适配进度与模型覆盖范围将决定其能否从纸面成绩转化为生产可用方案。
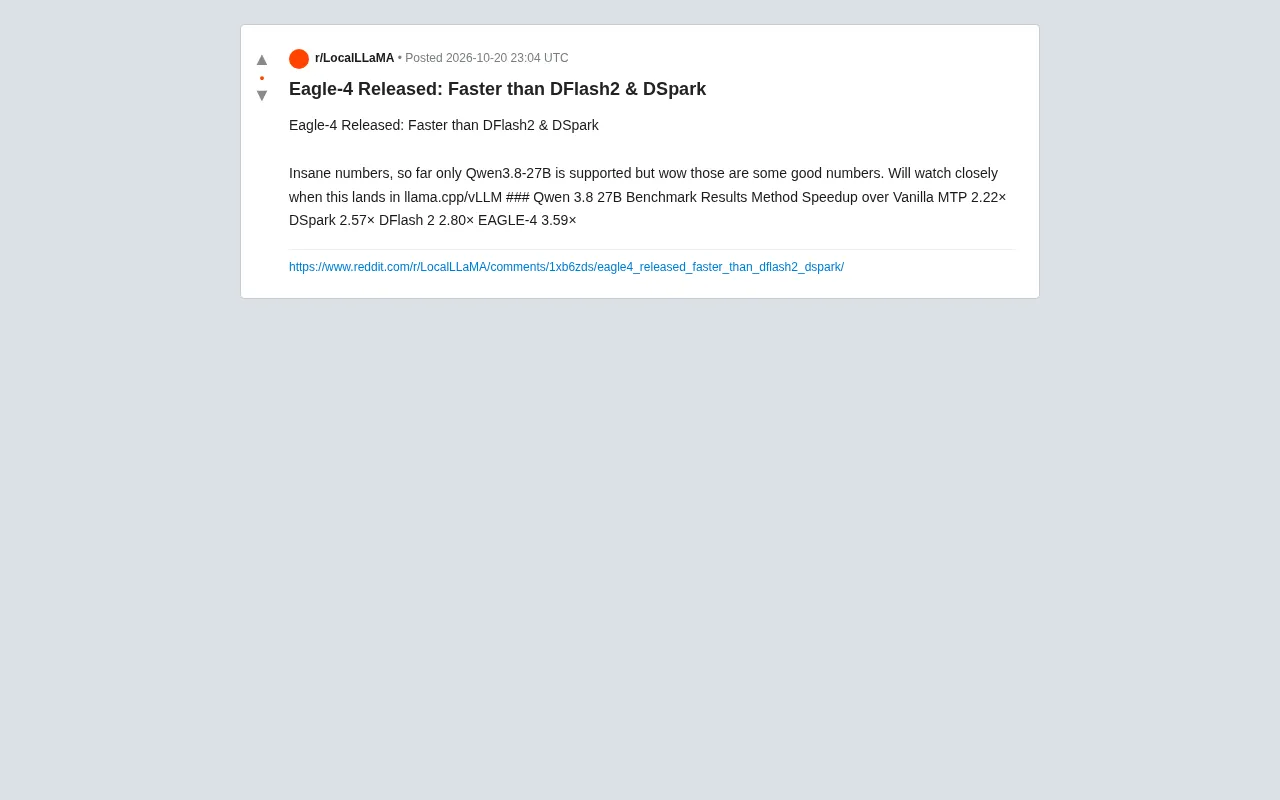
大模型推理加速领域迎来新突破。Reddit 社区一则热帖显示,Eagle-4 正式发布,在 Qwen3.8-27B 模型上实现了对基线方法 3.59 倍的推理加速,显著领先于此前表现不俗的 DFlash2 和 DSpark。尽管目前仅支持单一模型,但这一数字足以让开发者对后续集成充满期待。
性能对比:Eagle-4 全面领先
根据帖子中公布的 benchmark 数据,在 Qwen 3.8 27B 模型上,各方法的加速比如下:
| 方法 | 相对 Vanilla 加速比 |
|---|---|
| MTP | 2.22× |
| DSpark | 2.57× |
| DFlash 2 | 2.80× |
| EAGLE-4 | 3.59× |
Eagle-4 不仅超越了此前备受关注的 DFlash2(2.80×)和 DSpark(2.57×),更是将 MTP 的 2.22× 远远甩在身后。从 2.80× 到 3.59×,看似只是不到一倍的提升,但在推理加速领域,每一步边际增益都意味着大量的工程优化与算法创新。
MTP(Multi-Token Prediction,多 token 预测) 是与投机解码目标相近但实现路径不同的一类加速方案。其做法是在训练阶段为模型增加额外的预测头,使模型在一次前向中同时预测未来多个位置的 token,推理时可把这些预测作为候选一次性提交并校验。MTP 的优势是无需独立的草稿模型、部署链路简单,但由于候选 token 之间缺乏自回归依赖,接受率通常低于专门的投机解码方法,因此在这类对比中加速比往往处于较低水平(此处为 2.22×)。
需要说明的是,表中各方法的加速比均以 Vanilla(原始自回归解码) 为 1× 基准,且高度依赖测试条件——包括 batch size、生成长度、采样温度以及硬件配置。小 batch、长输出、低温采样的场景通常对投机类方法更友好,加速比也更高;而在高并发大 batch 下,GPU 利用率本已饱和,边际收益会明显收窄。因此跨方法比较时应关注是否在同一套评测配置下测得。
技术背景:Eagle 系列的一贯思路
Eagle 系列方法的核心思路是投机解码(speculative decoding)的变体——通过一个轻量级的草稿模型快速生成候选 token,再由目标大模型进行验证,从而在不损失生成质量的前提下提升吞吐。Eagle-4 作为该系列的最新迭代,大概率在草稿模型结构、训练策略或验证机制上做了进一步改进。
虽然原帖未披露具体技术细节,但从加速比的大幅跃升可以推断,Eagle-4 在草稿 token 的接受率或并行验证效率上有了实质性突破。这也解释了为何它能在与 DFlash2、DSpark 等同样基于投机解码思路的方法对比中脱颖而出。
投机解码(Speculative Decoding) 是一种在不改变目标大模型输出分布的前提下加速自回归生成的技术。其基本流程是:用一个参数量远小于目标模型的"草稿模型"(draft model)快速自回归地生成 γ 个候选 token,然后由目标大模型对这 γ 个 token 做一次并行前向验证,接受其中与目标模型分布一致的前缀,并在第一个被拒绝的位置之后由目标模型补出一个正确 token。由于大模型的一次前向可以验证多个 token,生成过程从"每步一个 token"变为"每步平均多个 token",从而实现 2 倍以上的端到端加速。
该方法的加速比取决于两个关键量:草稿 token 的接受率(acceptance rate) 和草稿模型的单步开销。接受率越高、草稿越廉价,加速越明显。Eagle 系列正是围绕提升接受率展开:早期 Eagle 引入特征级草稿(利用目标模型隐层特征而非仅 token 做草稿输入),Eagle-2 进一步引入动态草稿树结构,使一次验证可以覆盖多条候选路径。这也解释了为何该方向的改进往往体现为接受率与并行验证效率的提升。
当前局限:仅支持 Qwen3.8-27B
帖子明确指出,Eagle-4 目前仅支持 Qwen3.8-27B 这一款模型。这意味着其他主流模型(如 Llama 系列、Mistral 系列)的用户暂时还无法直接受益。对于一项刚发布的技术而言,这种单模型支持并不罕见——团队通常需要针对特定模型架构进行适配和调优,才能达到宣称的加速效果。
不过,发帖者本人也表示会密切关注 Eagle-4 落地 llama.cpp 和 vLLM 的进展。这两个推理框架是开源社区使用最广泛的部署方案,一旦 Eagle-4 完成集成,其影响力将迅速从单一模型扩展到更广泛的生态。
llama.cpp 与 vLLM 是目前开源社区两个最重要的推理部署方案,但定位不同:llama.cpp 以 C/C++ 实现,主打 CPU、Apple Silicon 及消费级 GPU 上的量化推理与本地部署,生态覆盖大量模型格式;vLLM 则面向服务端高吞吐场景,核心是 PagedAttention 与连续批处理(continuous batching),是云端批量推理的主流选择。
两者对投机解码的支持方式差异较大:vLLM 已内置多种投机解码后端(如 n-gram、独立草稿模型、EAGLE 风格草稿头),并需要与调度器、KV cache 管理协同;llama.cpp 则通过 draft model 参数或自带的投机采样实现。Eagle-4 若要落地这两个框架,除了模型权重转换,还需实现草稿树的构建与并行验证 kernel,并在连续批处理下正确处理不同序列的接受长度差异——这正是 benchmark 数字难以直接复现的主要工程难点。
社区反应与后续展望
从 Reddit 帖子的措辞来看,社区对 Eagle-4 的数据反应积极——“Insane numbers”的评价透露出对加速幅度的惊讶。考虑到 DFlash2 和 DSpark 此前已在社区积累了一定口碑,Eagle-4 能够实现全面超越,无疑会吸引更多开发者的关注。
接下来的关键节点在于工程落地。benchmark 数字再漂亮,如果无法在 llama.cpp 或 vLLM 中稳定复现,对实际生产环境的帮助就有限。Eagle-4 能否快速完成框架适配、是否会将支持范围扩展到更多模型,将决定它能否从“纸面冠军”变为“实战利器”。
对于关注大模型推理效率的团队来说,Eagle-4 值得加入观察列表。尤其在 Qwen 系列模型上有部署需求的场景,3.59 倍的加速比意味着可观的成本节约和响应速度提升。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。