EDU-Jev:教育决策专用「系统一」模型,单次推理替代生成式评分

EDU-Jev 用单次前向直接输出选项概率分布,替代生成式评分,4B 模型在十二个教育基准上领先。
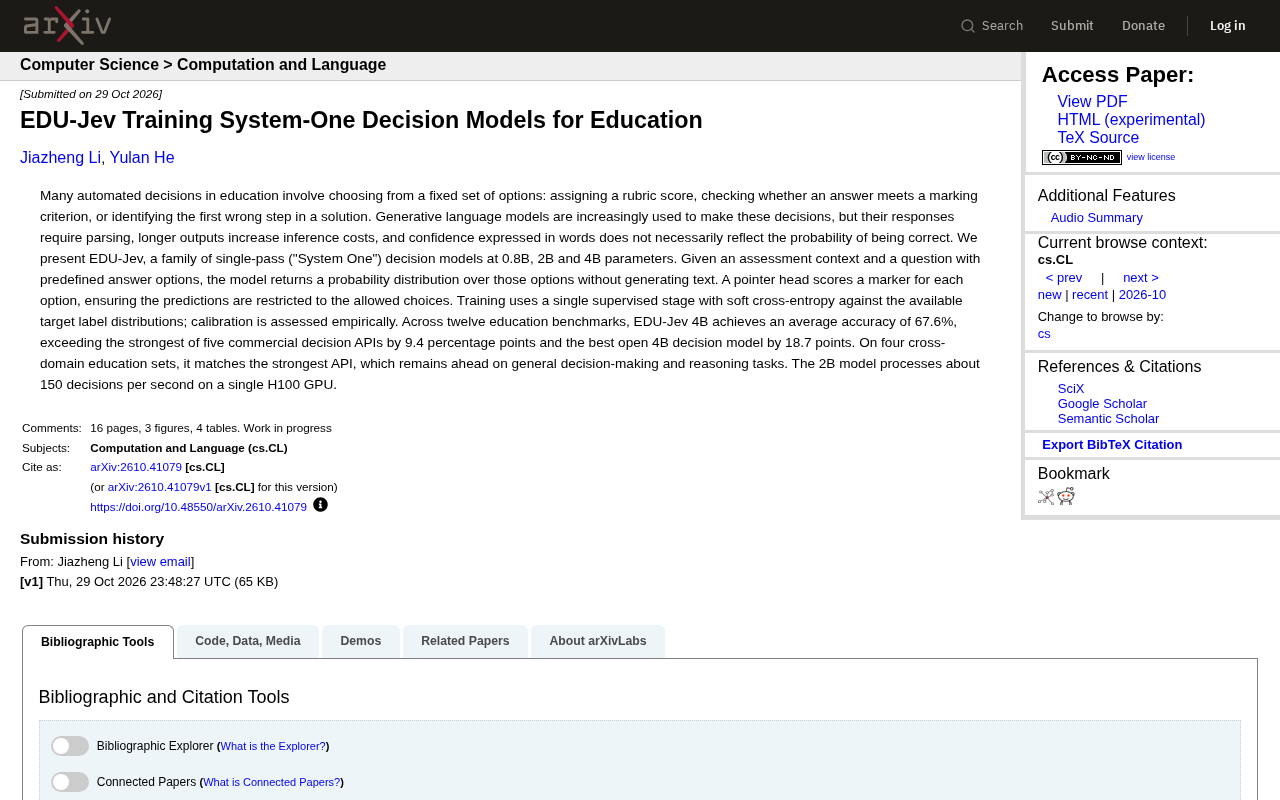
EDU-Jev 是一族面向教育评分场景的单次前向决策模型,参数量覆盖 0.8B、2B 和 4B。它不生成任何文本,而是通过 pointer head 为预定义选项打分,直接返回覆盖全部候选的概率分布,从而省去输出解析环节并把预测严格限制在封闭评分标准之内。训练采用单阶段软交叉熵,校准效果经实验检验。论文数据显示,4B 版本在十二个教育基准上平均准确率 67.6%,超过最强商业决策 API 9.4 个百分点、最强开源 4B 决策模型 18.7 个百分点;2B 版本在单张 H100 上每秒约处理 150 次决策,适合批量批改。作者也承认其在跨领域教育集上仅与最强 API 持平,通用决策与推理任务仍然落后,属于专用而非通用模型。
教育场景中的大量自动化决策——给作文打 rubric 分、判断答案是否满足评分点、定位解题中第一个出错步骤——本质上都是从固定选项里做选择。生成式语言模型被越来越频繁地用于这类任务,但代价也很明显:输出需要额外解析、长文本推高推理成本,而模型用文字表达的"信心"未必等于答对的概率。
EDU-Jev 给出的思路是绕开生成:不写文字,直接输出选项上的概率分布。
从「写答案」到「选答案」
EDU-Jev 是一族单次前向("System One")决策模型,参数量覆盖 0.8B、2B 和 4B。输入是一段评估上下文加上带预定义选项的问题,模型不生成任何文本,直接返回一个覆盖所有选项的概率分布。
关键设计是一个 pointer head:它为每个选项打出一个标记分数,从而把预测严格限制在允许的候选集合内。这一点对教育评分场景很重要——评分标准往往是封闭的,模型没有"自由发挥"的空间,也就不存在输出格式不合规的问题。
训练只用一个监督阶段,采用针对可用目标标签分布的软交叉熵,校准效果通过实验评估。这种单阶段设计降低了训练流程的复杂度,也让小参数模型更容易落地。
软交叉熵与概率校准
软交叉熵(soft cross-entropy)指训练时不把目标当作硬性的 one-hot 标签,而是允许每个选项带一个目标概率(例如由多个标注者投票得到的标签分布),损失函数为 (-\sum_i p_i \log q_i),其中 (p_i) 是目标分布、(q_i) 是模型输出分布。相比硬标签,它保留了标注分歧中的不确定性信息,也更贴合"同一篇作文可能落在相邻两个分数档"这类教育评分的真实情况。
概率校准(calibration)衡量的是模型给出的概率是否与真实正确率一致:若模型对所有预测为 0.8 的样本,实际正确率也接近 80%,则称其校准良好。教育场景中校准尤为关键,因为下游往往要按阈值分流(如低置信样本转人工复核)。常用度量包括期望校准误差(ECE)与 Brier 分数。
单次前向与"System One"
"System One"借自双过程理论,此处指模型在一次前向传播中直接给出结果,不经过思维链、多步推理或自回归逐 token 生成。对自回归语言模型而言,生成 k 个 token 需要 k 次串行前向,延迟随输出长度线性增长;而单次前向的决策模型输出长度固定(仅一个分布向量),延迟基本与选项数量无关。这正是 2B 模型能在单张 H100 上达到每秒约 150 次决策的结构性原因,也是它与生成式评分路线在吞吐量上拉开差距的根本所在。
性能:4B 模型在十二个教育基准上领先
据论文给出的数据,EDU-Jev 4B 在十二个教育基准上取得 67.6% 的平均准确率,比五个商业决策 API 中最强的一个高出 9.4 个百分点,比最好的开源 4B 决策模型高出 18.7 个百分点。
更值得关注的是效率数字:2B 模型在单张 H100 GPU 上每秒可处理约 150 次决策。对于需要批量批改的学校或考试机构,这个吞吐量意味着评分环节可以真正做成流水线,而不是逐个调用生成式模型。
作者也如实标注了边界:在四个跨领域教育数据集上,EDU-Jev 与最强 API 打平;但在通用决策与推理任务上,它仍然落后。换句话说,这是一个专才,不是通才。
教育专用模型的取舍逻辑
EDU-Jev 的价值主张建立在一个判断上:教育评分这类高频、封闭、对延迟敏感的任务,不需要通用对话能力,需要的是在有限选项上稳定给出概率。
这个取舍带来三重收益。其一,省掉解析环节,输出本身就是结构化的分布,下游系统可以直接取 argmax 或按阈值处理。其二,推理成本随输出长度归零而下降,长文本生成的开销不再存在。其三,校准可以实证检验——模型给出的概率与正确率之间的对应关系,比"文字信心"更可度量。
代价同样清晰:一旦任务需要开放式作答、解释性反馈或跨领域泛化,这类模型的能力边界就会显现。论文本身也承认通用任务上的劣势。
Pointer head 与候选集约束
Pointer head 得名于指针网络(pointer network),其核心是用输入中已存在的候选元素作为输出词汇表,而非使用完整的词表。在这里,它为每个预定义选项计算一个标记分数并经 softmax 归一化,使输出维度等于选项数。相较让模型自由生成文本再解析,这种设计从结构上排除了三种常见失败模式:输出不符合格式、生成了候选集之外的答案、以及同一答案的多种表述导致下游匹配困难。代价是模型无法处理开放式作答——一旦正确答案不在候选集合内,模型只能在其间做出最优的错误选择。
落地场景与开放性
从描述看,EDU-Jev 最直接的应用方向是 rubric 评分、判分标准核验和错误步骤定位——都属于有明确候选答案的判定型任务。0.8B 与 2B 的小尺寸版本,则为本地化部署和成本敏感的批处理场景留出了空间。
需要说明的是,本文信息来自论文摘要层面的公开描述,模型权重、训练细节与完整评测设置尚未在素材中展开,实际可用性有待进一步验证。对教育科技团队而言,值得观察的是这类"决策专用"路线会不会成为生成式评分之外的第二条技术路径。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。