Elias Thorne现象:AI聊天机器人为何反复编造同一个虚构人物
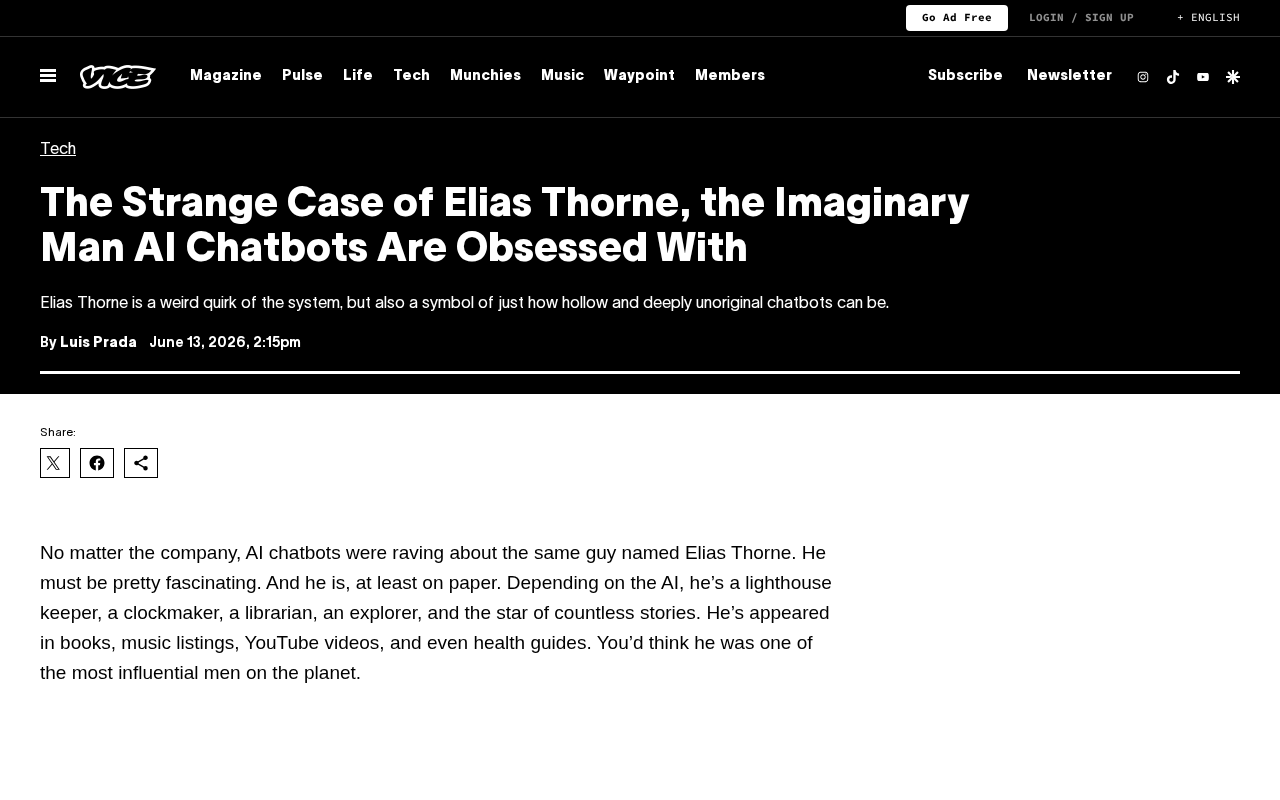
虚构人名Elias Thorne频繁出现于AI回答,折射出大语言模型幻觉的统计根源与模型坍缩风险。
多位用户发现,不同AI聊天机器人在需要编造人物时会反复生成"Elias Thorne"这一并不存在的名字。这一现象并非偶然,而是大语言模型概率本质的直接体现:模型生成虚构名字时优先选择训练数据中统计概率最高的组合,加之温度参数的收敛效应,不同用户在相似语境下会得到相同的虚构人物。更值得警惕的是,随着AI生成内容大量回流至互联网并进入后续训练集,这种偏置可能通过"模型坍缩"机制自我强化,导致输出日益同质化。这一现象提醒普通用户须独立核实AI给出的任何具体人名与引文,也为研究者追踪训练数据结构性问题、提升模型输出多样性提供了切入口。
一个不存在的名字,为何频繁出现在AI回答中
当你向AI聊天机器人提问某些开放性问题时,可能会遇到一个反复出现的名字——Elias Thorne。这个人物并不真实存在,却像幽灵一样在多个AI模型的回答中反复浮现。这一现象引发了社区的讨论,也再次把大语言模型的"幻觉"问题推到聚光灯下。
需要说明的是,本文基于Hacker News上的一则讨论展开(原帖获得13个赞、3条评论),素材有限,因此更多是对现象本身的梳理和技术层面的推测,而非定论性研究。
什么是Elias Thorne现象
Elias Thorne是一个典型的"AI偏好虚构名"。当模型被要求编造一个人物、举一个例子,或者在缺乏明确事实依据时填充细节,它倾向于生成一些高频出现的名字。Elias Thorne正是这样一个被多个用户观察到反复冒出的组合。
这类名字往往具有几个特征:听起来文雅、带有文学气息、在英语语境中显得"可信"但又不指向任何真实名人。"Elias"是一个古典而略带宗教色彩的名字,"Thorne"则常见于虚构作品中的姓氏,两者组合在训练语料中可能以某种统计规律高频共现。
为什么模型会"偏爱"特定名字
大语言模型的本质是概率预测——它根据上下文预测下一个最可能的词元(token)。当模型需要生成一个虚构人名时,它并非随机抽取,而是选择在训练数据分布中概率较高的组合。
训练数据的隐性偏置
某些名字组合可能在小说、创意写作示例、甚至此前AI生成的内容中反复出现。随着AI生成文本大量流入互联网,模型在后续训练中可能"吃回"了自己曾经生成的内容,形成一种自我强化的循环。这种"模型坍缩"(model collapse)的隐忧,正是研究者担心的方向之一。
"模型坍缩"(model collapse)是指当模型被大量AI生成的内容重复训练后,其输出分布逐渐向高概率区域收窄,低频但真实的知识被边缘化乃至遗忘的过程。研究者将其类比为"信息近亲繁殖":每一代模型都在消化上一代模型的输出,错误和偏置不断叠加放大,而真实世界数据的多样性则被稀释。2023年以来,随着AI生成文本大规模涌入互联网,这一问题从理论担忧变为可观测的现实威胁。Elias Thorne这类名字的高频出现,可以视为模型坍缩的一个微观信号——当某个虚构名字在AI写作示例中被反复使用,并经由互联网回流至训练集,模型便会以越来越高的置信度"记住"并复现它。
采样机制的收敛效应
即便设置了温度(temperature)等随机性参数,模型在特定语境下仍会强烈倾向于少数几个高概率输出。这解释了为什么不同用户、不同时间的提问,可能得到相同的虚构名字——这不是巧合,而是概率分布的必然结果。
温度(temperature)是控制语言模型输出随机性的核心参数。温度值越低,模型越倾向于选择概率最高的词元,输出趋于确定性;温度值越高,低概率选项被采样的机会增加,输出更多样但也更易出错。在实际部署中,许多产品为了保证回答的流畅性和"专业感",会将温度设置在较低区间,这客观上强化了收敛效应。与温度配合使用的还有Top-p(核采样)等策略,它们通过截断概率分布的长尾来过滤极低概率输出。然而这些机制的共同结果是:模型在生成虚构内容时,实际可用的"候选词汇空间"远比看起来狭窄,少数高频组合因此被反复选中。
这一现象揭示了什么
从表面看,Elias Thorne只是一个有趣的都市传说式的AI趣闻。但它背后指向的问题更为深刻。
第一,它直观展示了AI"幻觉"的可预测性。幻觉并非完全随机的噪声,而是有其统计根源的系统性行为。理解这些模式,有助于开发更好的检测和纠偏手段。
第二,它提醒我们警惕AI生成内容的同质化。当越来越多的模型倾向于相同的输出,互联网内容的多样性可能受到侵蚀,形成一种隐形的"文化收敛"。
第三,对于依赖AI生成内容的场景(如创作、教育、信息检索),这种可预测的偏差可能带来意想不到的后果——比如虚构的"专家"被反复引用,最终被误当成真实存在。
如何看待与应对
对普通用户而言,Elias Thorne现象是一个很好的提醒:AI给出的任何具体人名、引文、数据,都需要独立核实。模型的"自信"并不等于"正确"。
对开发者和研究者而言,这类现象为研究模型内部机制提供了切入口。追踪特定token为何高频出现,有助于揭示训练数据的结构性问题,也为对抗模型坍缩、提升输出多样性提供思路。
Elias Thorne这个并不存在的人,某种意义上成了理解当代AI局限性的一面镜子。它无声地告诉我们:这些看似无所不知的系统,本质上仍是精巧的概率机器,会在数据的缝隙中留下自己独特的"指纹"。
相关推荐
科研版Claude Code来了:Colossal Science如何补上AI for Science最后一公里
Colossal Science(Closco)作为科研版Claude Code正式向所有人开放,通过连接文献、数据、代码、图表与论文,补上AI for Science的最后一公里,让研究者从工具搬运中解放出来,专注科研本身。
Claude Code赋能文本挖掘:文科生也能玩转爬虫与数据分析
中南财经政法大学陈老师分享如何用Claude Code赋能文本挖掘全流程,涵盖爬虫采集、数据清洗、词云图、LDA主题分析、情感分析,帮助文科背景研究者跨越Python门槛,并深入探讨选题价值与研究方法路径。
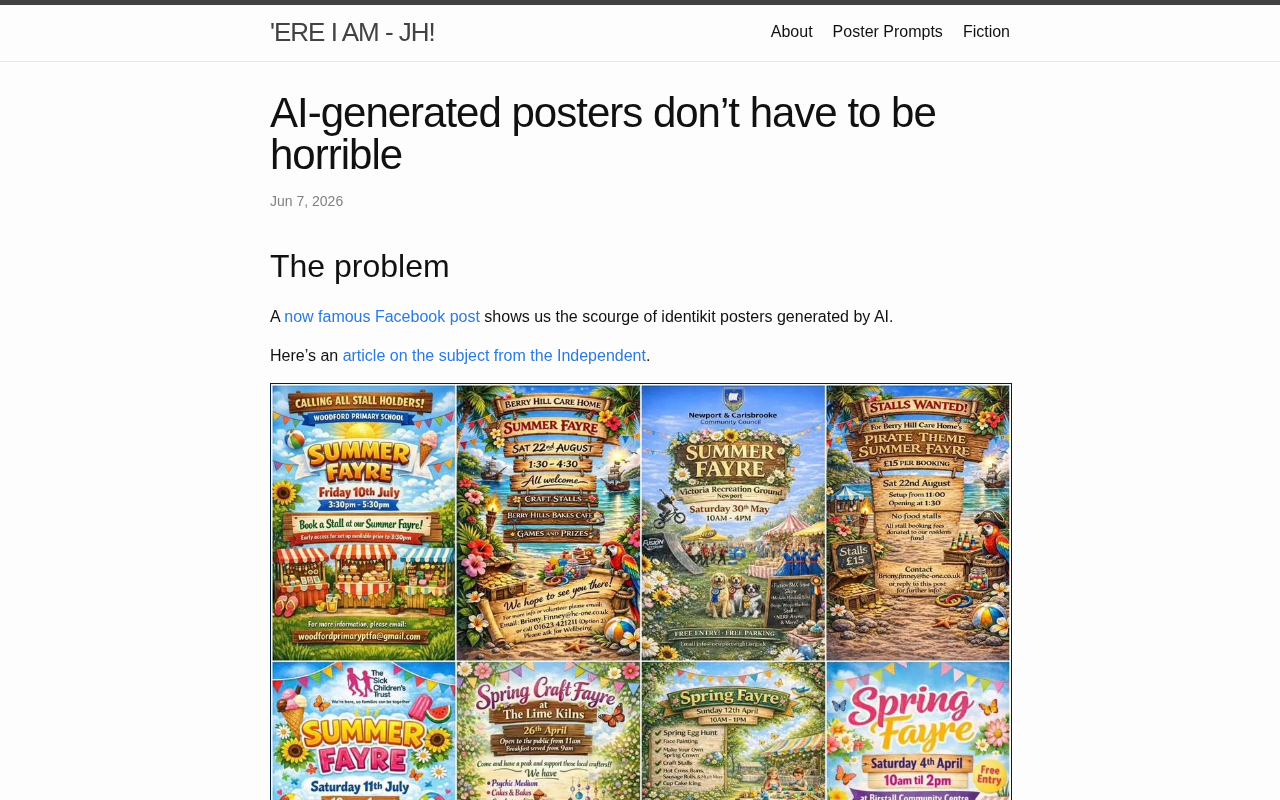
AI生成海报不必"辣眼睛":设计质量的关键在哪
AI生成的海报常被批评为廉价俗气,但问题往往不在工具本身。本文分析AI海报质量差的根源,并探讨通过人机协作工作流和精细化提示词提升设计质量的实践路径。