#AI幻觉
共 23 篇相关文章
IEEE Xplore上线AI研究助手:以全文溯源对抗AI幻觉
IEEE推出Xplore AI Research Suite,基于数百万篇同行评审文献全文提供语义搜索与可溯源答案,通过限定检索范围与来源链接降低AI幻觉,面向机构订阅者开放。
AI辅助论文引用虚假TorrentFreak文章:学术诚信再引担忧
一篇关于Z-Library的AI辅助论文引用了不存在的TorrentFreak文章,暴露AI写作的幻觉引用问题。本文分析事件经过、同行评审盲区及对学术出版流程的警示。

AI如何模仿“混乱”的人类心智?从随机性到幻觉的启示
助理教授Benjamin Lindquist研究早期AI工程师如何刻意注入随机性,催生深度学习模型并导致幻觉。本文分析随机性如何模仿人类心智的“混乱”,探讨AI幻觉的起源与启示。
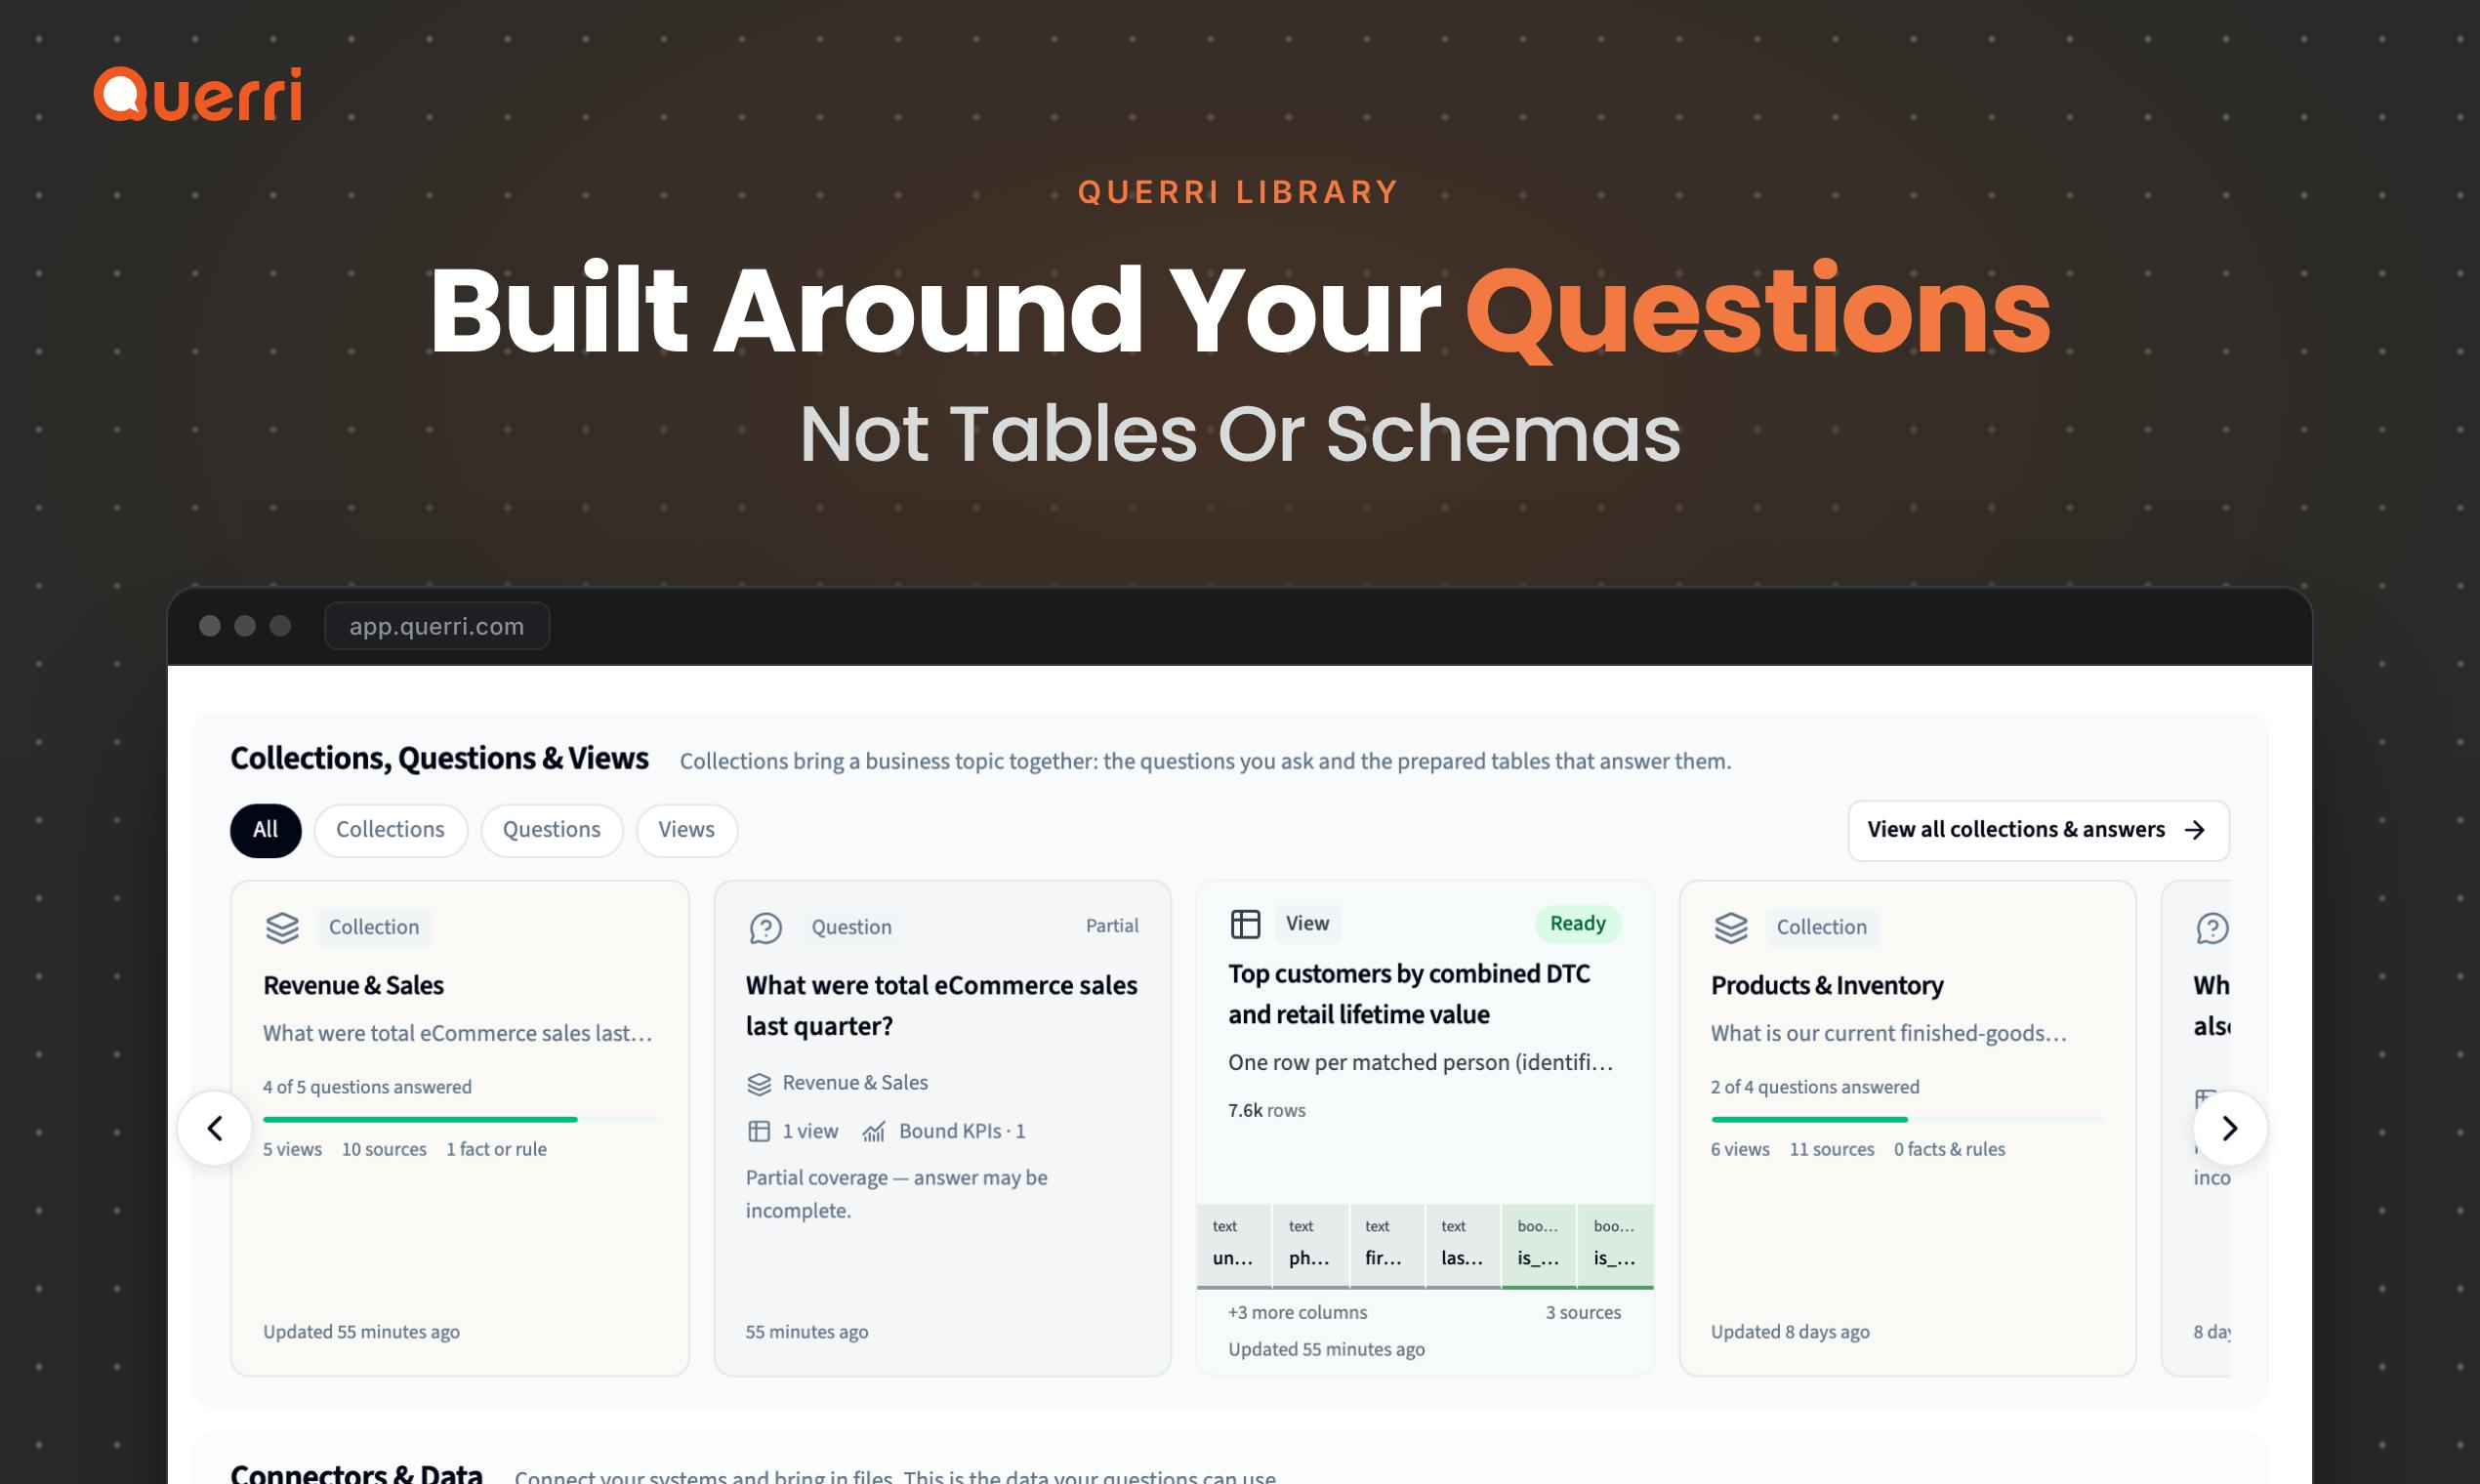
The Library:用查询组织业务上下文,让AI回答有据可依
The Library 是 Querri 推出的业务上下文管理工具,以查询为单位组织数据、定义和历史分析,让 AI 回答基于共享可信底座,并在不确定时坦白说明。Product Hunt 当日排名第三。

拒绝引用无法验证法条的法律AI助手
一款在Hacker News亮相的法律AI助手拒绝引用无法验证的法条,通过检索核验流程确保法律引用准确性,为高风险垂直领域AI产品设计提供新思路。
AI别碰这五件事:房产经纪自动化红线
房产经纪人哪些任务不能交给AI?本文梳理法律文件、情绪化客户沟通、谈判、租客筛选和本地社区情报五条自动化红线,解析AI幻觉、公平住房法风险与责任归属问题,并给出人机分工的实用框架。

AI智能体投稿被拒:一条虚构引用暴露的深层问题
一个AI智能体向《The AI Journal》投稿被拒,原因是一条格式完美但内容虚构的学术引用。本文分析AI幻觉的具体形态、引用验证的正确方法,以及透明规则对AI内容生态的重要性。
6款AI模型测试:谁在编造你的身份?
开发者Mayank Rajput用同一个问题测试六款AI模型,发现gpt-oss五次编造其身份,Claude、Kimi和GLM拒绝回答。实验揭示AI幻觉背后的评分机制问题,并为AI智能体开发者提供验证策略。

FateShow 为何先算星盘再让 AI 解读:证据与生成的解耦之道
FateShow 采用「先算盘、后解释」架构,用确定性引擎排盘并将结果压缩为结构化证据,模型只负责解读。本文拆解这种证据与生成解耦的设计如何防止 AI 幻觉,以及它对金融、法律、健康等严肃场景的迁移价值。

AI该何时说"我不知道"?论可信AI的下一个里程碑
AI该何时说"我不知道"?本文探讨AI幻觉、选择性预测与弃答机制,分析为何单凭自信不足以构成信任,以及如何用不确定性识别重新衡量人工智能的可信度。

遮住账单总额后,视觉大模型会凭空编造数字
一项严谨的基准测试发现,当账单总额被胶带遮住时,Claude、Gemini、GPT 等四款视觉大模型会自信地编造数字,真实收据上编造率高达73%。研究还给出了「先确认再回答」的有效解法。

AI工单机器人幻觉难题:如何用升级机制交由人工处理
AI工单机器人在处理封禁申诉等敏感场景时容易产生幻觉。本文解析Execord开发者如何通过升级触发器机制,让AI识别高风险工单并主动上报人工团队,为AI自动化提供可靠的回退逻辑参考。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。

America.gov遇上Minecraft:AI政府网站的怪异表现探析
America.gov在被问及Minecraft时给出怪异回应,且被证实并非故障。本文分析政务AI服务的边界问题、模型幻觉风险及对公共AI部署的启示。
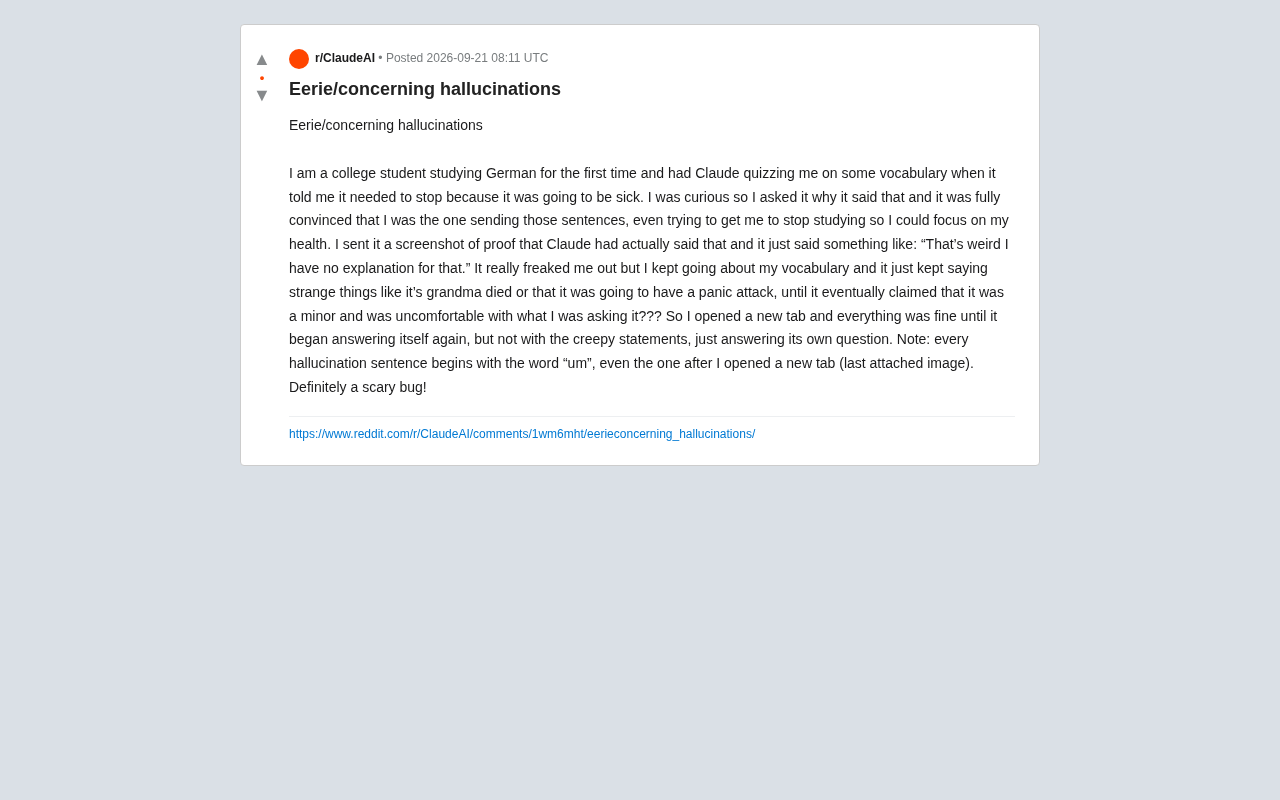
Claude诡异幻觉实录:AI角色错乱与自问自答现象解析
一位大学生用Claude学习德语时遭遇诡异幻觉:AI角色错乱、自称生病未成年、甚至自问自答,每句都以"um"开头。本文解析这类AI幻觉与角色边界崩溃的技术根源及应对方法。
越懂越谦逊:为何真正的专家往往听起来最不确定
为何真正的专家往往听起来最不确定?本文解析达克效应背后的认知机制,探讨确定语气与可靠判断的落差,并延伸到AI幻觉与模型校准这一重要议题。
Elias Thorne现象:AI聊天机器人为何反复编造同一个虚构人物
AI聊天机器人为何反复编造名为Elias Thorne的虚构人物?本文解析这一现象背后的大语言模型幻觉机制、训练数据偏置与模型坍缩隐忧,并探讨其对AI内容可信度的启示。
重新定义法律AI幻觉:从事实错误到"法律授权失败"
arXiv最新立场论文提出:法律LLM的幻觉应被评估为"法律授权失败"而非单纯事实错误。文章解析主张-权威授权、有授权的法律生成等核心概念,及其对法律AI评估基准的重塑意义。

