EmbeddingGemma 2发布:原生多模态嵌入开源模型

谷歌开源EmbeddingGemma 2,单模型统一四模态嵌入,专为隐私友好的端侧检索与RAG场景设计。
谷歌推出的EmbeddingGemma 2是一个将文本、图像、视频、音频统一映射到同一嵌入空间的开源多模态嵌入模型,最大参数量7.4亿,专为端侧边缘硬件优化。它支持Matryoshka向量截断(768维至128维),可在精度与存储成本间灵活权衡,同时提供8000 token上下文窗口,足以处理长文档与较长音频。官方演示展示了在手机上完全离线完成自然语言搜图和视频片段定位的能力,无需转录或外部API。与轻量生成模型结合,还可在设备端构建完整的RAG流水线和智能体工作流,敏感数据始终不离开硬件。模型支持垂直领域微调,权重已在Hugging Face开放下载。
谷歌推出的 EmbeddingGemma 2 把文本、图像、视频和音频统一映射到同一个嵌入空间,打破了跨模态检索长期依赖多个独立模型的局面。对于想在端侧构建搜索、检索、分类与聚类系统的开发者来说,这是一个值得关注的开源模型。
一个模型统一四种模态
传统的跨模态检索通常需要三套甚至更多模型——文本一套、视觉一套、音频一套,彼此之间还要再做对齐。EmbeddingGemma 2 的核心变化在于,它把文本、图像、视频、音频,乃至它们的任意组合,统统映射到同一个高维嵌入空间。
官方给出的直观例子是:一张猫的图片、"cat"这个单词、以及一声猫叫,在共享的嵌入空间中会被映射到彼此靠近的位置。这意味着开发者只需一个模型,就能针对不同类型的数据同时构建搜索、检索、分类和聚类能力,而不必再维护一堆各管一摊的子模型。
从工程角度看,统一嵌入空间带来的最大价值是简化了整个检索链路。过去跨模态系统最头疼的就是不同模型输出的向量不在同一坐标系里,需要额外的桥接或投影层。单一模型意味着更少的部署复杂度和更一致的检索语义。
小体积、高性能,专为端侧设计
EmbeddingGemma 2 把目标明确对准了参数量在十亿以下的赛道,官方称其在多个基准测试上甚至超越了体积大得多的模型,为这一区间树立了新的标准。
模型采用模块化设计,最大参数量为 7.4 亿(740M),输出 768 维向量。借助 Matryoshka 表示学习(Matryoshka representation learning),开发者可以把输出维度截断到最低 128 维——这对存储和检索成本敏感的端侧场景尤为实用,可以在精度和效率之间灵活权衡。
模型支持 8000 token 的上下文窗口,足以直接在设备上嵌入长文档、代码库或较长的语音录音,供后续搜索和检索使用。这一组参数配置透露出清晰的设计意图:让高质量嵌入能力真正跑在手机等边缘硬件上。
Matryoshka 表示学习(MRL)是一种向量压缩训练方法,名称取自俄罗斯套娃玩具。其核心思想是:在训练时同步优化多个维度截断版本的向量,使得一个完整的高维向量(如 768 维)的前 N 个维度本身就构成一个有效的低维嵌入(如 128、256 维),而无需重新训练或单独的压缩模型。这与传统 PCA 等降维方式的本质区别在于,MRL 训练出的低维子向量具有语义完整性,而非事后截断导致信息断层。对于端侧场景,这意味着开发者可以根据设备内存和延迟预算动态选择向量维度:在资源充裕时使用 768 维以获得最高精度,在存储或推理受限时切换到 128 维,而底层模型完全不变,极大简化了部署与版本管理。
端侧实测:自然语言搜图与视频片段定位
官方通过 Google AI Edge Gallery 应用展示了实际效果。第一个场景是搜索——用户可以用自然语言查询直接检索照片和视觉素材。
更有意思的是视频内检索功能 Video Moment Finder。演示中,想在一段生日视频里找到"吹蜡烛"的瞬间,只需搜索"blowing out candles",模型就能立即定位到那个确切片段。整个过程直接在手机上完成,不需要中间的转录步骤,也不调用任何外部 API,意味着搜索可以完全离线进行。
这种端侧、离线、免转录的检索体验,对于视频素材管理、相册整理这类高频又涉及隐私的场景很有吸引力。
与生成模型搭配,构建端侧 RAG 与智能体
EmbeddingGemma 2 的更大想象空间在于,它可以与轻量级生成模型配合,构建完全运行在设备上的 RAG 流水线和智能体工作流,让敏感的用户数据始终不离开硬件。
官方在 AI Edge Foresight 应用中演示了这一能力:应用在后台持续监听,对音频流进行嵌入,检测到用户提出的问题后,立即给出生成的摘要,并从本地存储中检索出对应的系统架构图一并呈现。由于所有嵌入都在设备上完成,敏感信息严格保持私密。
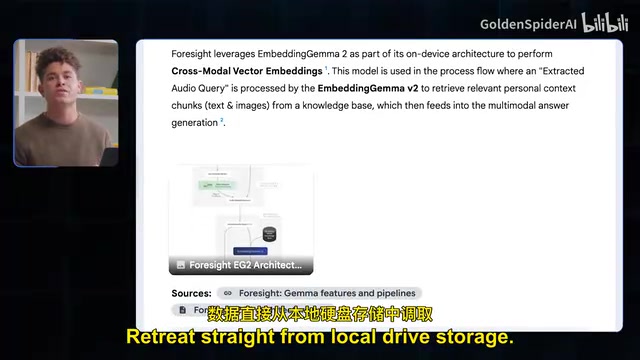
这套组合拳的价值在于把"检索"和"生成"两个环节都收进本地,既避免了数据外传的隐私风险,也降低了对网络和云端 API 的依赖。对医疗、法律等强合规领域尤为关键。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将向量检索与大语言模型生成能力结合的架构范式。标准流程是:先将知识库文档切分并通过嵌入模型转换为向量存入本地索引,用户提问时同样被转为向量,与索引做相似度匹配,召回最相关的文档片段,再将这些片段作为上下文拼入生成模型的提示词,由生成模型输出最终回答。这种方式解决了纯生成模型"幻觉"和知识截止日期的问题,同时比全量微调成本低得多。将 RAG 的两个核心组件——嵌入模型(EmbeddingGemma 2)和生成模型(如 Gemma 2 系列轻量版)——都运行在端侧,意味着整个问答与检索流水线可以在完全断网的环境下运行,用户的私人文档、会议录音等敏感数据全程不经过任何外部服务器。
可微调,适配垂直领域
开箱即用的质量之外,EmbeddingGemma 2 还支持针对特定领域的词汇和专业素材进行微调,比如为复杂的法律合同、医学影像或技术产品目录建立索引。官方强调,这种微调能在不增加模型体积的前提下提升检索精度。
换句话说,开发者既能享受小模型的部署优势,又能通过微调把它调教成领域专家,不必为了精度去背上更大的模型。
模型权重目前已可在 Hugging Face 下载,谷歌同时在 Gemma Cookbook 中提供了配套的 notebook 供上手实践。对于关注端侧 AI 和多模态检索的团队,这是一个成本和隐私都友好的新选择。
相关推荐

好莱坞的真正对手:免费内容的降维打击
Skydance 收购华纳和派拉蒙后高喊对标硅谷,但好莱坞真正的对手是 TikTok、Instagram 和 YouTube——它们几乎不为内容付费。本文剖析免费内容大军、硅谷版权侵权文化与 AI 训练数据争议背后的成本结构之战。

KernelAgent:多智能体自动优化GPU内核,跨硬件超越专家基线
Meta 推出的 KernelAgent 是一套多智能体 GPU 内核优化框架,能自动编写并优化内核,在 GPU、TPU、AMD 及 Meta 自研 AI 芯片等异构硬件上超越专家基线。本文解析其设计思路与应用价值。

Alexa Plus一年实测:智能家居之王,为何仍走不出家门?
The Verge播客实测Alexa Plus近一年:语音创建自动化场景体验出色,成为最强智能家居助手,但跨出家门做通用助理却屡屡碰壁。亚马逊500美元新平板欲补个人情境短板,苹果Siri AI也将入场,智能家居之争背后是技术成熟与隐私信任的深层张力。