EvoGuard:在线技能进化中的退化缓解新方案
EvoGuard 用成对技能选择器实现低延迟在线技能进化,有效缓解性能退化。
本文介绍了 EvoGuard,一种用于语言智能体在线技能进化的轻量级质量控制方法。针对现有方法要么盲目采纳新技能导致退化、要么依赖昂贵验证集评估拖慢迭代的两难困境,EvoGuard 训练一个基于两个标签 token logits 的成对技能选择器,并通过拒绝采样仅保留效用差距明显的技能对作为训练数据。部署时只需一次前向传播即可判断新旧技能孰优孰劣,速度显著快于私有测试集评估。在 ALFWorld、ScienceWorld 和 LiveCodeBench 三个基准上,相比全采纳基线分别提升 11.0%、5.9% 和 2.7%。文章指出该范式可扩展到模型参数更新筛选、经验回放样本选择等在线学习场景。
在线技能进化是语言智能体持续适应环境的关键能力,但现有方法在每次更新后要么盲目采纳新技能导致性能退化,要么依赖昂贵的验证集评估拖慢迭代速度。近期提出的 EvoGuard 通过成对技能选择器,在低延迟低成本下实现了技能退化的有效缓解,为在线技能进化提供了新思路。
在线技能进化的两难困境
语言智能体通过将经验沉淀为自然语言文档形式的技能,实现跨任务复用。然而,当技能需要在线进化时,传统方法面临两个极端:一种做法是从多任务轨迹中离线更新技能后直接采纳,缺乏任何检查机制,导致技能质量随时间逐渐退化;另一种做法则依赖保留的验证集评估新技能,只有性能提升才保留,但每次更新后都运行验证集过于缓慢和昂贵,难以支撑高频在线迭代。
这种两难本质上反映了在线学习场景对“快速决策”与“质量保障”的双重需求。EvoGuard 的出发点正是寻找一个低延迟的折中方案,在不牺牲太多准确性的前提下快速判断新技能是否优于旧技能。
EvoGuard 的核心机制:成对选择与拒绝采样
EvoGuard 的设计分为训练和部署两个阶段。训练阶段首先让智能体迭代运行,构建技能池,并在私有测试集上为每个技能打分,获得效用标签。随后将技能两两配对,通过拒绝采样只保留效用差距明显的技能对——这确保了训练信号的质量,避免模型学习模糊的偏好。
选择器本身基于两个标签 token 的 logits 进行训练,目标是判断一对技能中哪个更优。这种设计将技能比较转化为一个二分类式的偏好判断问题,模型只需输出两个标签 token 的相对概率即可做出选择。训练数据来自技能池中效用差距清晰的配对,使得选择器能够聚焦于可区分的案例。
拒绝采样(Rejection Sampling)是一种从目标分布中获取高质量样本的通用技术。其基本思想是:先从一个易于采样的提议分布中生成候选样本,再根据某种接受准则决定是否保留该样本,从而过滤掉低质量或不符合要求的样本。在 EvoGuard 中,拒绝采样被用于筛选技能对:只有当一对技能的效用差距超过预设阈值时,该技能对才被保留作为训练数据。这样做的好处是避免选择器学习到模糊或噪声较大的偏好信号,从而提升训练效率和最终决策的准确性。拒绝采样在强化学习、偏好建模和数据集构建中均有广泛应用,其核心权衡在于阈值设定——阈值过高会导致样本不足,过低则引入噪声。
Logits 是神经网络最后一层(通常是线性层)输出的未归一化分数向量。对于分类任务,模型会为每个类别输出一个实数分数,这些分数经过 softmax 函数后才能转化为概率分布。在 EvoGuard 中,选择器被设计为输出两个标签 token 的 logits,分别对应“选择技能 A”和“选择技能 B”的偏好分数。通过比较这两个 logits 的大小(或计算它们的 softmax 概率),模型即可判断一对技能中哪个更优。这种基于 logits 的二分类式偏好判断避免了生成完整文本的开销,使得单次前向传播即可完成决策,这正是 EvoGuard 实现低延迟的关键技术基础。
部署阶段:单次前向传播的快速决策
在部署时,EvoGuard 对每一对新旧技能进行一次前向传播,直接输出更优技能的选择结果。与运行私有测试集评估相比,单次前向传播的速度显著更快,成本也大幅降低。这意味着智能体可以在每次技能更新后立即获得质量判断,而不必等待昂贵的评估流程。
这种低延迟特性使得在线技能进化更加实用。智能体能够在交互过程中持续积累和筛选技能,避免退化技能进入技能库,同时保持较快的迭代节奏。
实验效果:多环境成功率提升
论文报告了在三个基准环境上的对比结果。与“采纳每个新技能”的基线相比,EvoGuard 在 ALFWorld 上成功率提升 11.0%,在 ScienceWorld 上提升 5.9%,在 LiveCodeBench 上提升 2.7%。这些提升表明,成对选择器能够有效过滤掉导致退化的技能更新,保留真正有用的技能进化。
有意思的是,不同环境的提升幅度差异反映了任务特性对技能退化的敏感程度不同。ALFWorld 作为具身交互环境,技能质量对任务成功的影响更为直接;而 LiveCodeBench 作为代码生成基准,技能退化的影响相对温和。这一差异也提示未来可以针对不同任务类型调整选择器的保守程度。
对在线技能进化的启示
EvoGuard 的价值不仅在于具体方法,更在于它提出了一种轻量级的技能质量控制范式。传统上,技能进化要么完全信任更新,要么依赖重型评估,EvoGuard 证明通过训练一个轻量选择器,可以在两者之间取得平衡。这对于需要长期在线运行的智能体系统尤为重要——技能库的质量直接决定了智能体的适应能力上限。
从更广的视角看,成对比较与拒绝采样的组合思路可以扩展到其他在线学习场景,例如模型参数更新筛选、经验回放中的样本选择等。EvoGuard 为在线进化中的质量保障提供了一个可复用的技术组件。
随着语言智能体从静态部署走向持续学习,类似 EvoGuard 的轻量级守护机制将成为基础设施的一部分。如何在更低成本下实现更准确的技能评估,以及如何处理技能之间的复杂依赖关系,仍是值得探索的方向。
相关推荐
FastAPI学习路线:从入门到AI项目实战
B站UP主推荐《FastAPI Web开发入门进阶与实战》,本文梳理FastAPI学习路线:适用人群、15章六大部分结构、项目驱动学习法,以及从Web后端到AI Agent的实战方向,帮零基础学习者少走弯路。
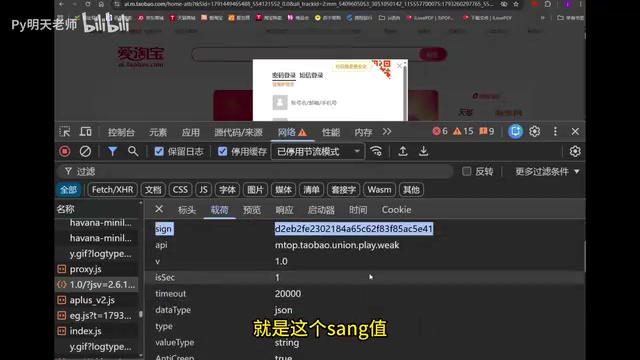
10分钟用AI逆向淘宝sign签名参数实战
基于B站实操演示,详解如何用DeepSeek与视觉模型组合,在十分钟内自动逆向淘宝sign签名参数、追踪titter与token动态值,并成功抓取商品数据,同时分析AI Agent在爬虫逆向中的能力边界与合规风险。
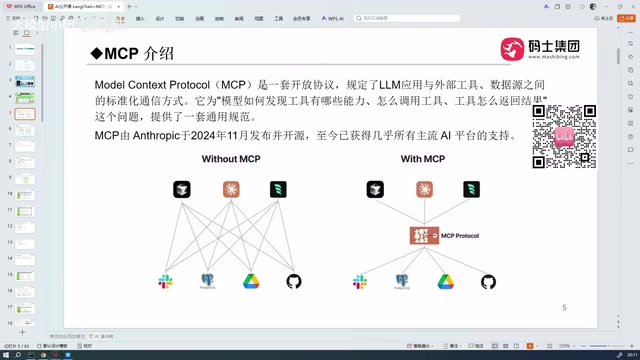
LangChain+MCP从入门到实战:B站教程深度解析
B站LangChain+MCP教程深度解析:从框架定位、智能体封装到MCP协议入门。讲解为什么不该手搓框架,以及零基础如何跟上代码实战路线。