10分钟用AI逆向淘宝sign签名参数实战
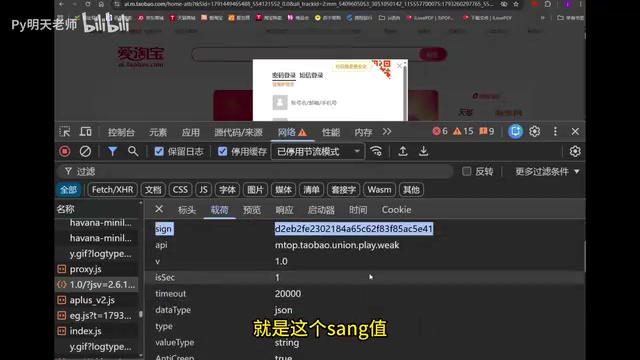
AI Agent结合DeepSeek与视觉模型,十分钟内自动化完成淘宝sign参数逆向与商品数据抓取。
本文复盘了利用AI Agent(DeepSeek加视觉模型)逆向淘宝sign签名参数的实操过程。传统逆向需手动调试JS、补环境,耗时繁琐;而AI接管后,能自主规划任务、调用真实浏览器进行环境校验、识别MD5类哈希算法、追踪cookie中的动态titter值,并完成token拼接与请求构造。演示中AI成功抓取前十条商品数据,耗时压缩至十分钟量级。但方案仍有边界:登录态是获取完整数据的前提,titter值每次会话需重新获取,AI首次分析也可能需多轮迭代。文章指出,AI的价值在于自动化“抓包—定位—环境校验—参数拼接—验证”链路,而非替代对加密算法的理解,并提醒开发者关注合规边界。
在Web安全与爬虫开发领域,淘宝的sign签名参数一直是道难以绕开的坎。传统逆向需要反复调试JavaScript、扣代码、补环境,过程繁琐且耗时。如今借助AI Agent,这套流程可以被压缩到十分钟以内。本文基于B站UP主的实操演示,复盘如何用DeepSeek与视觉模型组合,自动化完成sign参数的逆向定位与商品数据抓取。
逆向目标:sign签名参数到底难在哪
打开淘宝页面,按F12进入开发者工具,刷新后在网络面板里筛选XHR请求,就能看到带有sign参数的接口。这个参数由前端JavaScript动态生成,一旦缺失或错误,服务端会直接拒绝返回商品数据。
据演示中的观察,请求头里除了sign,还存在动态变化的titter值(演示中口述为titter,实际可能对应某个token字段)以及时间戳等要素。titter值存放在cookie数据中,且每次会话都会变化;token值则由前半段字符串拼接时间戳构成。这意味着单纯复制某次请求的参数毫无意义,必须真正理解生成逻辑。
传统做法是手动断点调试、搜索关键字、定位加密函数,再判断是否为MD5或其他哈希算法。演示中AI检测到使用的是MD5类哈希算法进行测试,但这只是其中一环,真正的难点在于参数之间的依赖关系和浏览器环境的校验。
MCP(Model Context Protocol) 是一种让大语言模型与外部工具、数据源标准化连接的协议。在逆向场景中,MCP 相当于给 AI 提供了“操作浏览器”“读取 cookie”“执行 JS”等能力的接口层,使模型不再局限于生成文本,而是能真正驱动工具链完成任务。演示中提到的“skills 与 MCP 能力”即指 AI 通过预置的技能模块调用浏览器自动化工具,实现环境检测与参数提取。
浏览器指纹检测 是平台反爬的另一道门槛。服务端会收集浏览器类型、版本、插件列表、Canvas 渲染特征、WebGL 参数等信息,生成唯一标识。若请求来自无头浏览器或环境异常,即使 sign 正确也可能被拒绝。因此 AI 在演示中先打开真实浏览器验证运行环境,正是为了通过指纹校验,确保后续请求能被服务端接受。
AI Agent如何接管逆向流程
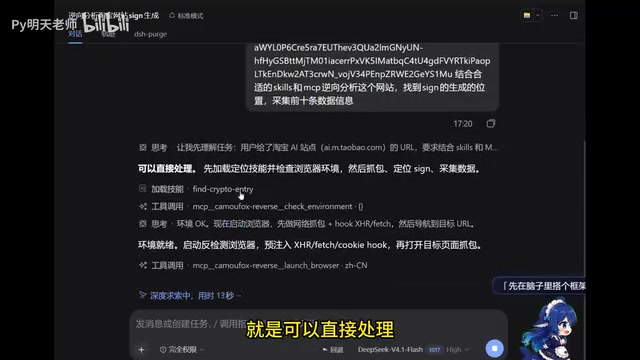
演示把整个任务直接交给AI:提交目标链接,并给出指令,要求结合sign相关的skills与MCP能力,分析sign的生成位置,并拆解前十条商品数据信息。模型接到任务后开始自主规划,定位技能模块并检查浏览器环境。
这一步的关键在于AI调用了真实浏览器环境进行检测,而不是纯静态分析代码。它打开浏览器界面,验证运行环境是否满足页面要求,再在此基础上执行算法测试。这种“环境校验+算法识别”的组合,恰好对应了淘宝反爬中常见的两道门槛:一是JS逻辑混淆,二是浏览器指纹检测。
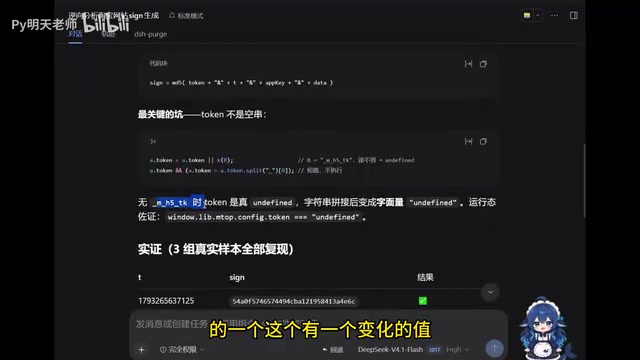
从演示过程看,AI能够自动发现动态变化的值,并追踪到cookie中对应的字段。对于未登录状态,部分数据无法获取完整,这也是演示中需要先登录账号的原因。登录后,token结构变得完整,前半段为固定标识,后半段为时间戳,AI据此完成参数拼接与请求构造。
cookie 与登录态 在淘宝的鉴权体系中扮演核心角色。用户登录后,服务端会下发包含身份标识的 cookie(如 _tb_token_、cookie2 等),后续请求携带这些 cookie 才能获取完整数据。演示中提到的 titter 值即存放于 cookie 中,且随会话变化。未登录时,部分接口仅返回脱敏或空数据,因此 AI 需要先完成登录流程,使 token 结构完整(前半段固定标识 + 后半段时间戳),才能构造出有效的请求参数。这也解释了为什么登录态是绕不开的前提。
实战结果与能力边界
环境准备就绪后,AI重新获取titter值并跑完整个流程,成功拿到前十条商品数据,涵盖激光打印、酒精湿巾、卫生纸等日用品类目。整个过程的耗时被压缩在十分钟量级,相比人工逆向的效率提升相当明显。
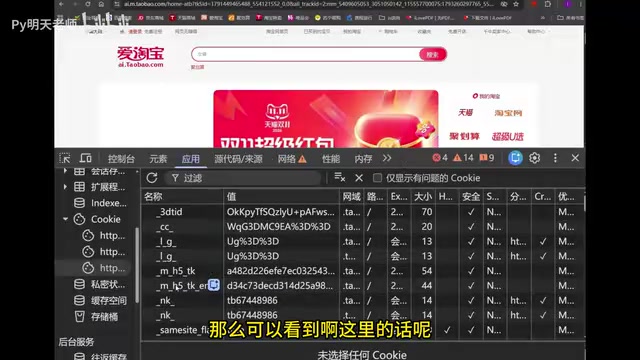
需要客观看待的是,这套方案仍存在边界。演示中明确提到,未登录状态下拿不到完整数据,说明登录态校验依然是绕不开的前提;titter值的动态性也意味着每次会话都需要重新获取。此外,AI在首次分析时并未立刻定位到小框内传递的参数信息,仍需要多轮迭代才能收敛。
从方法论角度看,AI Agent的价值不在于替代对加密算法的理解,而在于把“抓包—定位—环境校验—参数拼接—验证”这条链路自动化,把人的精力从重复调试中解放出来。对于需要长期维护的爬虫项目,将sign生成逻辑沉淀为可复用的skill,比一次性逆向更有工程意义。
对爬虫开发者的启示
这类演示反映出一个趋势:AI正在从代码补全工具,演变为能操作浏览器、调用工具链的任务执行者。逆向分析这种高度依赖经验的工作,正在被拆解为可编排的技能组合。开发者需要重新定位自己的能力重心——从“会扣代码”转向“会设计任务流程、会验证AI输出”。
同时也要注意合规边界。商品数据抓取涉及平台服务条款与数据使用规范,技术可行性不等于使用正当性,实际项目中应优先考虑官方API与授权渠道。
相关推荐
LangChain Agent 不再持有 Stripe 密钥:退款需 Slack 审批
开发者分享 LangChain Agent 凭证管理方案:Agent 不持有 Stripe 密钥,敏感操作如退款通过本地代理转发,并在 Slack 中人工审批后才执行,附代码示例与工程细节。
LangChain真让Agent开发更简单?开发者反思抽象代价
Reddit开发者反思LangChain与LangGraph在多智能体工作流中的抽象代价:入门容易,但StateGraph、状态管理、调试与成本控制带来新复杂度。讨论调试方法、是否混用原生Python+模型SDK,以及生产环境中的经验取舍。
实测TimesFM 3.0、Chronos-2、Toto 2.0:时序大模型跑不赢简单基线
开发者零样本实测TimesFM 3.0、Chronos-2和Toto 2.0在24只美股及ETF上的预测表现,方向准确率仅49.9%-51.1%,模拟交易跑输买入持有策略,时序基础模型在金融数据上未展现超越简单基线的能力。