EvolveTrade:让LLM交易智能体自我进化的策略优化框架
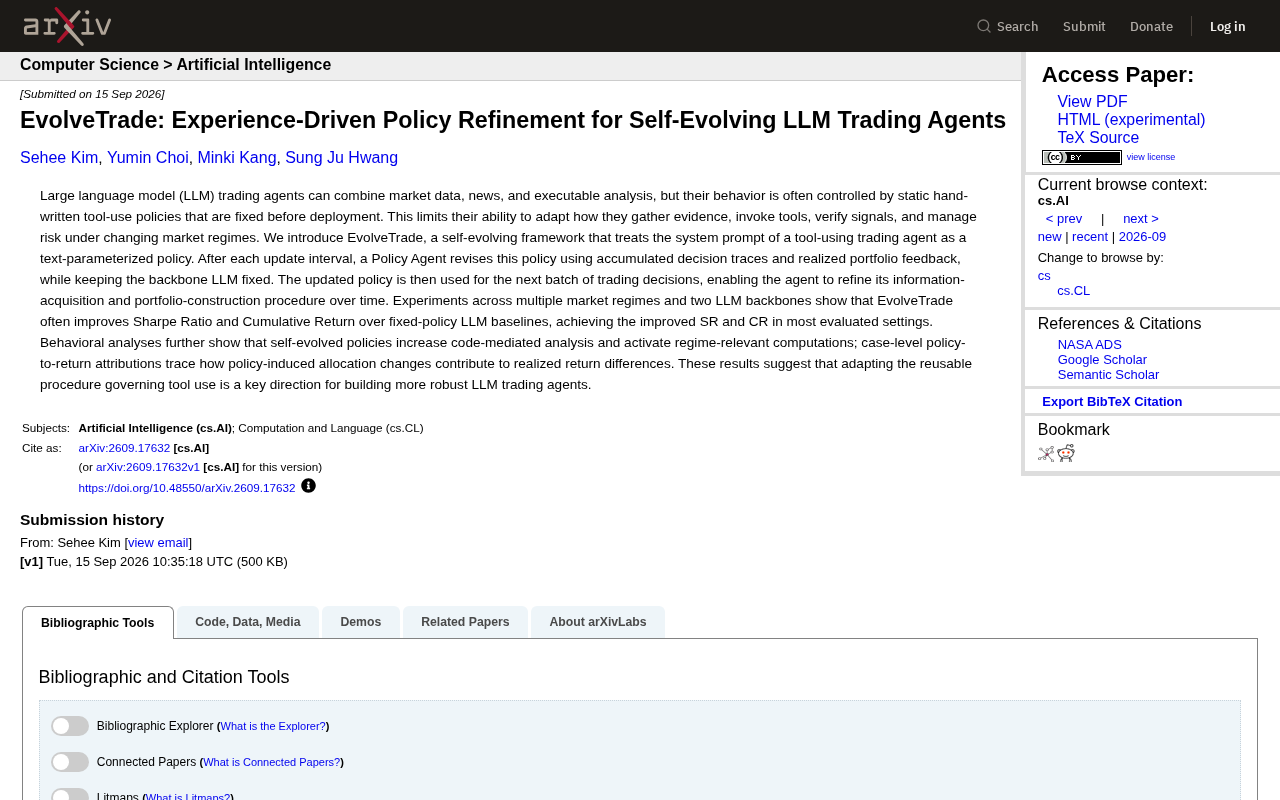
EvolveTrade让交易智能体通过迭代优化系统提示词实现自我进化,无需修改模型权重即可适应不同市场环境。
EvolveTrade是一个针对LLM交易智能体提出的自进化框架,核心思路是将智能体的系统提示词视为可优化的文本参数化策略。在每个更新周期后,专属的"策略智能体"根据积累的决策轨迹与真实投资组合反馈对策略进行修订,使底层LLM在权重完全不变的情况下持续改进工具使用方式。实验在多个市场环境和两种LLM底座上验证了该框架的有效性,结果显示大多数场景下夏普比率与累计收益均优于固定策略基线。行为分析进一步揭示,进化后的策略更倾向于代码驱动的精确计算,能针对不同市场状态激活对应的分析逻辑,并提供可追溯的策略-收益归因,增强了决策的可解释性。
静态策略的困境
大语言模型(LLM)交易智能体近年来展现出独特的优势:它们能够整合市场数据、新闻资讯以及可执行的代码分析,形成一套完整的决策链路。然而,这类智能体存在一个被长期忽视的短板——它们的行为几乎完全由部署前手工编写的、固定不变的工具使用策略(tool-use policy)所控制。
这意味着,无论市场进入牛市、熊市还是高波动的震荡期,智能体收集证据、调用工具、验证信号以及管理风险的方式都保持不变。在瞬息万变的金融市场中,这种僵化的行为模式显然限制了智能体的适应能力。arXiv最新论文提出的 EvolveTrade 框架,正是针对这一痛点给出的解决方案。
把系统提示词当作可进化的策略
EvolveTrade 的核心创新在于一个巧妙的视角转换:它将工具使用型交易智能体的系统提示词(system prompt)视为一个由文本参数化的策略。
传统方法要么依赖人工反复调整提示词,要么需要对模型进行昂贵的微调。EvolveTrade 选择了一条更轻量也更可持续的路径——保持底层 LLM(backbone)完全不变,只让策略本身随时间自我演化。
具体机制是这样运作的:在每个更新周期结束后,一个专门的"策略智能体(Policy Agent)"会介入。它利用这段时间内积累的决策轨迹(decision traces)以及真实的投资组合反馈(realized portfolio feedback),对现有策略进行修订。修订后的新策略随即被应用于下一批交易决策。
通过这样的循环,智能体得以持续打磨自己获取信息和构建投资组合的流程,实现真正意义上的"经验驱动"的自我进化,而不必触碰模型权重本身。
**系统提示词(system prompt)**是部署LLM应用时预先注入的一段指令文本,它定义了模型的角色、行为规范、工具调用方式等核心参数,相当于智能体的"操作手册"。与模型权重不同,系统提示词可以在不重新训练模型的情况下随时修改,这赋予它天然的可塑性。将其视为"策略"而非"配置文件",意味着可以用优化算法对其进行迭代——EvolveTrade正是利用了这一特性,将一个工程实践问题转化为一个可形式化的策略优化问题。这种范式也被称为"提示优化"(prompt optimization),近年来在学术界受到广泛关注,但大多数工作集中于静态任务,将其引入动态金融决策场景是EvolveTrade的关键创新点之一。
实验结果:多数场景下跑赢固定策略基线
研究团队在多个市场环境(market regimes)和两种不同的 LLM 底座上进行了验证。结果显示,EvolveTrade 在大多数被评估的设定中,都能在两项关键指标上超越固定策略的 LLM 基线:
- 夏普比率(Sharpe Ratio, SR):衡量风险调整后收益的核心指标,反映策略在承担单位风险下获得的超额回报。
- 累计收益(Cumulative Return, CR):直接反映策略的整体盈利能力。
论文强调,这种改进并非个别案例,而是在"多数评估设定"中稳定出现,说明自我进化机制具备一定的普适性,而非依赖特定市场或特定模型的偶然表现。
**夏普比率(Sharpe Ratio)**由诺贝尔经济学奖得主威廉·夏普提出,计算公式为策略超额收益(相对于无风险利率)除以收益的标准差。它是量化金融中最广泛使用的风险调整绩效指标之一:夏普比率越高,意味着每承担一单位风险所获得的回报越多。纯粹比较累计收益容易忽视策略的波动性——一个高收益但剧烈波动的策略在实盘中往往难以执行,因为回撤可能触发强制平仓或心理止损。夏普比率与累计收益并列考察,能同时评估策略的"赚钱能力"和"平稳程度",是判断交易策略是否真正优秀的更全面标准。
行为分析:进化后的策略更"懂"计算
除了收益指标,研究者还对进化后的策略行为进行了拆解,得到几个有意思的发现。
更倾向于代码驱动的分析
自我进化后的策略明显增加了**代码中介分析(code-mediated analysis)**的比例。换句话说,智能体学会了更多地通过编写和执行代码来处理量化任务,而不是仅靠语言模型的直觉式推理。这对于金融这类高度依赖精确计算的领域尤为重要。
**代码中介分析(code-mediated analysis)**是指LLM在推理过程中通过生成并执行代码(如Python脚本)来完成计算密集型任务,而非直接用语言输出结论。这类能力在工具增强型LLM框架(如ReAct、ToolFormer等)中已有体现。对于金融场景,纯语言推理在处理技术指标计算、统计检验或投资组合优化时容易产生数值误差,而代码执行能保证计算的精确性和可验证性。进化后的策略主动增加代码调用比例,说明智能体从历史反馈中"学到"了精确计算对改善决策质量的重要性——这是一种元层面的、关于"如何分析"的自我优化,而非仅仅是"分析什么"的调整。
激活与市场环境相关的计算
进化后的策略还会"激活"与当前市场环境相关的特定计算逻辑。这意味着智能体不仅在学习通用技巧,还在针对不同的市场状态调整自己的分析方式——这正是静态策略所无法做到的适应性。
策略到收益的可追溯归因
论文提供了案例级别的**策略-收益归因(policy-to-return attribution)**分析,追踪策略引发的资产配置变化究竟如何贡献于最终的收益差异。这种可解释性对于金融应用至关重要,它让"黑箱"式的智能体决策变得可审计、可理解。
意义与展望
EvolveTrade 传递出的核心信息是:与其反复微调庞大的模型本身,不如让治理工具使用的那套可复用流程实现自我进化,这可能是构建更稳健 LLM 交易智能体的一个关键方向。
这一思路的价值超越了交易场景本身。对于任何依赖工具调用的智能体系统而言,将提示词/策略视为可优化对象、并借助真实反馈闭环持续迭代,都提供了一种低成本、高灵活性的进化范式。当然,作为一篇新发布的研究成果,其在真实资金环境下的鲁棒性、面对极端行情时的表现,以及策略进化可能带来的过拟合风险,仍有待更多验证。
无论如何,EvolveTrade 为"自我进化智能体"这一前沿命题,在金融交易这一高难度、强反馈的战场上,交出了一份值得关注的答卷。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
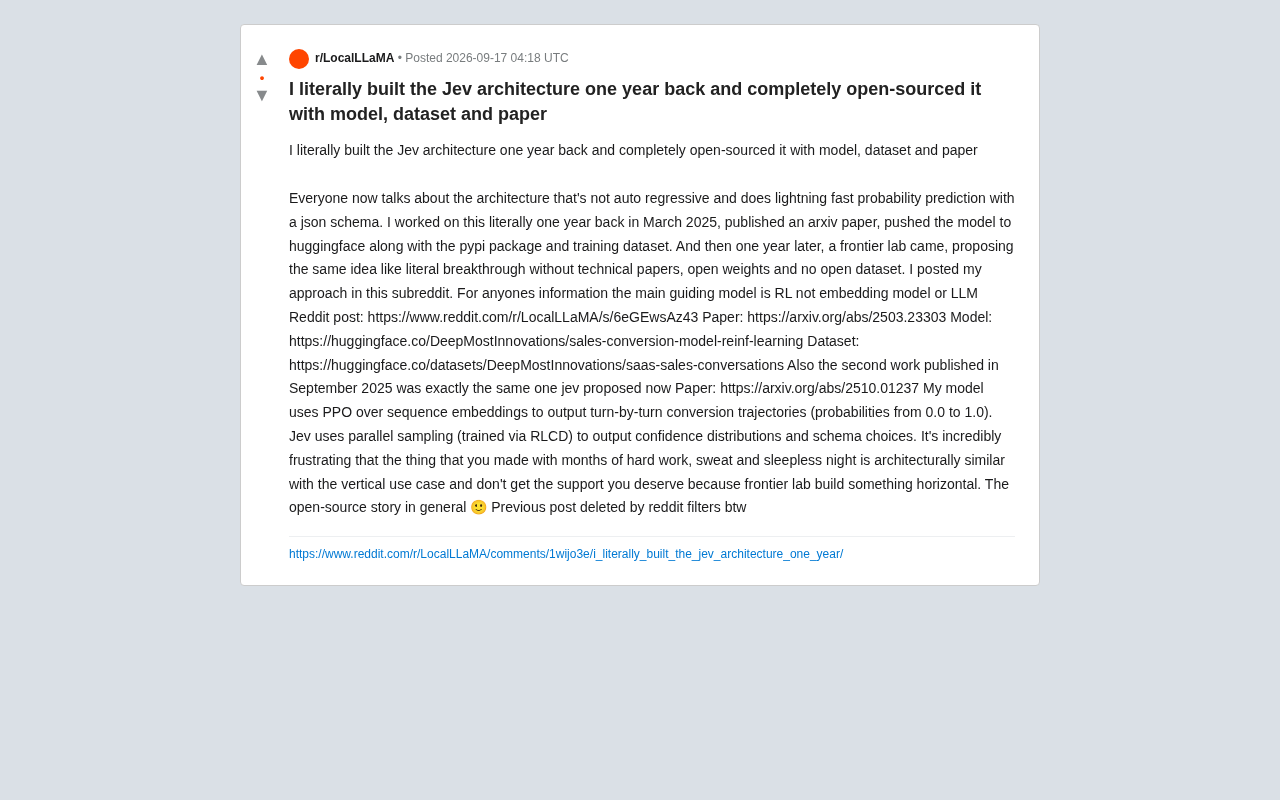
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
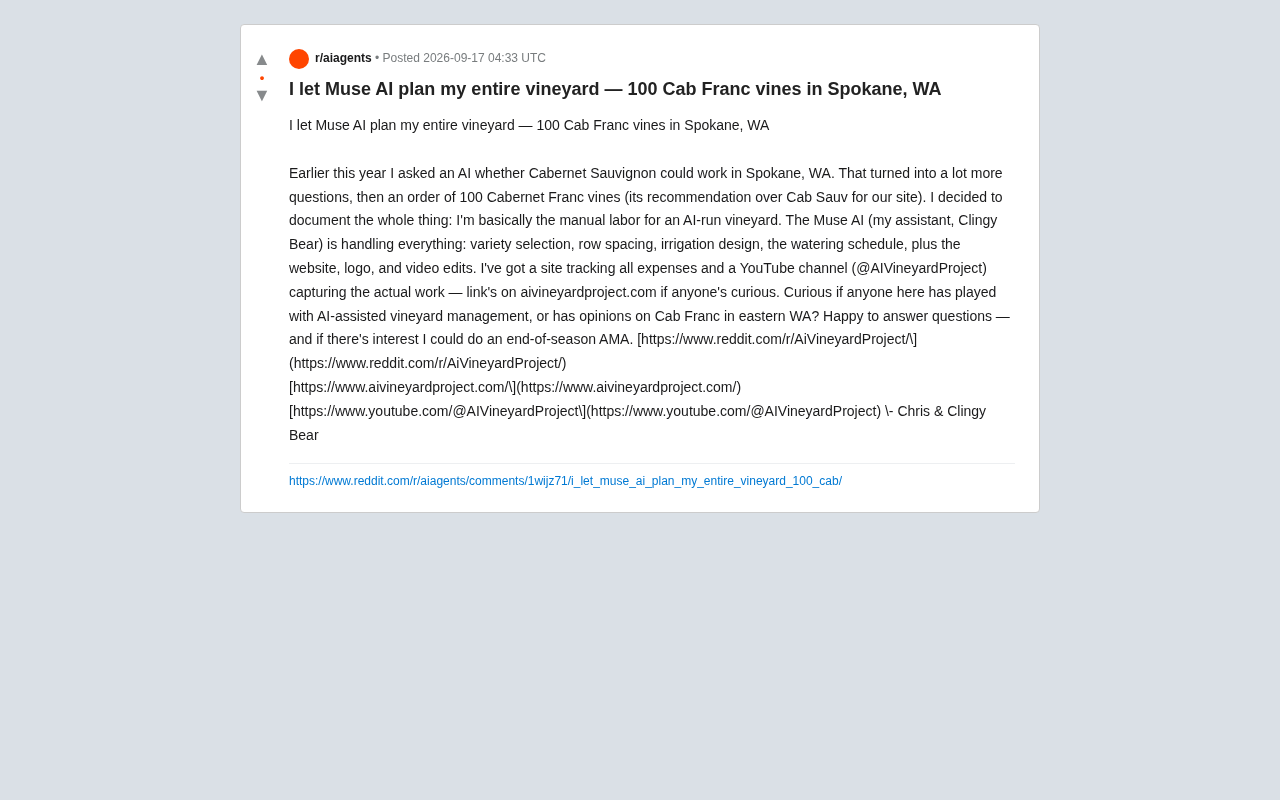
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。