EvoX:把Agent Harness当作运行时策略

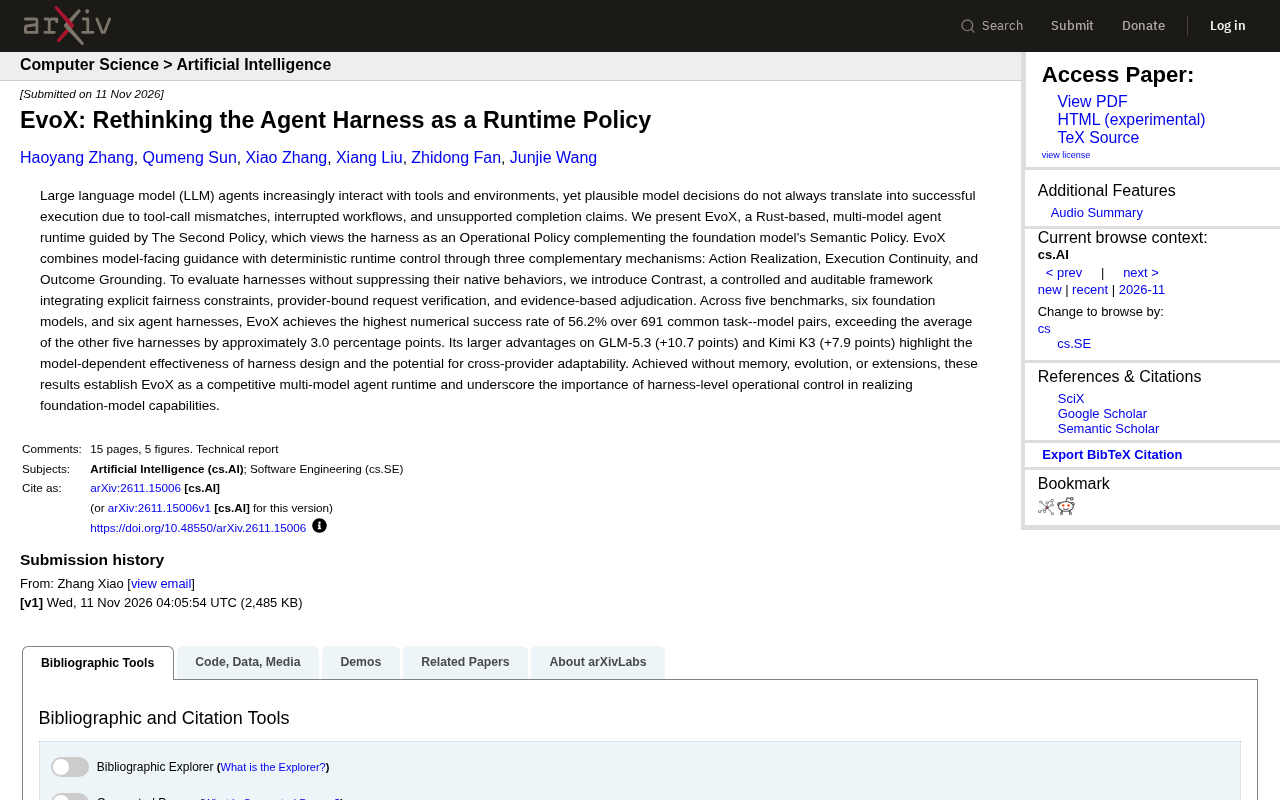
EvoX把Agent Harness视为运行时操作策略,用三机制提升任务成功率约3个百分点。
文章介绍了一项关于EvoX的研究,主张把Agent Harness从工程脚手架重新定位为与模型语义策略互补的“操作策略”。EvoX基于Rust构建,通过Action Realization、Execution Continuity和Outcome Grounding三套机制,分别解决工具调用不匹配、工作流中断和虚假完成声明问题。研究还提出Contrast评测框架,以公平性约束、按提供方绑定的请求校验和证据裁决来避免评测干扰Harness原生行为。实验覆盖五个基准、六个模型和六个Harness,在691个任务—模型组合上取得56.2%的最高成功率,平均领先其他Harness约3.0个百分点,且在GLM-5.3和Kimi K3上分别领先10.7和7.9个百分点,显示提升具有模型依赖性。
大型语言模型(LLM)智能体(Agent)正越来越频繁地与外部工具和环境交互,但模型做出看似合理的决策,并不总能转化为成功的执行。工具调用不匹配、工作流中断,以及模型声称完成却未真正完成任务,这些情况在真实运行中屡见不鲜。一篇来自rss的研究提出了EvoX,试图从运行时层面重新思考Agent Harness的角色。
Harness不只是壳:从“语义策略”到“操作策略”
EvoX的核心观点是“The Second Policy”:把Agent Harness视为一种操作策略(Operational Policy),与基础模型自身的语义策略(Semantic Policy)形成互补。换句话说,模型负责理解意图和规划,而Harness负责把意图可靠地落到执行层。
这一区分有现实意义。模型输出的是“打算做什么”,而执行需要处理参数格式、工具接口限制、调用顺序和状态延续等细节。EvoX基于Rust构建,是一个多模型Agent运行时,通过面向模型的引导与确定性的运行时控制相结合,来弥补语义策略与执行结果之间的缝隙。
Agent Harness 指的是包裹在基础模型之外、负责驱动智能体完成任务的一整套运行时基础设施,通常包括提示编排、工具调用的解析与执行、上下文与状态管理、错误重试以及循环控制等。它决定了模型的文本输出如何被转化为具体的函数调用、文件操作或网络请求。在早期的Agent实践中,Harness常被视为“工程脚手架”,关注点集中在能不能跑通;而EvoX的论点是把Harness本身当作一个可研究、可设计的策略层——它不只是被动转发模型的意图,而是主动约束和修正执行细节。这一视角的转变意味着,同一个基础模型搭配不同Harness可能产生显著不同的任务成功率,Harness因此成为独立于模型权重之外的性能变量。
三套机制:让决策真正落地
EvoX通过三个互补机制实现操作策略:
- Action Realization(动作实现):把模型的意图映射为符合工具约束的实际调用,减少工具调用不匹配。
- Execution Continuity(执行连续性):在中断和异常场景下维持工作流推进,避免任务半途而废。
- Outcome Grounding(结果接地):以可验证的证据支撑完成声明,抑制“声称完成但实际未完成”的行为。
这三个机制分别对应工具调用、流程连贯性和结果核验,恰好覆盖了Agent执行链路中最容易失真的环节。
Outcome Grounding(结果接地) 中的“接地”借用自NLP与知识表示领域的grounding概念,指把抽象或符号化的陈述锚定到可观察、可验证的现实证据上。在Agent场景中,模型可能生成“已完成任务”的声明,但该声明未必对应真实的环境状态变化。结果接地要求完成声明必须附带可核验的证据,例如工具返回的成功状态码、文件系统变更、测试通过记录或外部API的确认响应。若缺乏证据,运行时可以拒绝接受该声明并触发补救动作。这一机制针对的是LLM常见的“过度自信”与“幻觉式完成”,把自然语言层面的自我报告替换为基于环境反馈的客观判定,从而让任务完成状态不再依赖模型的自我评估。
Contrast:不压制原生行为的评测框架
评测Harness有一个难点:评测方式本身可能干扰被评测对象的原生行为。为此,研究引入了Contrast,一个可控、可审计的评测框架,包含显式公平性约束、按提供方绑定的请求校验,以及基于证据的裁决。
这种设计的目的,是让不同Harness在相对公平的条件下展示自身特性,而不是被评测框架“规训”成同一种行为模式。对于多模型、多Harness的横向比较,这一点尤为关键。
Agent Harness评测 的公平性难题在于:评测框架若对请求格式、重试策略或工具集合作过多统一规定,就会抹平各Harness的设计差异,使比较退化为对评测框架适配度的测量。Contrast采用“按提供方绑定的请求校验”,即为每个模型提供方维护其要求的请求结构,避免因格式不兼容而把本属工程适配的问题误判为能力缺陷;同时以证据为基础的裁决取代人工或启发式打分,降低评分者的主观偏差。这种“可控且可审计”的设计思路,与软件工程中的可复现构建理念相近——评测结论应能由第三方依据记录复现,而非依赖未公开的私有流程。
实验结果:56.2%成功率与模型依赖效应
实验覆盖五个基准、六个基础模型和六个Agent Harness。在691个共同的任务—模型组合上,EvoX取得了56.2%的最高数值成功率,比其他五个Harness的平均值高出约3.0个百分点。
更值得关注的是差异化的提升幅度:在GLM-5.3上领先10.7个百分点,在Kimi K3上领先7.9个百分点。这说明Harness设计的有效性是模型依赖的,也提示了跨提供方适配的潜力。你可能没注意到,这些结果是在没有使用记忆、进化或扩展机制的情况下取得的,说明提升主要来自运行时层面的操作控制,而非额外的能力堆叠。
意义与局限
EvoX的价值在于把Harness从“工程脚手架”提升为“运行时策略”的研究对象,并用可审计的评测方法验证其效果。它提醒我们,基础模型的能力上限与实际任务成功率之间,仍有一段由运行时控制决定的距离。
同时也要看到,3.0个百分点的平均优势并不算悬殊,且不同模型上的增益差异明显,说明Harness设计需要针对模型特性进行调整。EvoX是否能推广到更多工具生态和更长程的任务,仍有待进一步验证。
相关推荐
接近50磅就送车?YouTube挑战背后的Whatnot营销
解析YouTube热门挑战“接近50磅赢汽车”的玩法设计,探讨其如何为直播平台Whatnot引流,以及重量竞猜类内容为何能吸引观众并实现商业转化。
《以撒的结合》开发者移除AI音乐,Steam差评风波平息
《以撒的结合:忏悔+》因使用AI音乐遭Steam差评轰炸,开发者已移除相关曲目。本文回顾事件经过,分析玩家对AI替代人类创作的焦虑,探讨游戏行业使用AI内容的透明度与信任成本问题。

数据中心为何成为大科技公司遭遇反弹的中心?
科技记者 Paris Marx 新书《Hyperscale》揭示数据中心如何成为大型科技公司遭遇反弹的核心。从资源成本、环境影响到政策博弈,本文分析数据中心从技术设施演变为政治议题的过程及其对行业的启示。