ExecuTorch WebGPU:PyTorch模型直接在浏览器GPU上运行
ExecuTorch 新增 WebGPU 后端,PyTorch 模型无需转换即可在浏览器 GPU 运行。
PyTorch 官方博客宣布 ExecuTorch 支持 WebGPU 后端,开发者现在可以直接在浏览器中利用 GPU 运行 PyTorch 模型,无需转换为 ONNX 等其他框架格式。整个流程以 torch.export 导出 .pte 文件为起点,该文件由浏览器内的 ExecuTorch 运行时加载,WebGPU 后端负责 GPU 加速执行。这一更新补齐了 PyTorch 生态在 Web 部署的关键一环,带来隐私保护、低延迟和降低服务端 GPU 成本等优势,同时强化了从训练到部署的端到端生态闭环。不过,浏览器显存限制、WebGPU 兼容性差异以及算子覆盖范围仍是实际落地时需要验证的边界。
PyTorch 官方博客发布了一项重要更新:ExecuTorch 现已支持 WebGPU 后端,开发者可以直接在浏览器中利用 GPU 运行 PyTorch 模型,无需将模型转换为其他框架的格式。这一进展为 PyTorch 生态的 Web 部署补齐了关键一环。
核心机制:从 torch.export 到 .pte 文件
整个流程的起点是 torch.export,它负责将 PyTorch 模型导出为 ExecuTorch 专用的 .pte 文件。这个文件格式是 ExecuTorch 运行时的标准载体,包含了模型的计算图与权重信息。导出的 .pte 文件随后被加载到浏览器环境中的 ExecuTorch 运行时,由 WebGPU 后端负责在 GPU 上执行计算。
与传统 Web 部署方案(如将模型转成 ONNX 再用 ONNX Runtime Web 运行)相比,这条路径的最大差异在于“不换框架”。模型从训练到部署始终留在 PyTorch 体系内,避免了跨框架转换可能带来的算子兼容性问题和精度损失。
torch.export 是 PyTorch 2.x 引入的模型导出 API,用于将模型转换为可移植的计算图表示。它通过追踪模型的前向执行,生成一个静态的 ExportedProgram,其中包含计算图、参数和元数据。与早期的 TorchScript 相比,torch.export 提供了更严格的图捕获机制,能更好地保留动态形状信息,并支持后续的编译器优化。ExecuTorch 正是基于 torch.export 产出的中间表示,进一步 lowering 并序列化为 .pte 文件。
.pte 文件 是 ExecuTorch 的运行时包格式,本质上是一个 FlatBuffer 序列化文件,内部存储了模型的计算图结构、权重张量、算子内核绑定信息以及内存规划方案。这种格式设计为轻量且可增量加载,适合资源受限的终端设备。浏览器中的 ExecuTorch 运行时可以直接解析 .pte 文件,而无需依赖 Python 环境或完整的 PyTorch 库,从而实现纯前端的模型执行。
为什么 WebGPU 是关键拼图
WebGPU 是新一代 Web 图形与计算 API,相比 WebGL 提供了更底层的 GPU 访问能力和更现代的计算着色器模型。对于深度学习推理而言,这意味着可以更充分地利用浏览器所在设备的 GPU 算力,而不必退回到 CPU 执行或依赖服务端推理。
ExecuTorch 本身是 PyTorch 面向边缘与终端设备的推理运行时,覆盖移动端、嵌入式设备等场景。WebGPU 后端的加入,把浏览器也纳入了 ExecuTorch 的目标平台版图,使同一套导出产物有机会在更多终端上复用。
WebGPU 是由 W3C GPU for the Web 工作组制定的标准,旨在为 Web 提供现代 GPU 加速能力。与 WebGL 不同,WebGPU 直接映射到 Vulkan、Metal 和 Direct3D 12 等底层图形 API,支持计算着色器(compute shader)和存储缓冲区(storage buffer),使得通用 GPU 计算在浏览器中成为可能。在深度学习推理中,WebGPU 允许将矩阵乘法、卷积等算子映射为计算着色器,从而利用 GPU 的大规模并行性。
WebGL 虽然也能进行 GPU 计算,但其设计初衷是图形渲染,缺乏对通用计算的原生支持,通常需要将计算编码为纹理渲染技巧,导致算子实现复杂且效率受限。WebGPU 的计算管线更贴近 CUDA 或 Metal,为 ExecuTorch 这类推理运行时提供了更直接的硬件访问路径。
对开发者的实际意义
最直接的价值是隐私与延迟。推理完全在浏览器本地完成,用户数据无需上传到服务器,同时省去了网络往返带来的延迟。对于需要实时交互的 AI 应用(如浏览器内的图像处理、文本生成辅助工具等),本地 GPU 推理能显著改善响应体验。
其次是部署成本的降低。服务端推理需要承担 GPU 资源开销,而将计算下沉到客户端后,这部分成本转移到了用户设备上。对于用户量较大的应用,这是一种值得考虑的架构选择。
不过,浏览器 GPU 推理也有其边界:可用显存受限于用户设备,不同浏览器与硬件对 WebGPU 的支持程度存在差异,模型体积和计算量仍需针对 Web 场景做适配。
生态层面的信号
PyTorch 官方以“无需转换到其他框架格式”作为核心卖点,这透露出其在部署链路上的策略取向——强化端到端的自有生态闭环。对已经在 PyTorch 上构建训练流程的团队来说,Web 端部署不再需要额外维护一条格式转换流水线,工程复杂度随之下降。
ExecuTorch WebGPU 目前仍处于早期推进阶段,具体的算子覆盖范围、性能表现和浏览器兼容矩阵,还需要开发者在实际项目中验证。但方向已经明确:PyTorch 模型跑在浏览器 GPU 上,正在从概念走向可用的工程路径。
ExecuTorch 是 PyTorch 基金会主导的端侧推理运行时,目标是在移动端(Android/iOS)、嵌入式系统和浏览器等边缘设备上执行 PyTorch 模型。它采用分层架构:前端接收 torch.export 导出的图,经过一系列图优化和算子分解,最终由后端(如 XNNPACK、Core ML、Vulkan、WebGPU)负责内核执行。WebGPU 后端的加入,使得 ExecuTorch 的后端矩阵覆盖了从 CPU 到 GPU 的多种硬件,进一步巩固了 PyTorch 在端到端部署链路中的统一性。
相关推荐
Anthropic新模型Fable 5.2实测:性能超Opus 5.5
Anthropic 发布 Fable 5.2,实测性能超越 Opus 5.5,单 token 更贵但单位任务成本更低。本文整理发布要点、公开基准、自建基准与三项实测,并给出模型选型建议。
OpenAI 谈数据中心公关危机与 AI 监管自我约束
OpenAI 高管访谈解读:AI 数据中心为何遭遇公关危机,以及 OpenAI 为何支持以「限速」框架监管递归自我改进,强调人类必须掌控 AI 技术。
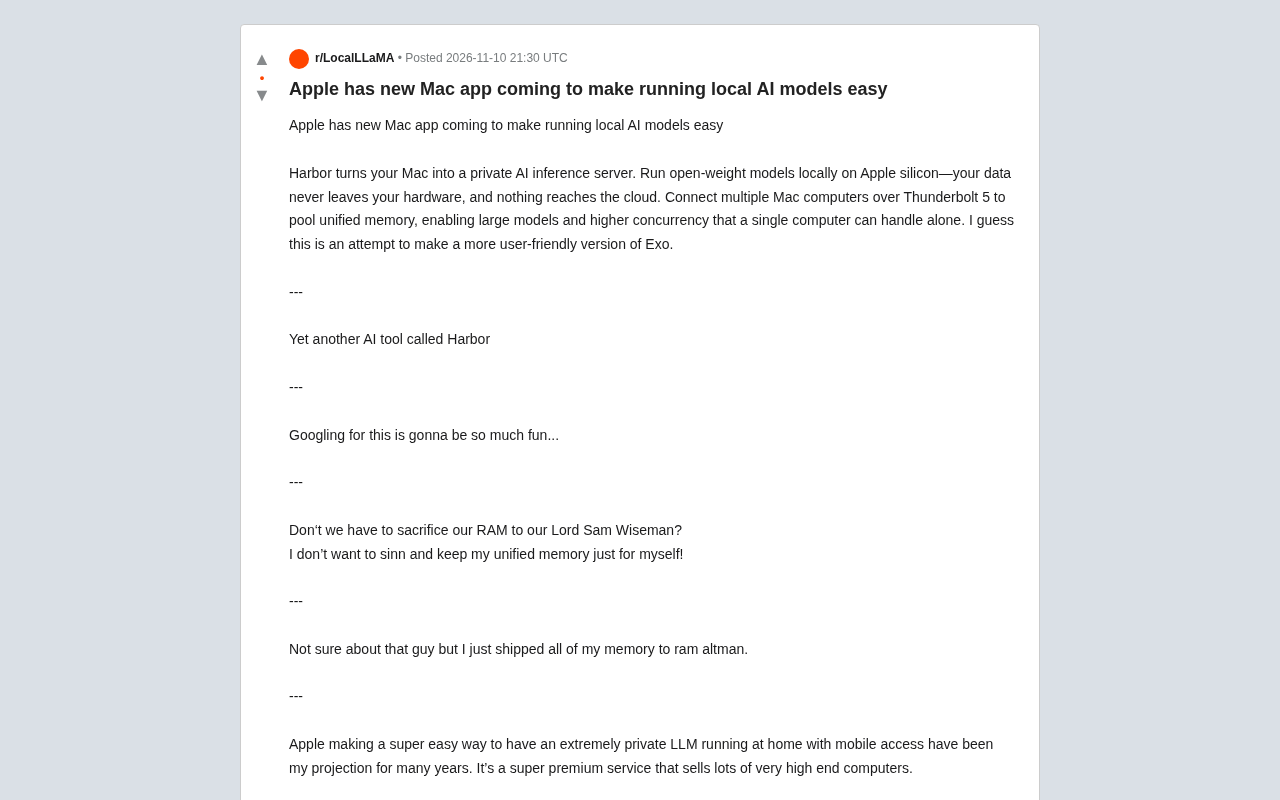
苹果新Mac应用Harbor:本地AI推理与雷雳5集群
苹果新Mac应用Harbor曝光:把Mac变成私有AI推理服务器,通过雷雳5连接多台Mac池化统一内存运行大模型。本文解析其功能、与Exo和LM Studio的差异,以及本地AI生态影响。