Anthropic新模型Fable 5.2实测:性能超Opus 5.5
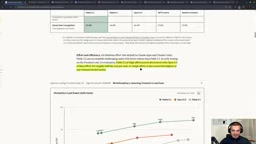
Anthropic 推出 Fable 5.2 与 Mythos 5.2,以更快更省的方式超越自家 Opus 5.5,登顶多项基准。
Anthropic 在 Opus 5.5 仍领先的情况下推出 Fable 5.2 和 Mythos 5.2,打破「最强模型必被对手超越」的行业惯例。两款模型共享同一底层,Fable 额外增加生物学与网络安全防护。官方称 Fable 5.2 输出速度提升最高 30%,单 token 价格约为 Opus 5.5 的两倍,但高努力模式下单位任务成本仅为其一半。它在 Artificial Analysis 智能指数和 LMArena ELO 中均居首,自建 yapping 基准显示其回答最简洁。MOBA 原型、NumPy 卷积网络可视化和权重空间编程三项实测中,Fable 5.2 在代码质量与架构理解上明显优于 Opus 5.5。作者建议其定位为重载咨询场景的补充,而非日常主力。
Anthropic 在已经拥有 Opus 5.5 这款长期领先模型的情况下,又推出了 Fable 5.2 和 Mythos 5.2。据 YouTube 频道分析,这打破了 AI 行业「一家公司推出最强模型后被对手超越」的惯例——OpenAI 近期没有发布有竞争力的新模型,而 Anthropic 选择用更强的模型超越自己。
发布要点:更快的速度与更低的单位任务成本
Fable 5.2 和 Mythos 5.2 本质上是同一底层模型,区别在于 Fable 增加了针对生物学和网络安全的防护措施。官方宣称 Fable 5.2 生成输出比上一代 Fable 快最高 30%,价格也更低。
值得关注的是定价逻辑:Fable 5.2 的单 token 成本大约是老款 Opus 5.5 的两倍,但 Anthropic 声称在「高努力」模式下,Fable 5.2 能达到 Opus 5.5「最大努力」的性能,同时每个任务的成本约为后者的一半。也就是说,模型靠更快完成任务抵消了更高的 token 单价。
Anthropic 给出的使用建议也值得参考:日常开发仍推荐 Opus 5.5 作为主力,遇到极高复杂度任务再升级到 Fable,简单任务则下探到 Sonnet 或 Haiku。这说明 Fable 的定位是「重载场景的补充」,而非全面替代。
单 token 成本与单位任务成本是两个不同层面的指标。前者是 API 计价的基本单位,即每百万输入/输出 token 的价格;后者则把模型在一次完整任务中消耗的 token 总量与单价相乘。一个单价更高但输出更短、推理更快的模型,其单位任务成本可能反而更低。这正是 Anthropic 定价叙事的核心:Fable 5.2 虽然 token 单价翻倍,但靠减少冗余输出和加速完成,把「办成一件事」的总花费压到 Opus 5.5 的一半左右。评估模型性价比时,应以单位任务成本而非 token 单价为准。
公开基准:多数榜单领先
在 Artificial Analysis 的智能指数上,Fable 5.2 位列榜首,超过了 Opus 5.5 以及 Gemini 系列的部分型号。在 LMArena 的 ELO 人类偏好评分中,该模型同样拿到列表中的最高分。
视频作者也指出,官方发布页通常只展示优势项目,但切换到其他独立基准后,Fable 5.2 的领先地位仍然成立。这意味着性能提升不是单个榜单的偶然结果。
Artificial Analysis 智能指数是由独立评测机构 Artificial Analysis 维护的综合基准,它把多个主流评测(如 MMLU、GPQA、HumanEval 等)的分数归一化后加权汇总为一个 0-100 的指数,用于横向比较不同厂商模型的通用能力。由于它不依赖厂商自报数据,常被视为相对中立的参考。LMArena(原 Chatbot Arena) 则采用众包盲测方式:用户对两个匿名模型的同一回答投票,系统用 Elo 等级分算法(类似国际象棋排名)估算模型的人类偏好强度。两者互补——前者偏客观题,后者偏主观体验,因此同时登顶更能说明提升不是单一维度的偶然。
自建基准:更少「废话」的 Claude
视频作者开发了一套「yapping benchmark」,专门衡量模型回答的冗余程度,包括长度、套话短语、格式和排版四个维度。Fable 5.2 在该基准中得分很低,意味着回答更简洁。
在短语维度上,它几乎不使用「你说得对」「你完全有理由不满」之类的典型 AI 套话;在长度维度上,它也是 Claude 系列中最简洁的型号。作者对比了 Opus 5.5 和 Fable 5.2 对同一问题的回答,后者明显更短、更少废话。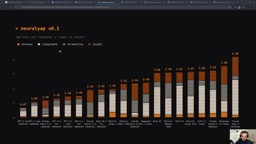
这种风格差异对实际使用体验影响很大,尤其是需要快速获取信息而非阅读长篇解释的场景。
实测一:MOBA 原型与代码质量
作者用同一个提示词要求各模型构建一个简化版 MOBA 原型,包含移动、普攻和四个技能。Fable 5.2 生成的版本动画最完整、运行最流畅,明显优于 DeepSeek广告 和 Opus 5.5 的结果。
更关键的差异在代码风格。左侧 Fable 5.2 生成的代码结构清晰、间距合理、使用了模块化的类,读起来像人类工程师写的;右侧 Opus 5.5 的代码则被作者形容为「典型的复制粘贴 AI 产物」,注释冗余、结构混乱。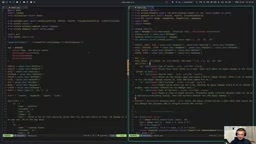
作者也坦承,测试用的是 Ursina 这个冷门 Python 游戏引擎,所以所有模型的表现都打了折扣,但相对差距依然明显。
实测二:纯 NumPy 卷积网络教学可视化
第二个实验要求模型从零用 NumPy 实现卷积神经网络并在 MNIST 上训练,同时提供完整的教学可视化。
Fable 5.2 的结果是作者认为最好的:它优先展示网络结构本身,输入、卷积核、池化层、展平、全连接、Softmax 逐层可见,训练时还能观察损失函数和权重的变化过程,并且能回溯某个输出对应的输入来源。相比之下,Kimi K3.1 Pro 和 Opus 5.5 的结果虽然也能跑通,但界面更像「一堆东西同时发生」,教学价值有限。代码层面同样延续了上一项实验的差异:Fable 5.2 的代码模块化程度更高、更易读。
实测三:权重空间编程
作者还测试了「权重空间编程」——让模型直接手写神经网络权重而不经过梯度下降。在 Breakout 游戏任务中,GPT-6 Astra 此前取得平均 517 分,Opus 5.5 在作者的测试中只有 200 多分,而 Fable 5.2 达到了 493 分。
Fable 5.2 的表现已经接近 Astra,且分数分布很宽,部分运行能到 600 甚至 700,但也有极低值。作者强调,模型是在没有工具、没有互联网访问的情况下,仅凭对架构的描述手工写出所有权重数值,然后直接运行游戏脚本验证效果。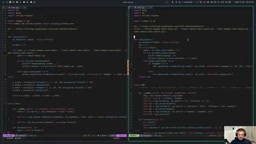
这一结果说明模型对神经网络内部结构的理解能力有了实质提升,而不仅是表面性能的优化。
权重空间编程(weight-space programming)指不依赖反向传播和梯度下降,直接为神经网络手动指定每一个权重数值,使网络在未训练的情况下完成任务。传统训练是通过数据迭代调整参数,而权重空间编程要求模型理解「什么样的权重组合会产生什么行为」,相当于对网络内部计算机制进行逆向推理。它对模型的抽象推理和数值直觉要求极高,因此常被用作探测模型是否真正「理解」神经网络结构的压力测试,而非单纯的代码生成能力。
结论:如何选择
作者认为 Fable 5.2 是目前最强的模型,但不会把它当作日常主力。他的建议是:Opus 5.5 继续作为默认选择,前端等较轻任务用 Sonnet,极低成本场景用 Haiku,而 Fable 5.2 留给代码审查、架构评估、合同条款分析这类需要大局观和高复杂度的场景。
从竞争格局看,作者认为 Anthropic 目前是前沿实验室中发布节奏最活跃的一家,OpenAI 近期缺乏动作,Gemini 是唯一值得关注的对手。对于开发者而言,Fable 5.2 的价值不在于取代 Opus,而在于提供了一个「重载咨询」选项——按任务成本计算,它可能比看起来更划算。
相关推荐
OpenAI 谈数据中心公关危机与 AI 监管自我约束
OpenAI 高管访谈解读:AI 数据中心为何遭遇公关危机,以及 OpenAI 为何支持以「限速」框架监管递归自我改进,强调人类必须掌控 AI 技术。
ExecuTorch WebGPU:PyTorch模型直接在浏览器GPU上运行
PyTorch 发布 ExecuTorch WebGPU 支持,模型经 torch.export 导出为 .pte 文件后可直接在浏览器 GPU 上推理,无需转换为其他框架格式,兼顾本地隐私与低延迟部署。
苹果新Mac应用Harbor:本地AI推理与雷雳5集群
苹果新Mac应用Harbor曝光:把Mac变成私有AI推理服务器,通过雷雳5连接多台Mac池化统一内存运行大模型。本文解析其功能、与Exo和LM Studio的差异,以及本地AI生态影响。