FAB金融尽调基准:AI Agent能胜任财务尽职调查吗?

前EY团队开源FAB基准,揭示AI Agent能检索财务事实却难以完成端到端尽调分析的能力边界。
FAB(Finance Agents Benchmark)是由前安永员工团队构建的财务尽职调查专项评测基准,旨在以贴近真实咨询工作流的方式考察AI Agent的能力极限。测试让Agent在模拟数据室中完成多步骤任务——定位文件、抽取事实、综合分析。核心发现是:当前AI在信息检索层已相当可用,但一旦任务需要跨文档整合与长链条逻辑推理,可靠性明显下降,距离合格分析师的"端到端交付"标准仍有差距。基准代码与数据集已在GitHub和Hugging Face完全开源,团队因成本原因采取分阶段扩展策略。对金融AI落地的实践启示是:检索辅助可交给Agent,综合判断与最终结论仍须人类专家把关。
AI能否接手金融尽职调查这门苦活?
全球经济运转的背后,是大量复杂而繁琐的财务工作。财务尽职调查(Financial Due Diligence)正是其中最考验专业能力的环节之一——分析师需要从堆积如山的财报、合同和数据室文件中提取关键事实,并将它们串联成一份完整、可靠的判断。这类工作长期被视为高度依赖人类专业经验的领域。
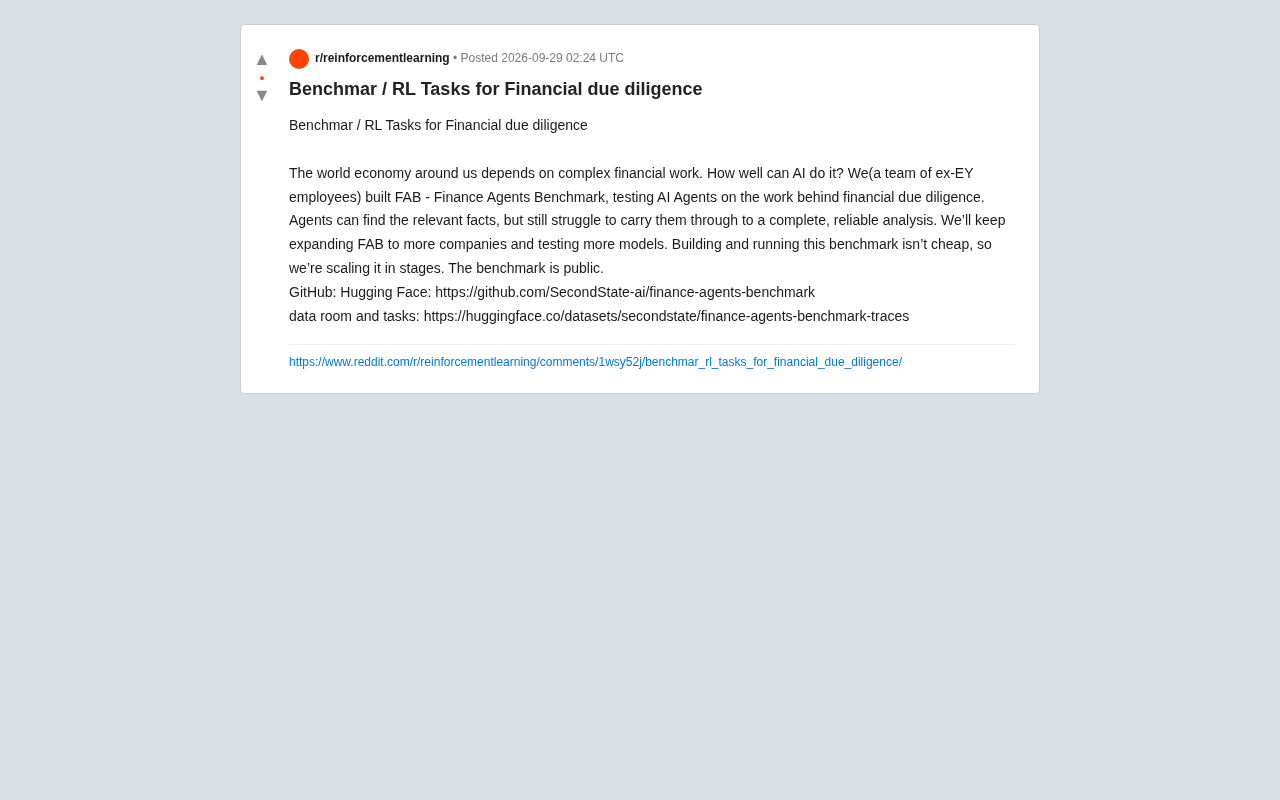
那么,如今的AI Agent究竟能把这件事做到什么程度?一支由前安永(EY)员工组成的团队给出了他们的答案:他们构建了 FAB(Finance Agents Benchmark,金融智能体基准),专门用于测试AI Agent在真实财务尽调工作流中的表现。
FAB测试了什么,又发现了什么?
FAB的核心目标,是把财务尽职调查背后的实际工作拆解成可评估的任务,让AI Agent在其中接受检验。测试内容并非简单的问答,而是模拟真实咨询场景下的多步骤分析:Agent需要在数据室(data room)中定位相关材料,抽取事实,并基于这些事实完成分析推理。
团队给出的关键结论颇具启发性:Agent能够找到相关事实,但在把这些事实贯穿到一份完整、可靠的分析中时仍然吃力。换句话说,当前的AI在“信息检索”这一层已经相当可用,但在“综合判断与端到端交付”这一层,距离一名合格的尽调分析师还有明显差距。
这一发现与业界对大模型Agent能力的普遍观察相互印证:模型擅长局部、原子化的任务,但一旦任务链条拉长、需要跨文档整合与保持逻辑一致性时,可靠性就会下降。财务尽调恰恰是这类长链条、高一致性要求的典型场景,因此成为检验Agent真实水平的一块试金石。
数据室(Data Room) 是财务尽职调查中的核心概念,指买方或第三方顾问在交易过程中访问的受控文件集合,通常包含目标公司的财务报表、审计报告、重要合同、法律文件、管理层陈述材料等。传统数据室为实体场所,现代交易中普遍采用虚拟数据室(VDR)以电子形式组织和共享这些敏感文件。对AI Agent而言,数据室模拟了真实的信息检索环境:文件数量庞大、格式多样(PDF、Excel、扫描件等),且关键信息往往分散在多份文档的不同位置,需要跨文档交叉比对才能得出可信结论。FAB的测试难度正源于此——Agent不仅要读懂单份文件,还要在整个数据室中定位、整合、核验信息。
为什么由前EY团队来做这件事?
值得关注的是构建这一基准的团队背景——他们是前安永员工。四大会计师事务所的从业者最清楚尽职调查的真实工作流长什么样:哪些文件重要、分析该如何组织、结论需要经过怎样的交叉验证才算可靠。
这种领域专业性对基准质量至关重要。金融领域的AI评估最容易犯的错误,是用过于简化或脱离实务的任务去衡量模型,得出与真实业务无关的“漂亮分数”。由懂行的人来设计任务和数据室,能让FAB更贴近实际交付标准,评估结果也更有参考价值。
安永(Ernst & Young,EY)是全球"四大"会计师事务所之一(其余三家为德勤、普华永道和毕马威)。四大在全球并购、上市、私募股权投资等重大交易中承担大量财务尽职调查工作,其方法论高度标准化且经过长期实践检验。典型的财务尽调报告会涵盖收入质量分析(Quality of Earnings)、营运资本正常化、负债识别、会计政策评估等模块,每项结论背后都需要追溯至具体单据或政策依据。正因为四大从业者深度参与过数百乃至数千份尽调项目,他们对"什么样的AI输出是可用的、什么样的是危险的"有远比学术研究者更直观的判断,这使得由他们设计的评估标准更贴近真实交付质量门槛,而非单纯的信息抽取准确率。
公开、可复现,但成本不菲
FAB采用完全公开的策略,代码与数据均已开源:
- GitHub 代码仓库:https://github.com/SecondState-ai/finance-agents-benchmark
- 数据室与任务集(Hugging Face):https://huggingface.co/datasets/secondstate/finance-agents-benchmark-traces
开源意味着任何研究者和开发者都可以复现测试、验证结论,或将自己的Agent接入评测。这对于一个专业垂直领域的基准来说是难得的透明度。
团队也坦言,构建和运行这样的基准并不便宜。因此他们选择分阶段扩展:逐步覆盖更多公司、测试更多模型。这种务实的路线一方面反映了高质量金融评测的真实成本(数据准备、任务标注、多轮模型运行都需要大量投入),另一方面也说明FAB是一个持续演进的项目,而非一次性的成果。
对AI Agent落地金融行业的启示
FAB的价值不只在于给出一个分数,更在于它清晰地划出了当前能力的边界。对于希望把AI引入金融尽调、审计或投研的团队来说,这里有几点现实的参考:
- 检索与信息定位可以放心交给Agent辅助,能显著提升效率;
- 综合分析与最终结论仍需人类专家把关,不能盲目信任端到端输出;
- 评估AI在专业领域的能力时,应使用贴近真实业务的基准,而非通用榜单。
随着FAB覆盖的公司和模型不断增加,它有望成为衡量金融Agent进步的一把标尺。而它当前揭示的“找得到事实、做不好分析”这一状态,也为下一阶段的模型训练与Agent设计指明了发力方向:如何让Agent在长链条任务中保持逻辑连贯与结论可靠,将是攻克金融专业场景的关键。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。