Fable 5.2与Mythos 5.2服务故障:四分钟过载后已解决
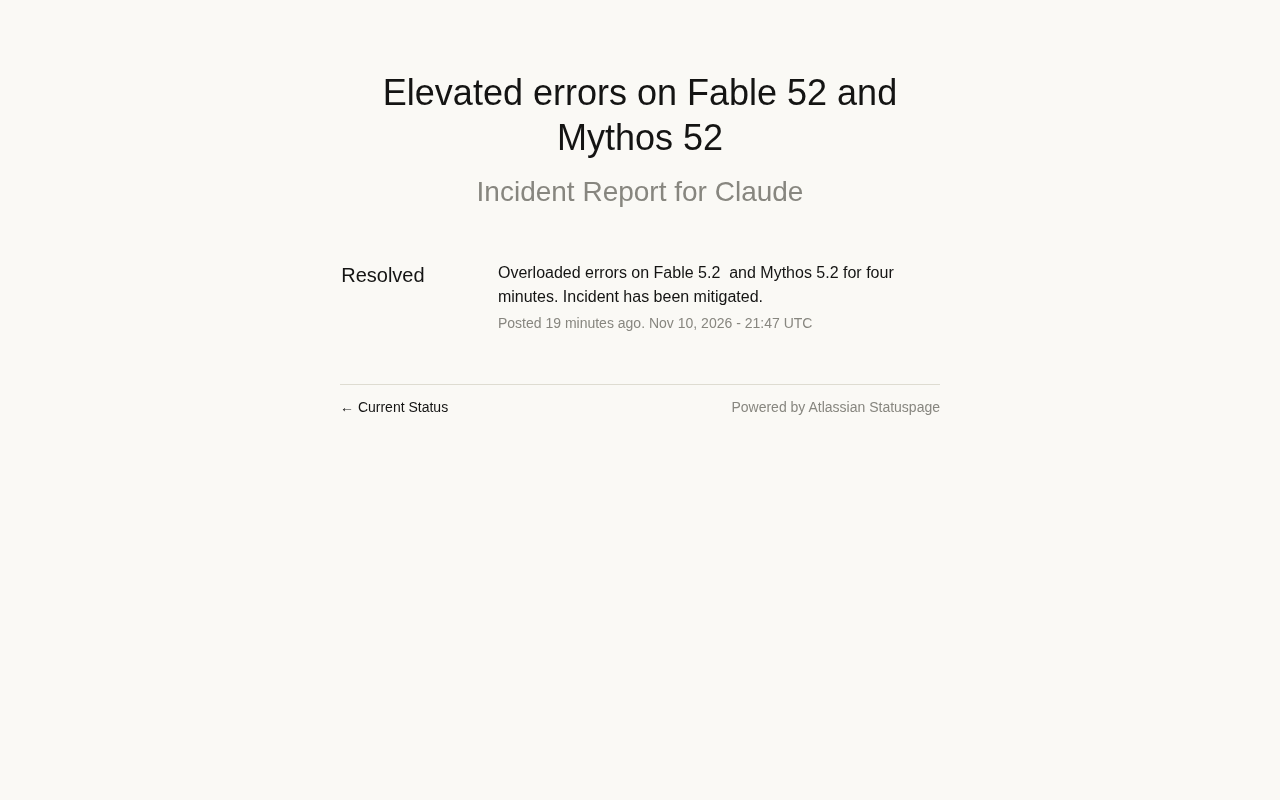
Fable 5.2与Mythos 5.2发生约四分钟过载错误,官方称已缓解,根因未明。
根据RSS状态更新,Fable 5.2与Mythos 5.2于UTC 11月10日21:47出现约四分钟的过载错误(Overloaded errors),官方已标记为“已解决”并确认缓解。通告未披露错误率、影响范围和受影响用户数,仅以“mitigated”措辞暗示采取了限流、扩容等应急手段,根因是否彻底消除尚不明确。两个服务同时受影响,提示可能共享底层资源或处于同一调度域。对开发者而言,四分钟窗口对批处理影响有限,但实时交互应用可能出现用户可感知的失败,建议引入指数退避重试与熔断降级,并以状态页RSS作为低成本监控补充。
事件概述
根据RSS来源的状态更新,Fable 5.2与Mythos 5.2两项服务在UTC时间11月10日21:47出现错误率升高。官方将事件定性为“过载错误”(Overloaded errors),持续时间约四分钟。目前状态已标记为“已解决”(Resolved),并确认事件已得到缓解。
这条状态通告非常简短,没有披露具体错误率、影响范围或受影响用户数量。从运维角度看,四分钟的过载窗口属于典型的短时容量冲击,通常由突发流量、依赖服务抖动或资源调度不及时触发。
故障时间线与定性
四分钟过载窗口
通告显示事件从出现到缓解仅持续四分钟。对于AI服务而言,这个时间尺度意味着系统在过载后很快恢复了稳定。官方使用“mitigated”(已缓解)而非“fixed”(已修复),暗示可能采取了限流、扩容或流量切换等应急手段,而非根因彻底消除。
“过载错误”(Overloaded errors)在AI推理服务语境下,通常指请求量超出系统当前可调度算力(GPU/TPU资源、显存带宽或并发连接池)时返回的一类错误,常见形态包括HTTP 429(Too Many Requests)或503(Service Unavailable),部分平台会以自定义错误码标识。与代码缺陷导致的确定性故障不同,过载具有自限性:一旦负载回落或容量补充到位,错误即会消退,因此服务商往往优先采取限流、排队或弹性扩容等缓解措施,而非等待根因修复。对调用方而言,区分过载错误与鉴权失败、参数错误至关重要,因为前者适合重试,后者重试无益。
状态页的表述差异
“Resolved”状态与“mitigated”措辞同时出现,说明服务已恢复到可接受水平,但后续是否会有根因分析(RCA)尚不明确。对于依赖这两个模型服务的开发者,这类短时错误通常表现为请求超时、429限流或5xx错误,需要客户端具备重试机制。
在事件管理(Incident Management)术语中,“mitigated”表示已采取有效措施使影响降至可接受水平,但事件可能尚未关闭,仍需观察;“resolved”则表示事件结束、服务恢复正常。两者可以先后出现,也可能同时并列出现在状态页的不同字段中。根因分析(RCA)是事件关闭后的复盘文档,通常包含时间线、触发因素、影响量化与改进项。多数云服务商仅在达到一定严重等级(如P1/P2)时才公开发布RCA,短时过载事件往往只有状态页简讯,这解释了本文所述通告信息量有限的原因。
对开发者的实际影响
Fable 5.2和Mythos 5.2的同时过载,提示这两个服务可能共享底层资源或处于同一调度域。四分钟的错误窗口对批处理任务影响有限,但对实时交互式应用可能造成用户侧可感知的失败。
建议在集成这类服务时引入指数退避重试和熔断降级策略,避免短时过载被放大为客户端雪崩。同时,订阅状态页的RSS更新是成本最低的监控补充手段。
指数退避重试(Exponential Backoff)指每次重试前将等待时间按倍数递增(如1s、2s、4s、8s),并通常叠加随机抖动(Jitter)以避免大量客户端在同一时刻集中重试造成“重试风暴”。熔断降级(Circuit Breaker)则是在连续失败达到阈值后暂时切断对下游的调用,直接返回降级结果或缓存数据,待冷却期后再试探性恢复。二者配合使用可将上游短时过载隔离在客户端边界之内,防止局部故障沿调用链放大为系统性雪崩。对于同时依赖Fable 5.2与Mythos 5.2的应用,还应考虑为二者设置独立的熔断器,避免一个服务的抖动拖垮两个调用路径。
待观察的信息缺口
本次通告未包含错误率数值、影响区域、是否波及特定API端点等关键信息。对于生产环境依赖方,这类简讯只能用于事后确认,难以支撑容量规划。后续值得关注官方是否发布更详细的事后复盘。
注:本文信息仅来自单一状态页简讯,事件的技术细节和根因尚未公开,相关分析属于基于运维常识的推断。
状态页RSS订阅(Really Simple Syndication)是一种基于XML的事件推送格式,服务商在发布或更新事件通告时会生成新的条目,订阅方通过轮询或推送网关即可近乎实时地获知故障动态。相比主动调用状态API或人工查看网页,RSS的接入成本极低且不依赖厂商SDK,适合作为监控体系的补充信号源。但其局限也很明显:通告粒度粗、无结构化错误码、通常滞后于真实故障发生时间,因此只宜用于事后确认和告警增强,不能替代基于真实请求的成功率与延迟监控。
相关推荐
OpenAI 谈数据中心公关危机与 AI 监管自我约束
OpenAI 高管访谈解读:AI 数据中心为何遭遇公关危机,以及 OpenAI 为何支持以「限速」框架监管递归自我改进,强调人类必须掌控 AI 技术。
ExecuTorch WebGPU:PyTorch模型直接在浏览器GPU上运行
PyTorch 发布 ExecuTorch WebGPU 支持,模型经 torch.export 导出为 .pte 文件后可直接在浏览器 GPU 上推理,无需转换为其他框架格式,兼顾本地隐私与低延迟部署。
苹果新Mac应用Harbor:本地AI推理与雷雳5集群
苹果新Mac应用Harbor曝光:把Mac变成私有AI推理服务器,通过雷雳5连接多台Mac池化统一内存运行大模型。本文解析其功能、与Exo和LM Studio的差异,以及本地AI生态影响。