Fable 5.2与Mythos 5.2双发:AI模型竞赛新高潮

Anthropic 双模型分道安全赛道,开源巨兽与合规压力同步加速。
Anthropic 同时发布共享底层架构的 Claude Fable 5.2 与 Mythos 5.2,前者面向付费与 API 用户并内置网络和生物安全防护,后者仅向通过安全审核的机构开放,两者均支持 100 万 token 上下文,API 价格较上代下降 20%。Fable 5.2 在 Artificial Analytics 智能指数榜最高思考档以 65 分居首,Arena 网页开发榜 1832 分。行业侧,Grokbot 重置周额度,美团以 MIT 协议开源 1.6 万亿参数的 Luncat 2.5,Thinking Machines 与 Command Code 推出小参数模型。安全与合规方面,Fireworks AI 披露第三方入侵导致客户账单信息及部分数据集、不完整权重被访问;欧盟数字公平法案草案拟禁十类诱导设计并设最高 6% 营业额罚款;OpenAI 研究任务控制系统实现最长 35 秒内停止模型输出。
Anthropic 同时发布了 Fable 5.2 和 Mythos 5.2 两款模型,共用底层架构却走向不同的安全赛道。同时,Grokbot 重置周额度、Muse 发布小参数模型、美团开源 1.6 万亿参数巨兽,AI 行业的竞争节奏丝毫没有放缓的迹象。
Anthropic 双模型策略:能力与安全的分野
据 B 站 AI 早报节目报道,Anthropic 正式推出 Claude Fable 5.2 和 Claude Mythos 5.2,两者共享同一底层模型,但在安全防护和应用场景上做了明确切分。Fable 加入了网络与生物安全防护,面向付费用户和 API 用户开放;Mythos 则只面向通过网络安全或生命科学审核的机构。这种「同源分流」的做法,反映出 Anthropic 对高风险能力扩散的谨慎态度——通用版本可以广泛使用,但涉及敏感领域的深度能力需要资质审核。
两款模型均支持 100 万 token 上下文。价格方面,标准 API 每百万输入和输出分别为 8 美元和 40 美元,比上一代降价 20%;快速模式分别为 16 美元和 80 美元。官方称标准输出速度最高比上一代快 30%,快速模式再快 2.5 倍。
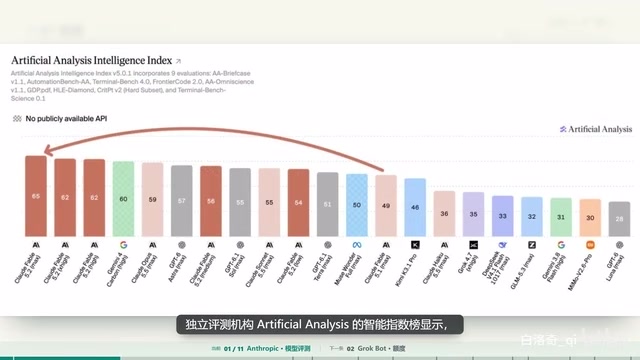
性能数据上,Anthropic 自测显示 Fable 5.2 在 Frontier Code 2.0 的最高思考档取得 49.1%,上一代为 32.4%;Frontier Suite VR 成绩为 69.9%。Mythos 5.2 在漏洞复现测试中达到 89.6%。独立评测机构 Artificial Analytics 的智能指数榜显示,Fable 5.2 在最高思考档获得 65 分,排名第一,高档和超高档均为 62 分,Gemini for Carbon 高档为 60 分。第三方 Arena 的网页开发榜给 Fable 5.2 打出 1832 分,暂列第一;Epoch AI 的 ECI 指数为 174 分。Anthropic 系统卡另给 Mythos 5.2 的内部 AECI 177.12 分,两套指数不能直接比较。
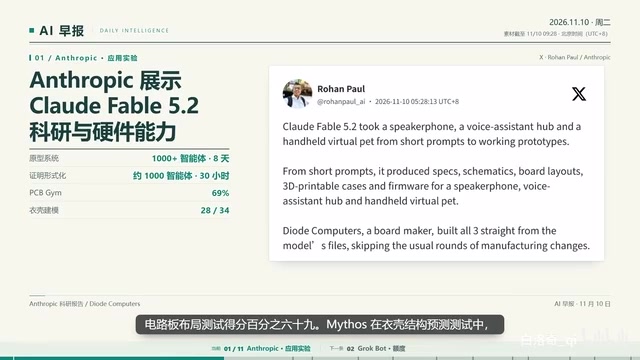
官方演示中,一千多个智能体花 8 天做出了可以启动的圆形操作系统;另一支约一千个智能体组成的团队花 30 小时,把已有的费马大定理证明形式化成计算机可检验的代码。模型还参与了两项黑洞物理计算,合作厂商依据模型设计制成了会议音箱、语音助手和电子宠物,电路板布局测试得分 69%。据截图信息,Mythos 在一项结构预测测试中对 34 个样本准确建模 28 个。这些均为官方和合作方报告的实验结果。
接入生态方面,Fable 5.2 已接入 Google Cloud 的 Nelse Research,也可在 Hermes Agent 中使用。Cloud Pro 和 Team Standard 用户可在北京时间 11 月 17 日下午 3 点 59 分前限时使用 Fable,最多占每周额度的一半。符合原有付费时间条件的用户还有一次额度重置,Max Ultra 和 Team Premium 用户按订阅时长获得 1 到 3 次重置。
MoE(混合专家)架构是理解 Luncat 2.5「1.6 万亿总参数、每 token 仅激活约 480 亿」这一描述的关键。传统稠密模型每次推理都会调用全部参数,而 MoE 把前馈层拆成多个「专家」子网络,由路由门控为每个 token 只挑选少数专家参与计算。因此总参数量决定了模型的容量上限,激活参数量才决定单次推理的算力成本。这也是为什么 1.6 万亿参数的模型仍可高效服务:实际计算量接近一个数百亿参数级别的稠密模型。MoE 的代价是显存占用高(全部专家都需常驻或换入)、路由负载可能不均衡,且微调与量化难度更大。
安全审核式准入在业内通常被称为「分级访问」(tiered access)或「可信访问」机制:同一个基础模型对外提供不同能力档位,涉及网络攻击、生物实验设计等双重用途(dual-use)能力时,要求使用方提交组织资质、使用场景与合规承诺,通过审核后才开放权重或接口。Anthropic 的 Responsible Scaling Policy 就是这类做法的代表框架——先定义能力阈值,再在模型接近阈值时升级防护。它与单纯的内容过滤不同,管控对象是「谁可以用」,而非「可以说什么」。
额度重置与开源浪潮:竞争压力下的用户争夺
Grokbot 官方账号宣布,已为所有 Grokbot 用户重置每周使用额度,转发者表示重置正在陆续推送。这一动作与 Anthropic 的额度重置形成呼应——头部厂商正在用更宽松的用量政策留住用户。
开源侧,美团开源了 Luncat 2.5 的模型权重,采用 MIT 协议。这个原生多模态模型于 11 月 2 日发布,面向长程智能体任务,总参数 1.6 万亿,每个 token 约激活 480 亿参数,支持 100 万 token 上下文。MIT 协议的宽松程度意味着商用门槛极低,这对依赖 API 计费的闭源厂商构成直接压力。
小参数方向也有新动作。Thinking Machines 的 Inkling2Small 已在 OpenRouter 限时免费,结合视觉和智能体编程能力,可在 Cloud Code、Codex 和 Hermes Agent 等工具中使用。Command Code 已在所有套餐中接入轻量模型 Muse Ember,支持 100 万 token 上下文。一位用户分享称,用设计功能生成同一组三维场景时,Muse Ember 一次完成,而 GPT-6 Luna 用了两次提示——这只是该用户的一次体验,样本有限,不宜过度解读。
MIT 协议是最宽松的主流开源许可证之一:允许自由使用、修改、再分发,包括闭源商用,只要求保留版权与许可声明,且不提供担保。相比之下,Apache 2.0 多了专利授权条款,GPL 系列则要求衍生作品同样开源。对模型权重而言,采用 MIT 意味着企业可以将其私有化部署、蒸馏或嵌入商业产品而无需公开改动,这直接削弱了闭源 API 的锁定效应。但需注意,许可证只覆盖权重与代码,训练数据来源、模型输出责任以及部分地区的合规要求仍可能构成额外约束。
**「小参数模型」**通常指参数量在数十亿以内、可在单卡或消费级设备上运行的模型,其价值不在于通用能力全面超越大模型,而在于低延迟、低成本和可端侧部署。这类模型常通过蒸馏大模型、面向代码与智能体工具调用做专项微调来提升实用性。参数规模小也意味着长上下文下的召回与多步推理更容易衰减,因此厂商标注的 100 万 token 上下文,实际有效长度仍需按任务类型评估。
安全与合规:行业暗流
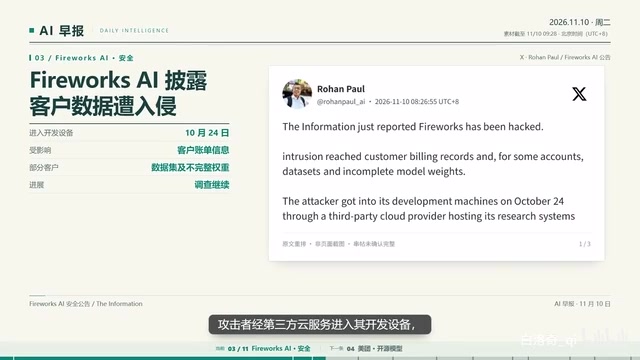
Fireworks AI 披露了新的安全调查结果。10 月 24 日,攻击者经第三方云服务进入其开发设备,客户账单信息受到影响,部分客户的数据集和不完整模型权重也被访问。公司表示已通知受影响客户,10 月 25 日以来未发现攻击者继续成功进入客户使用的平台,调查仍在进行。
合规层面,据路透社和 Euronews 报道,欧盟委员会的一份数字公平法案草案拟禁止十类诱导消费的界面设计,包括虚假稀缺提示、预选附加项目和难以取消的订阅。违规企业可能面临最高相当于全球年营业额 6% 的罚款,草案仍需提出并经过欧盟立法程序,尚未生效。这一方向对 AI 订阅制产品的界面设计有直接约束力。
OpenAI 则发布了研究任务控制系统,用来跟踪研究基础设施中的模型任务,并在出现安全问题时停止或暂停。公司称,从做出干预决定到停止模型输出最多需要 35 秒,该系统已部署在研究基础设施中。35 秒的响应窗口在高速推理场景下是否足够,仍值得观察。
「不完整模型权重」泄露的风险常被低估。完整权重可被直接部署或微调,而不完整权重(如部分层、部分专家或未合并的适配器)仍可能被用于模型窃取攻击:攻击者通过查询受害者 API 的输出,再以泄露的片段作为初始化或先验,显著降低复刻模型所需的查询次数与成本。若泄露中包含训练数据片段或嵌入层,还可能反推出训练语料的敏感信息。这也解释了为何此类事件中,厂商除了通知客户,还需评估是否需要轮换密钥、审计访问日志并加强第三方云服务的边界隔离。
生态扩展:云市场与推理优化
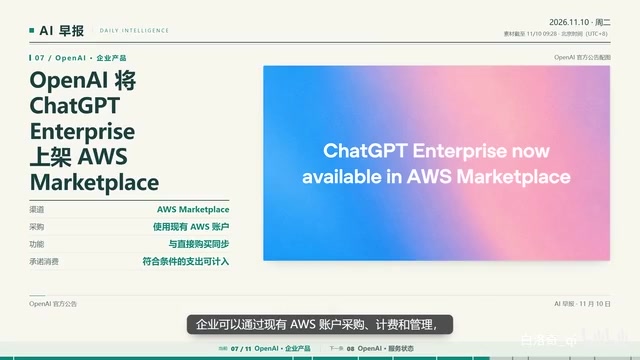
OpenAI 宣布 ChatGPT Enterprise 已上架 AWS Marketplace,企业可通过现有 AWS 账户采购、计费和管理的模型和功能与直接购买相同,新功能也会同步推出。符合条件的支出还可以进入 AWS Marketplace 的承诺消费。
推理性能方面,Together AI 公布 Together Compiler 的推理测试。在 NVIDIA B200 和 B300 上对比 InferenceX 的最佳配置,在相同的用户体验速度下,Kimi K3 的吞吐量最高达到 2.7 倍。这是公司自己的测试结果,衡量的是吞吐量而非单个用户的生成速度。OpenAI 状态页另显示,API 错误率升高事件已经解决,受影响服务恢复正常。
从双模型发布到开源巨兽、从安全事件到合规草案,这一轮 AI 资讯的共同主题是:能力竞赛仍在加速,但安全、合规与成本控制正成为厂商必须同时作答的附加题。
相关推荐

间谍蜜罐训练内幕:情感解离与锚定技术
间谍如何被训练执行蜜罐任务?一位受训者披露情感解离、香水与关键词锚定、目标照片绑定等心理学技术,解析条件反射如何被用于情报行动,并揭示这套机制在日常生活营销中的类似应用。

前沿AI风险管理:从训练到部署的全链路实践
OpenAI系统阐述前沿AI风险管理框架:从训练阶段的模型对齐,到部署阶段的沙箱隔离与阻断式防护,再到部署后的持续监控,构建贯穿模型全生命周期的分层风险控制体系。

Databricks推出Genie Migrate,简化Serverless迁移
Databricks 发布 Genie Migrate for Serverless,帮助用户将既有工作负载迁移到 Serverless 计算。本文解析该迁移工具的定位、对用户的实际意义以及尚未明确的细节。