反思式认知对齐:让AI成为守规矩的老年认知刺激助手
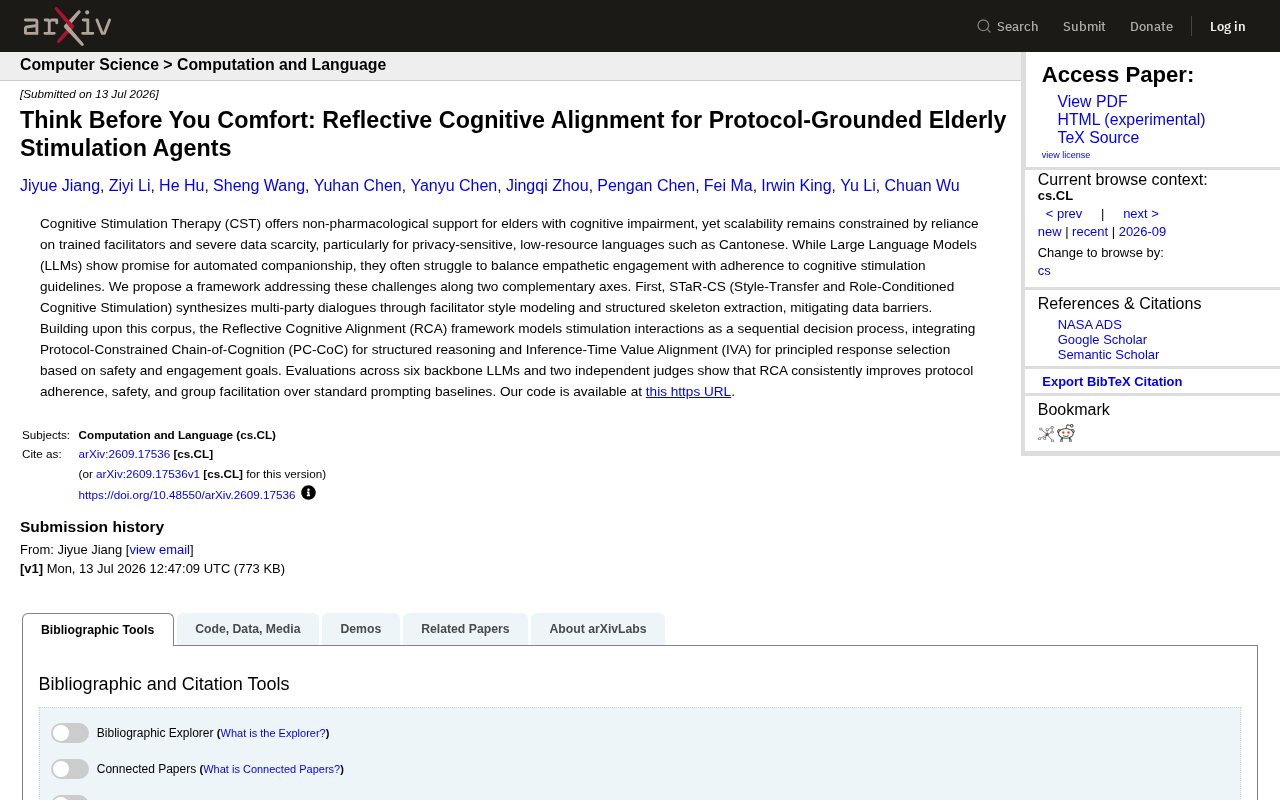
用合成数据与反思式对齐框架,让LLM在粤语认知刺激治疗中兼顾共情与规范。
这篇arXiv预印本(2609.17536)针对认知刺激疗法(CST)难以规模化、且在粤语等低资源语言下严重缺乏训练数据的现实痛点,提出了一套两阶段框架。第一阶段,STaR-CS通过引导者风格建模与骨架提取,合成符合治疗规范的多方对话语料,绕开隐私敏感数据难以获取的障碍。第二阶段,RCA(反思式认知对齐)框架将CST互动建模为序列决策,通过协议约束的认知链(PC-CoC)规范推理过程,再经推理时价值对齐(IVA)筛选兼顾安全性与参与度的最优回应——即"先思考、再安慰"。在六种基础大模型、两个独立评审的评估下,RCA在协议遵循度、安全性与群体引导能力上均实现一致提升,代码已开源,但真实临床场景的有效性仍待验证。
认知刺激疗法(Cognitive Stimulation Therapy, CST)是一种非药物手段,用于帮助存在认知障碍的老年人维持或改善认知功能。但这种疗法长期面临一个尴尬的现实:它高度依赖受过专业训练的引导者,难以规模化,而在粤语这类隐私敏感、资源匮乏的低资源语言场景下,可用的训练数据更是稀缺。近期一篇发表于 arXiv 的研究(论文编号 2609.17536)提出了一套框架,试图用大语言模型(LLM)补上这块短板。
核心矛盾:既要共情,又要守规矩
大语言模型在自动化陪伴场景中展现了不少潜力,但研究者指出了一个关键难点:LLM 往往难以在共情式互动与遵循认知刺激治疗规范之间取得平衡。
这个矛盾并不难理解。一个只顾着安慰老人、说好话的聊天机器人,可能让对话显得温暖,却偏离了认知刺激疗法本身的治疗目标——CST 需要通过结构化的引导让老人主动思考、参与讨论,而不是被动接受安抚。反过来,如果模型死板地执行治疗协议,又可能显得机械、缺乏温度,难以维持老人的参与意愿。论文标题《Think Before You Comfort》(先思考,再安慰)正是对这一矛盾的精炼概括。
认知刺激疗法(CST)最初由 Spector 等人于2003年在英国系统化,其核心原则包括:以人为本而非以疾病为中心、通过讨论刺激多感官与认知域、鼓励意见表达而非纠正错误答案。典型的 CST 活动涵盖时事讨论、词语联想、分类游戏等,通常以小组形式(4-8人)每周进行两次。这种群体互动本身就是疗愈机制的一部分——小组成员之间的社交支持与相互激励,比单纯的认知练习更能维持参与动机。这也解释了为何"群体引导能力"(group facilitation)会成为论文重点评估的维度之一:在多人对话中,AI 引导者既要推动认知任务,又要调动每位成员参与,同时避免让任何人感到被忽视或被纠正,难度远高于一对一对话场景。
两条互补的技术路径
研究团队沿着两个互补的方向来解决问题。
第一步:用 STaR-CS 解决数据荒
第一条路径针对数据稀缺问题。团队提出了 STaR-CS(Style-Transfer and Role-Conditioned Cognitive Stimulation,风格迁移与角色条件化的认知刺激)方法,通过对引导者风格进行建模,并结合结构化的"骨架提取"(skeleton extraction),合成多方对话数据。
这一思路的价值在于:真实的 CST 对话数据既涉及老年人隐私,又在粤语等语言中天然匮乏,直接采集成本极高。通过风格迁移和角色条件化生成合成语料,相当于用可控的方式"造"出符合治疗规范的多人对话,从而绕开了数据获取的障碍。
风格迁移(Style Transfer)在 NLP 领域通常指在保留语义内容的前提下,将文本的表达风格转换为目标风格,例如将正式语体改写为口语,或模仿特定作者的写作习惯。在 CST 场景中,不同引导者有各自的提问节奏、鼓励措辞和话题切换方式——这些细节对维持老年参与者的情绪状态至关重要。"骨架提取"(skeleton extraction)则是先从已有对话中抽取结构性框架(如话题节点、轮次关系、功能性话语),再基于此框架生成完整语料,从而降低合成对话的随意性与偏差。粤语之所以被特别提及,是因为其书写系统与普通话高度重叠,但口语词汇、语法和语调差异显著,导致现有 LLM 在粤语任务上的表现远逊于普通话,而香港及粤语区的老年痴呆患者群体对粤语的依赖程度又往往高于书面中文。
第二步:用 RCA 框架做"反思式"决策
在合成语料的基础上,团队构建了 Reflective Cognitive Alignment(RCA,反思式认知对齐) 框架。它把认知刺激的互动过程建模为一个序列决策过程,并集成了两个关键组件:
- PC-CoC(Protocol-Constrained Chain-of-Cognition,协议约束的认知链):用于结构化推理,让模型在生成回应前先按照治疗协议进行有约束的思考。
- IVA(Inference-Time Value Alignment,推理时价值对齐):在推理阶段,基于安全性与参与度目标,对候选回应进行有原则的筛选。
换句话说,RCA 不是让模型"想到什么说什么",而是先在协议框架内推理,再在多个候选回应中挑选最符合安全和互动目标的那一个。这正呼应了标题里"先思考、再安慰"的设计哲学。
将对话过程建模为序列决策(sequential decision-making)是强化学习与对话系统交叉领域的经典范式:每一轮对话被视为一个状态,模型选择回应相当于执行动作,对话最终效果则对应累积奖励。这一框架的优势在于可以显式地将长期目标(如维持老人参与度、完成治疗协议)纳入决策,而不仅仅优化单轮回应的流畅性。推理时价值对齐(Inference-Time Value Alignment,IVA)区别于训练阶段的 RLHF(基于人类反馈的强化学习):它不修改模型权重,而是在推理阶段对多个候选输出打分筛选,因此部署成本更低、也更容易针对特定场景(如安全性、协议合规性)灵活调整评分标准,对资源受限的医疗照护机构而言具有更强的可操作性。
实验结果:多模型、多评审的一致提升
为了验证框架的普适性,研究团队在六种不同的基础大模型上进行了评估,并引入了两个独立的评审来做判断。
结果显示,相比标准的提示词(prompting)基线方法,RCA 在三个维度上都带来了一致的改善:
- 协议遵循度(protocol adherence)——更好地贴合 CST 的治疗规范;
- 安全性(safety)——回应更符合安全要求;
- 群体引导能力(group facilitation)——在多人对话场景中的引导表现更好。
"跨六种骨干模型、两个独立评审都一致提升"这一点尤其值得关注,因为它说明改进并非依赖于某个特定模型的特性,而是框架层面的通用增益。团队也已将代码开源,托管于 GitHub(github.com/jiangjyjy/RCA_Agent),便于后续复现与研究。
意义与局限
这项工作的现实意义在于,它把 LLM 应用到了一个需求真实、资源却极度受限的场景——老年认知照护,并针对性地解决了"数据"和"对齐"两大痛点。对于粤语等低资源语言社区而言,合成数据加协议约束推理的组合,提供了一条可借鉴的落地路径。
当然,作为一篇新发布的预印本论文,其结论仍需谨慎看待。研究主要在合成语料和模型评审的框架下验证效果,是否能在真实老年群体的长期使用中同样有效,以及合成数据是否会引入难以察觉的偏差,都还有待进一步的临床与实证检验。但作为方向探索,"先思考、再安慰"的设计思路,为医疗辅助类 AI Agent 如何平衡温度与规范,提供了一个有价值的参考样本。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。