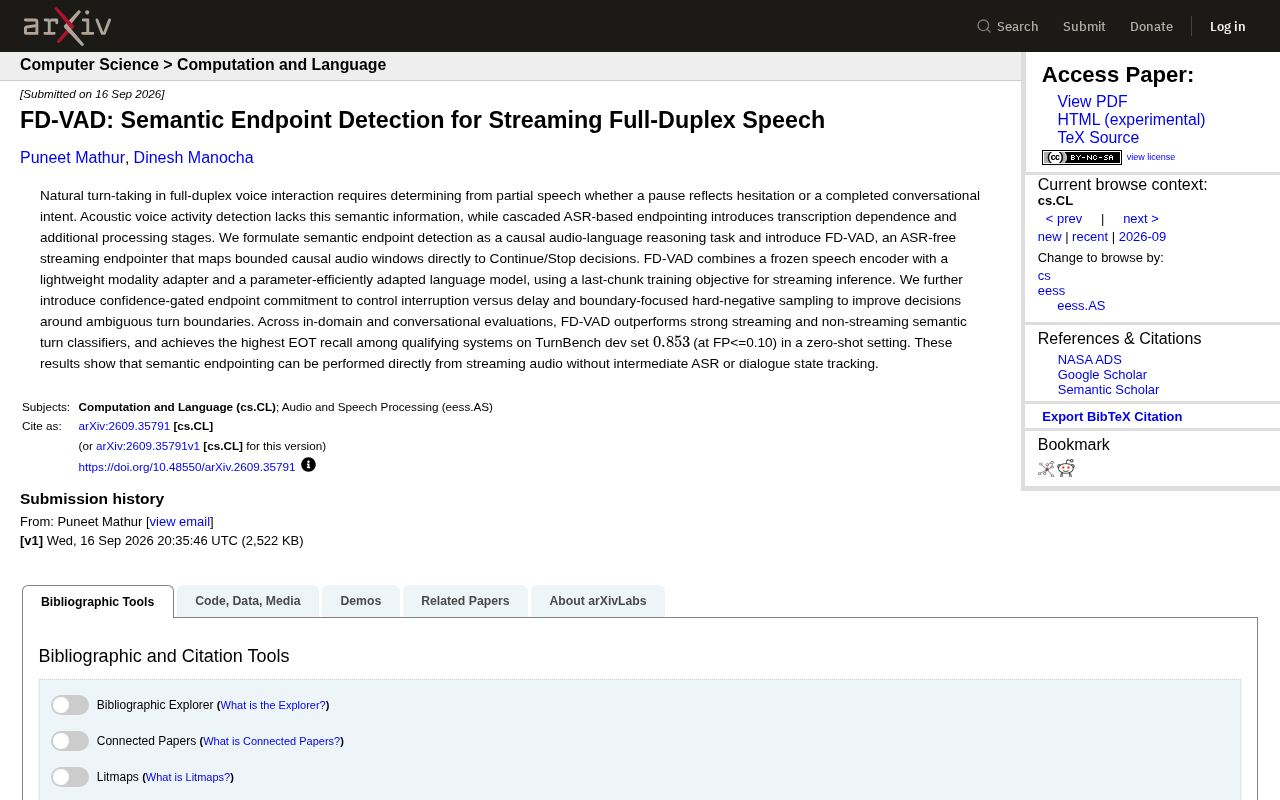
FD-VAD:全双工语音的语义端点检测新方法

FD-VAD 无需语音转写,直接从流式音频做语义端点检测,零样本超越多个强基线。
全双工语音交互中的"轮次接管"(turn-taking)长期依赖声学 VAD 或 ASR 级联方案,前者缺乏语义理解,后者延迟高且存在错误传导。FD-VAD 将语义端点检测重新定义为因果音频-语言推理任务,无需 ASR 转写,直接从实时音频流输出"继续/停止"二元决策。架构由冻结语音编码器、轻量模态适配器和参数高效微调的语言模型组成,并引入末块训练目标、置信度门控端点提交及边界聚焦困难负样本采样三项关键设计。在 TurnBench 零样本评测中,FD-VAD 在误报率不超过 0.10 的约束下取得最高 EOT 召回率 0.853,超越多个流式与非流式基线,证明语义端点检测可以跳过中间 ASR 阶段,以更短的响应链路实现更自然的对话节奏。
在自然的人机语音对话中,一个看似简单却极具挑战的问题始终存在:机器如何判断用户是真的说完了,还是只是短暂停顿在思考?这个被称为"轮次接管"(turn-taking)的能力,是全双工语音交互流畅与否的关键。一篇发表于 arXiv 的最新研究提出的 FD-VAD 方法,正是针对这一痛点给出了新思路。
传统方法的困境
目前主流的端点检测(endpoint detection)方案大致分为两类,各有明显短板。
第一类是基于声学的语音活动检测(VAD)。这类方法通过检测音频信号中是否存在语音来判断停顿,实现简单、延迟低,但它完全缺乏语义理解能力。当用户说"我想订一张去北京的……"然后停顿思考时,纯声学 VAD 无法区分这是句子未完成的犹豫,还是表达已经结束——它只能"听到声音停了",却"听不懂话说完了没有"。
第二类是级联式的 ASR 端点检测,即先做语音识别转成文字,再基于文本判断意图是否完整。这类方法能获得语义信息,但代价高昂:它引入了对转写结果的强依赖,增加了额外的处理阶段,也带来了识别错误传导和延迟累积的问题。
语音活动检测(VAD)技术本身已发展多年,早期主要依赖能量阈值、过零率等信号特征,现代方案则普遍采用神经网络模型(如广泛使用的 Silero VAD 或 WebRTC VAD)来区分语音帧与非语音帧。但无论实现方式如何演进,VAD 的本质目标始终是"有没有声音",而非"话说完没有"。在实践中,系统通常会设置一个固定的静音超时窗口(例如 500ms 无声则判定为说完),这导致两类系统性错误:一是遇到思考停顿时过早切断(误打断),二是为避免误打断而人为拉长等待时间,反过来增加感知延迟。这一"声学盲区"正是纯 VAD 方案难以根本解决的结构性缺陷。
FD-VAD 的核心思路:把端点检测当作因果推理任务
FD-VAD 的创新在于重新定义了问题。研究者将语义端点检测建模为一个"因果音频-语言推理任务"(causal audio-language reasoning task),直接从有限的因果音频窗口映射到"继续(Continue)/ 停止(Stop)"的二元决策,全程无需 ASR 介入。
所谓"因果",指的是模型只能利用当前及之前的音频信息做判断,符合流式(streaming)实时推理的要求;不能"偷看"未来的语音内容。这一约束对于低延迟的在线语音交互至关重要。
在架构设计上,FD-VAD 采用了轻量化的组合方案:
- 冻结的语音编码器(frozen speech encoder)负责提取音频特征,不参与训练,节省算力;
- 轻量级模态适配器(lightweight modality adapter)负责把语音特征桥接到语言模型的表示空间;
- 参数高效适配的语言模型(parameter-efficiently adapted LM)承担语义推理,通过参数高效微调降低训练成本。
配合专门为流式推理设计的"末块训练目标"(last-chunk training objective),FD-VAD 得以在保持实时性的同时借用语言模型的语义理解能力。
参数高效微调(Parameter-Efficient Fine-Tuning,PEFT)是一类只更新模型极少数参数就能适配新任务的方法,代表技术包括 LoRA(低秩分解适配)、Prefix Tuning 等。其核心动机在于:大型语言模型参数量动辄数十亿,全量微调不仅需要巨量显存和算力,还容易导致灾难性遗忘。PEFT 方法通过在原始权重旁注入少量可训练模块,以不到 1% 的参数更新量达到接近全量微调的效果。在 FD-VAD 中,对语言模型使用 PEFT 的意义是双重的:一方面保留了预训练阶段习得的语义知识(即"语言感"),另一方面大幅压缩了针对端点检测任务的训练成本,使整个系统在资源受限的在线推理场景中具备实用可行性。
两项关键技术设计
除了整体架构,FD-VAD 还引入了两个针对性的技术手段来提升实际表现。
置信度门控的端点提交
在对话中,机器过早打断用户和反应过慢都会损害体验。FD-VAD 采用"置信度门控端点提交"(confidence-gated endpoint commitment)机制,通过置信度阈值来平衡"打断风险"与"延迟"这对矛盾。只有当模型对"用户已说完"足够确信时才提交停止决策,从而在保证响应速度的同时降低误打断的概率。
边界聚焦的困难负样本采样
真正难判断的往往是那些处于模糊轮次边界的情况——比如自然停顿、语气拖长等。FD-VAD 使用"边界聚焦的困难负样本采样"(boundary-focused hard-negative sampling),在训练时刻意强化模型对这些歧义边界的判别能力,让模型在最容易出错的地方得到更多学习信号。
实验结果:零样本下依然领先
研究在域内(in-domain)和对话场景两类评测中对 FD-VAD 进行了验证。结果显示,FD-VAD 超越了多个强劲的流式与非流式语义轮次分类器基线。
最具说服力的一项数据来自 TurnBench 开发集:在零样本(zero-shot)设定下,FD-VAD 在符合条件的系统中取得了最高的 EOT(End-of-Turn,轮次结束)召回率 0.853(在误报率 FP≤0.10 的约束下)。零样本意味着模型未在该数据集上专门训练,这一成绩体现了方法良好的泛化能力。
TurnBench 是专门用于评估对话轮次结束检测能力的基准数据集,覆盖了多种真实对话场景下的语音样本,包含自然停顿、犹豫、句式未完成等典型歧义边界情况。评测中使用的核心指标是"在误报率(False Positive Rate)不超过某一阈值的前提下最大化 EOT 召回率"——这一设定直接对应实际产品需求:系统必须控制误打断用户的频率(即 FP),同时尽量不错过真正的轮次结束时机(即高召回)。零样本(zero-shot)设定意味着 FD-VAD 未使用 TurnBench 的任何训练数据,这与许多基线系统在领域内数据上微调的情况形成对比,因此 0.853 的召回率更能体现方法本身的泛化性,而非数据拟合的结果。
意义与展望
FD-VAD 传递的核心信息很明确:语义端点检测可以直接在流式音频上完成,无需中间的 ASR 转写,也无需对话状态跟踪。这打破了"要理解语义就必须先转文字"的固有路径依赖。
对于语音助手、实时同传、客服机器人等全双工交互场景而言,这种 ASR-free 的架构意味着更短的响应链路、更低的延迟以及更自然的对话节奏。当然,作为一项新方法,其在更大规模真实场景中的鲁棒性、多语言适应性以及与下游对话系统的集成效果,仍有待后续研究进一步验证。
总体来看,FD-VAD 为全双工语音交互中的轮次接管难题提供了一条兼顾语义理解与实时性的可行路径,代表了端点检测从"听声音"向"懂意图"演进的方向。
相关推荐
Linux 发行版该停止纠结桌面了:底层才是真正价值
一位资深 Linux 创作者认为,多数发行版把精力浪费在桌面美化和品牌差异化上,而内核、驱动、软件仓库等底层才是真正价值所在。本文梳理其核心论点与内在矛盾。
用户自建个人感知系统:谁在定义技术的边界?
一项HCI研究通过绿野仙踪探针,探讨用户自建个人感知系统时如何与技术预设的本体论边界协商,揭示了超越可用性的设计评估新维度。
从零实现AdaBoost:机器学习手写算法第27天实录
一位Reddit学习者从零手写实现AdaBoost算法,分享机器学习第27天进度。本文解析AdaBoost核心原理、从零实现的价值,以及从集成学习到深度学习的自学路线规划。