FDE前沿部署工程师:AI落地的新物种与实战路径

FDE是AI时代弥合产品与客户需求鸿沟的关键角色,需技术业务双修。
文章系统拆解了FDE(前沿部署工程师)这一角色。FDE源于Palantir的深度定制实践,核心是坐在客户现场,将定制交付沉淀为可复用产品能力,与普通外包有本质区别。AI时代现场定制成本下降、企业定制化需求上升,使FDE规模化成为可能。技术能力栈呈梯度:Agent开发与私有化部署为起点,微调突破效果天花板,强化学习与预训练为进阶。企业落地最大卡点不是技术条件,而是微调前后效果缺乏验证手段,导致决策层不愿投入。FDE还需兼任产品经理,把技术价值翻译为业务收益。企业级部署建议8B以上模型,预算从2万到200万以上分化明显。
AI落地难,难在技术与业务之间的鸿沟。一个名为FDE(Forward Deployment Engineer,前沿部署工程师)的角色正在成为填补这道鸿沟的关键。本文基于一线从业者的分享,拆解FDE的起源、能力模型与实战路径。
FDE是什么:坐在客户现场的工程师
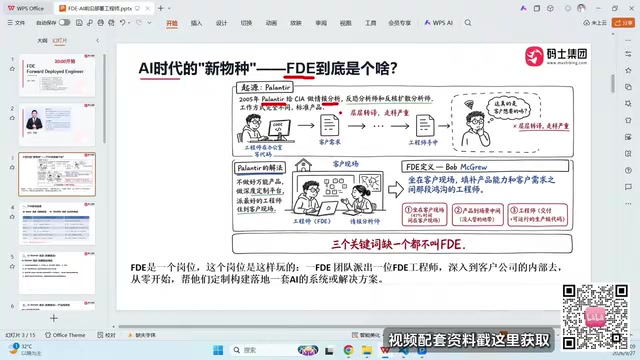
FDE的全称是Forward Deployment Engineer,中文常译为“前沿部署工程师”。它的核心定义很直白:坐在客户现场,弥补产品能力与客户真实需求之间那段鸿沟的工程师。
这个概念并非凭空出现。据分享者介绍,FDE的实践最早可追溯到Palantir这类公司——它们为政府机构做情报分析类项目时发现,标准化产品往往是程序员在办公室里“拍脑袋”想出来的,需求经过层层转述后严重走样。Palantir的解法是不做万能产品,而是做深度定制的平台,派最好的工程师到现场与客户共同工作。
这与传统外包有本质区别。外包是“来一个项目做一个项目”,换一个客户,前面的代码很难复用;而FDE要求每一次现场交付都能沉淀为产品能力——换一个客户,只需调整参数、环境和变量,就能快速落地。是否具备“产品复用”能力,是区分FDE与普通驻场开发的关键分水岭。
Palantir模式:Palantir是一家成立于2003年的美国大数据分析公司,早期客户以美国政府情报机构为主。其核心产品Gotham和Foundry并非开箱即用的标准化软件,而是需要工程师深度介入客户业务流程进行定制化配置的平台。Palantir的独特之处在于,它把最优秀的工程师(被称为"前哨工程师"或"部署策略师")长期派驻客户现场,与分析师、操作人员共同工作,在解决具体问题的过程中不断抽象出可复用的产品模块。这种"现场定制+产品沉淀"的双轮模式,使Palantir在反恐、军事、金融风控等领域建立了极高的客户粘性,也成为FDE概念的原型范本。
为什么是AI时代才催生了FDE
一个自然的问题是:驻场服务在软件外包时代就存在,为什么FDE直到AI时代才成为热词?
答案藏在成本结构里。过去,把年薪80万的核心工程师派到客户现场,公司要承担百万级的人力负担,而客户需求往往在沟通过程中不断膨胀,投入产出极不划算。因此多数公司不愿意把最好的工程师放到一线。
AI改变了两件事。其一,模型与智能体技术让“快速出原型、快速验证”成为可能,现场定制的边际成本大幅下降;其二,企业客户对AI落地的预期从“买一个标准SaaS”转向“解决我的具体业务问题”,标准化产品越来越难以直接交付价值。供需两端同时变化,FDE这个角色才有了规模化存在的土壤。
FDE的能力栈:从Agent开发到微调
想走FDE路线,需要准备什么?分享者给出的技术路径有清晰的梯度。
第一层是AI Agent开发与模型私有化部署。 这是入门起点,也是绝大多数企业项目最先落地的部分。
第二层是微调(Fine-tuning)。 很多场景下,仅靠智能体编排无法达到验收标准。分享者用了一个形象的比喻:业务要求考95分,只做Agent开发可能卡在90分。微调是突破天花板的必要手段。
第三层是强化学习与预训练。 从难度排序看,微调小于强化学习,强化学习又小于预训练。分享者建议不要一上来就啃预训练,而应按“Agent开发→私有化部署→微调→强化学习”的顺序进阶。
说个细节,企业级部署如今一般建议至少8B以上的模型,8B以下在实际业务中的意义已经不大。硬件成本是绕不开的现实:一组英伟达显卡可能就要百万元级投入。金融、医疗类客户或许能接受200万以上的采购单,但传统企业可能只愿意为AI改造出2万元预算——这种预算分化,直接决定了FDE项目的形态与深度。
微调(Fine-tuning):微调是指在预训练大模型的基础上,用特定领域的标注数据对模型参数进行进一步训练,使其适配下游任务的技术。与提示词工程或智能体编排相比,微调能更根本地改变模型的行为模式——前者是在模型原有能力边界内做调度,后者则试图拓展边界本身。微调的数据量要求通常从数百到数万条不等,成本取决于模型规模与训练方式(全参数微调或参数高效微调如LoRA)。其核心挑战不在于训练本身,而在于效果验证:如何设计一套可信的评测集,量化微调前后在业务指标上的差异,是企业客户最关心的环节。
强化学习与预训练:强化学习(RL)在AI落地中通常指基于人类反馈的强化学习(RLHF)或基于可验证奖励的强化学习(RLVR),用于让模型在特定任务上优化决策策略,典型应用于复杂推理、代码生成等场景。预训练则是从零开始用海量通用语料训练基础模型,需要数千张GPU和数百万美元级投入,通常只有模型厂商或极少数头部企业会涉足。对FDE而言,强化学习是微调之后的进阶手段,适用于微调仍无法达到验收标准、且任务具备明确奖励信号的场景;预训练则基本超出单个项目的能力边界,更多是理解模型能力来源的知识背景。
企业落地的现实坑:微调为什么推不动
分享者提到一个高频误区:很多公司不是“没有条件微调”,而是“不愿意微调”。核心卡点在于验证——微调前和微调后的效果如何量化对比?如果企业自己感受不到提升,甚至觉得“越调越差”,就很难说服决策层为此投入几十万的人力或外包费用。
这揭示了一个常被技术视角忽略的事实:FDE不仅是技术角色,还兼任产品经理的职责。在客户现场,工程师要直接面对需求的模糊、预算的约束和验收标准的博弈。能否把技术价值翻译成客户可感知的业务收益,往往比模型本身更决定项目成败。
从行业分布看,类似Palantir模式的深度定制服务在中国也并不罕见,尤其在政务、金融等长期合作的场景中。FDE的本土化实践,正在从少数先行者向更多企业扩散。
8B模型门槛:8B指模型参数量为80亿级别,是当前开源模型(如Llama 3 8B、Qwen 2.5 7B/14B等)的主流规格之一。参数量直接关联模型的知识容量与推理能力:8B以下模型在复杂指令遵循、多步推理和领域知识覆盖上往往力不从心,难以满足企业级业务的验收标准。而8B以上模型对硬件的要求显著提升——以FP16精度推理为例,8B模型约需16GB显存,70B模型则需140GB以上,通常需要多卡并行。这也是为什么企业级部署的硬件成本容易达到百万元级,并成为FDE项目预算分化的关键变量。
写在最后
FDE的本质,是把AI能力从“能演示”推进到“能验收”。它要求工程师同时具备算法功底、工程能力和业务沟通能力,也要求组织接受“现场定制+产品沉淀”的双轮逻辑。对个人而言,从Agent开发起步、逐级向微调与强化学习深入,是一条相对务实的成长路径;对企业而言,先想清楚验收标准,再决定是否投入微调,比盲目追新技术更重要。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。