FDE前沿部署工程师:AI落地新物种与两大流派实战

FDE是2026年兴起的AI落地角色,打通技术与业务的最后一公里。
文章介绍了FDE(前沿部署工程师)这一2026年兴起的AI落地角色,其核心定位是解决AI技术与企业业务之间的需求失真问题。FDE分为两大流派:源自Palantir的本体论驱动,强调构建企业级知识本体,适合金融、医疗等严谨场景;以及AI Walking的场景驱动,以具体业务为切入点快速迭代,适合预算有限的传统企业。技术路径上,建议从Agent开发与模型私有化部署起步,逐步深入微调与蒸馏,预训练难度最高且非必需。企业微调的核心障碍并非技术条件,而是投入产出比不清晰、效果难以验证。文章还指出国内FDE人才极度稀缺,当前是转型入行的窗口期。
FDE是什么?AI时代的企业落地新物种
FDE的全称是Forward Deployment Engineer,中文常译为“前沿部署工程师”。这个角色在2026年成为AI领域的热门概念,核心定位是打通AI技术与企业实际业务之间的“最后一公里”。与传统的算法工程师或后端开发不同,FDE需要同时具备技术深度与业务理解力,能够驻场式地深入客户场景,将模型、智能体与业务流程深度融合。
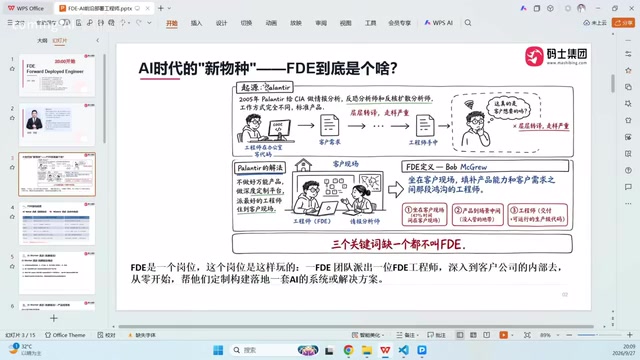
据B站UP主李锦老师的分享,FDE的诞生与Palantir公司密切相关。Palantir在为CIA等政府机构做情报分析时发现,标准化产品往往由程序员“拍脑袋”设计,需求经过层层传递后严重走样——客户想要A,最终交付的却变成了E。这种痛点在当前企业AI落地中依然普遍存在,而FDE正是为了解决这一问题而生。
FDE的两大流派:本体论驱动与场景驱动
FDE在实践发展中形成了两个主要流派,分别对应不同的落地方法论。
Palantir流派:本体论驱动
这一流派源自Palantir的政府与国防项目经验,强调构建企业级的知识本体(Ontology),将数据、实体、关系与业务规则抽象为统一模型,再在此基础上开发AI应用。其优势在于对复杂业务逻辑的建模能力强,适合金融、医疗、情报分析等对数据严谨性要求极高的场景。
知识本体(Ontology) 在计算机与信息科学中,指对某一领域内概念、实体、属性及其相互关系的显式、形式化描述。企业级本体通常包含实体类型(如客户、订单、设备)、关系(如“属于”“依赖于”)、业务规则与约束,并可映射到数据库表或知识图谱。Palantir 的本体论驱动方法,本质上是先构建一个与业务语义对齐的统一数据模型,再让 AI 应用基于该模型进行推理与查询。这样做的好处是:业务逻辑集中管理、数据口径一致、AI 输出可解释可审计。对于金融风控、医疗诊断、情报分析等场景,本体还能作为“业务知识库”约束大模型的幻觉,使智能体的决策链路更可控。
AI Walking流派:场景驱动
另一个流派更偏向“边走边看”的敏捷落地方式,以具体业务场景为切入点,快速构建智能体(Agent)并迭代优化。这种方式对客户的前期投入要求较低,适合传统企业以较小成本启动AI改造。李锦老师在课程中提到,很多传统公司愿意为AI化改造支付的预算非常有限,场景驱动的轻量级方案更容易被接受。
智能体(Agent) 指以大语言模型为推理核心,能够自主规划步骤、调用工具(如搜索、数据库、API)、执行多轮任务并观察结果的软件系统。与企业传统软件不同,Agent 的行为由提示词、工具定义与记忆机制共同决定,因此可以快速搭建、快速试错。在场景驱动流派中,FDE 通常先选取一个边界清晰、价值可量化的业务场景(如客服工单分类、合同审核辅助),用低代码或开源框架构建 Agent 原型,在真实数据上跑通后再逐步扩展。这种“小步快跑”的方式能显著降低客户的前期决策成本,也便于在早期暴露数据质量与流程集成问题。
走FDE路线需要掌握哪些技术?
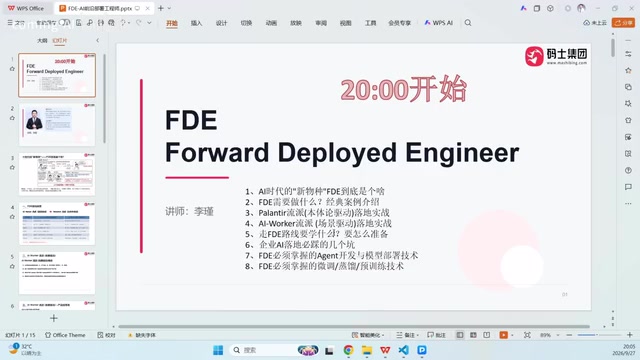
FDE的技术栈可以划分为几个层次。最基础的是AI Agent开发与模型私有化部署,这是大多数企业项目的起点。李锦老师建议,初学者不要一上来就啃预训练,而应该先从Agent开发或本地化部署入手。
再往上走是微调(Fine-tuning)和蒸馏(Distillation)。在企业级项目中,仅靠智能体开发往往只能达到“90分”,而业务验收标准可能需要“95分”,此时就必须引入微调。从技术难度看,微调小于蒸馏,蒸馏又小于预训练。很多公司不愿意做微调的核心原因并非“没有条件”,而是投入产出比不清晰——调完之后谁来验证效果?如果微调不能带来可感知的收益,企业自然缺乏动力。
本地化部署的成本也是FDE必须面对的现实问题。李锦老师建议企业级部署至少选择8B以上的模型,8B以下的模型在2026年的企业场景中意义有限。硬件成本因客户类型差异巨大:一线互联网公司可能认为200万不算贵,而传统小公司可能只愿意出2万元做AI改造,这种预算鸿沟直接决定了技术方案的选择。
微调(Fine-tuning) 指在预训练大模型基础上,用特定领域的标注数据继续训练,使模型适应下游任务。常见方式包括全参数微调与参数高效微调(如 LoRA、QLoRA),后者只更新少量附加参数,显存与算力需求大幅降低。蒸馏(Distillation) 则是让一个较大的“教师模型”指导较小的“学生模型”学习,把大模型的能力压缩到小模型上,以降低推理成本、提升部署可行性。预训练(Pre-training) 是从零开始用海量无标注语料训练基础模型,需要千卡级算力与数月周期,通常只有头部机构才具备条件。三者难度递增、成本量级差异巨大,这也解释了为何 FDE 建议从 Agent 开发和私有化部署切入,再按项目收益决定是否投入微调或蒸馏。
企业落地中的常见坑与应对思路
FDE的工作本质是企业落地,而企业落地必然伴随一系列“必踩的坑”。首先是需求传递的失真问题,这与Palantir当年观察到的情况如出一辙。其次是微调的验证难题——模型调整后的效果缺乏客观评估标准,导致客户对投入产生疑虑。第三是成本与预期的错配,客户预算与技术方案之间往往存在巨大差距。
李锦老师特别指出,FDE人才目前在国内极为稀缺。如果企业想招聘有FDE经验的人,几乎只能去美国Palantir这类公司寻找,因为中国很多企业才刚刚开始进行FDE改造。这也意味着,对于希望转型FDE的从业者来说,当前是一个窗口期。
RAG(检索增强生成) 是 FDE 在企业落地中高频使用的技术。它先从企业知识库(文档、数据库、工单记录)中检索与用户问题相关的片段,再把这些片段作为上下文交给大模型生成回答。相比微调,RAG 不需要重新训练模型,知识更新只需更新索引,因而特别适合制度文档频繁变化、且要求回答可溯源的场景。RAG 的落地难点在于文档切分策略、向量化模型选择与召回精度调优——检索不准,生成质量就无从谈起。FDE 往往需要把 RAG 与多智能体协作结合,例如让一个 Agent 负责检索、另一个负责校验与格式化输出,才能满足企业级业务对准确率与合规性的要求。
给想入行FDE的从业者建议
如果你计划在2026年走FDE路线,建议的学习路径是:先掌握AI Agent开发与模型部署,再逐步深入微调和蒸馏,最后根据项目需要接触预训练。同时要注重业务理解能力的培养,因为FDE的核心价值不在于写代码,而在于把技术翻译成业务价值。李锦老师本人具备从底层算法到AI应用端到端的开发落地能力,其经验表明,传统微服务与多智能体、RAG检索等技术的深度融合,是FDE在实际项目中的重要武器。
相关推荐
AI新物种FDE落地实战:核心职责与就业指南
深入解析AI新物种FDE(前沿部署工程师)的三大核心职责、与算法后端产品的角色分工,以及面试就业准备指南,结合学习平台智能体改造实战案例,帮助开发者理解AI落地最后一公里的关键角色。
LangChain + MCP 实战:架构协议与 Agent 工具集成
从 LangChain 框架与 Agent 封装讲起,解析 MCP 协议如何解决工具跨模型、跨框架复用的难题,对比 MCP 与 Function Calling 的关系,梳理 LangChain 技术栈层次与 Agent 开发要点。
Codex 实战全流程:环境安装到 Skills 与 MCP 调用
Codex 是 OpenAI 推出的 AI 编程助手,本文梳理其定位、与 Claude Code 的对比、环境安装中的模型配置坑,以及 Skills 与 MCP 调用的实战思路,适合零基础开发者快速上手。