FDE前沿部署工程师:AI时代新物种与落地实战解析

FDE是AI落地企业时驻场弥补产品与需求鸿沟的新角色,需产品化复用与端到端能力。
FDE(前沿部署工程师)最早诞生于Palantir服务政府客户的实践,核心是派工程师驻场,带着可复用的产品化底座解决客户个性化需求。AI大模型时代,投入产出比的变化让这一模式重新走红:现场部署和调优能直接产生可验收的效果,企业才愿意为深度服务付费。FDE兼具产品经理职责,需端到端理解业务并转化为AI方案。技术上建议从AI Agent开发或私有化部署起步,逐步深入微调、蒸馏、预训练,难度递增。企业落地最大的坑是微调价值难以验证,本质是商业回报问题,而非纯技术问题。
FDE前沿部署工程师:AI时代新物种与落地实战解析
AI大模型落地企业时,总有一道鸿沟横在技术团队和客户需求之间。FDE(Forward Deployment Engineer,前沿部署工程师)正是为填补这道鸿沟而生的角色。本文基于B站UP主李锦老师的分享,系统梳理FDE的起源、核心能力与落地实战要点。
FDE到底是什么?从Palantir说起
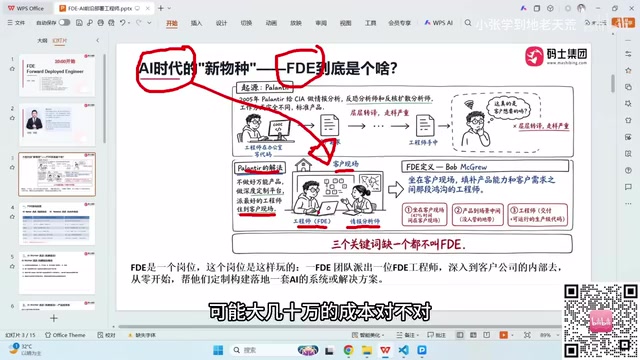
FDE的全称是Forward Deployment Engineer,翻译过来叫前沿部署工程师。这个岗位最早诞生于Palantir——一家给CIA做情报分析的公司。Palantir在服务政府客户时发现,标准化产品往往是程序员在办公室里拍脑袋想出来的,客户需求经过层层转述后严重走样。于是他们换了一种打法:不做万能产品,做深度定制平台,派最好的工程师直接驻场到客户那里。
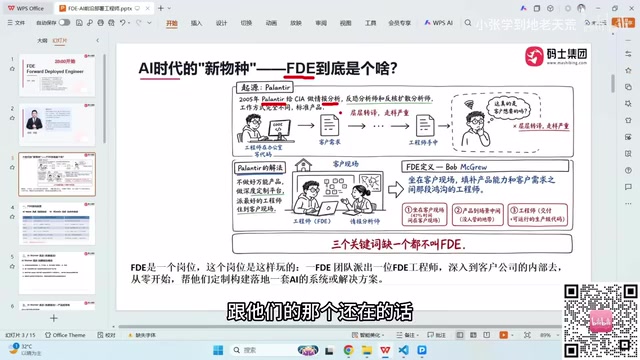
这就是FDE的核心定义:坐在客户现场,弥补产品和客户需求之间那道鸿沟的工程师。从程序员视角看,这似乎就是做项目,但关键词在于“产品”——如果每到一个客户现场做的东西无法复用,那就只是传统外包,不叫FDE。真正的FDE团队会带着一套经过验证的AI改造方案进场,对接参数、调整环境变量后快速落地。
Palantir的背景值得展开。 这家公司成立于2003年,早期由Peter Thiel等人投资,核心产品包括面向政府情报机构的Gotham和面向商业客户的Foundry。它最知名的打法是"本体论(Ontology)驱动"——不是简单地把数据可视化,而是先为客户构建一套描述其业务实体、关系和动作的"本体",再让分析人员在这个语义层之上做推理和决策。FDE正是这种模式的执行者:他们长期驻扎客户现场,一边理解业务语义,一边把通用平台能力翻译成具体的分析流程。这种模式让Palantir在早期就形成了"平台+人"的混合交付形态,也解释了为什么它的工程师常被要求具备极强的业务理解力,而非单纯写代码的能力。
为什么FDE在AI时代才火起来?
这套模式在传统外包时代并非没有,但为什么现在才被重视?成本结构变了。以前派一位年薪80万的核心工程师常驻客户现场,公司要负担上百万的综合成本,而客户需求还未必能快速收敛。这笔账很多公司算不过来。AI大模型的出现改变了投入产出比——当模型能力足够强,现场部署和调优能直接产生可验收的业务效果时,企业才愿意为这种深度服务买单。
FDE本质上兼任了产品经理的职责。在客户现场,FDE需要直接与客户沟通需求,理解业务场景,再转化为可落地的AI解决方案。这种端到端的能力要求,也正是FDE区别于普通算法工程师或后端开发的地方。
走FDE路线,需要掌握哪些技术?
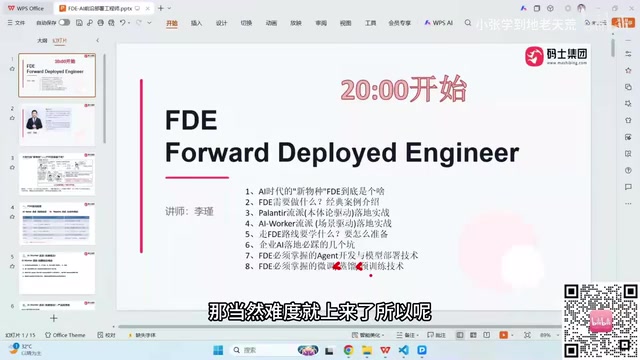
如果要在当下走FDE路线,技术栈的深度和广度缺一不可。李锦老师给出了明确的学习路径:从AI Agent开发或模型私有化部署入手,逐步深入到微调、真六(蒸馏/量化等模型压缩技术)、预训练。难度上,微调 < 真六 < 预训练,这也是推荐循序渐进的原因。
很多业务场景在项目验收时,智能体层面能到90分,但验收标准要求95分——差的这5分就得靠微调来补。FDE干到后期必然要掌握微调,因为仅靠Agent层面的开发,效果很容易卡在瓶颈上。同时,企业级部署至少推荐8B以上的模型,8B以下的模型在当前阶段意义已经不大。本地化部署的成本取决于模型规模和业务场景,金融、医疗等行业的硬件采购单可能达到200万级别,而传统公司可能只愿意出2万块——这决定了FDE服务的定价逻辑和客群选择。
文中提到的"真六",是行业内对模型压缩相关技术的一个口语化统称,主要涵盖蒸馏(Distillation)、量化(Quantization) 以及剪枝、低秩分解等手段。蒸馏指用大模型(教师模型)的输出指导小模型(学生模型)训练,让后者以更小体积逼近前者效果;量化则是把模型权重从FP16/FP32降低到INT8、INT4等精度,以减少显存占用和推理延迟。这些技术之所以被视为FDE的重要技能,是因为企业私有化部署时往往受限于本地算力和成本,直接跑满血大模型不现实。掌握蒸馏和量化,才能在有限的硬件上把模型效果和响应速度调到可交付的水平,这也是"微调之后"必须补上的工程环节。
企业落地中绕不开的坑
企业AI落地最常见的坑,不是技术做不到,而是微调的价值难以验证。很多公司不愿意做微调,核心原因在于:调完之后谁来证明效果比调之前好?有开公司的朋友反馈“越调越差”,与其花大几十万招一个微调工程师,不如不做。这其实是一个商业问题——当微调无法带来可感知的收益时,企业自然没有动力投入。
另一个现实是,客户需求在现场往往不断变化。FDE如果没有一套可复用的产品化底座,很容易陷入“做一个项目换一个地方,前面积累全白费”的困境。这也是FDE团队必须建设产品化能力的原因:带着可配置的解决方案进场,而不是每次从零开始写代码。
模型规模与业务场景的匹配,是FDE做方案设计时的关键判断。 文中提到企业级部署至少推荐8B以上的模型,原因在于参数量过小的模型在多轮对话、复杂指令遵循、工具调用等Agent核心能力上表现不稳定,容易在实际业务中"掉链子"。但模型越大,本地推理所需的GPU显存、并发能力和运维成本也越高。FDE需要根据客户的预算、数据敏感度和任务复杂度,在"模型能力"和"硬件成本"之间找到平衡点:金融、医疗等对数据不出域有强合规要求的行业,往往愿意为高配置买单;而预算有限的中小企业,则更适合先跑通轻量Agent场景,再逐步升级。
总结
FDE是AI大模型进入企业深水区后催生的新物种,它要求工程师同时具备算法能力、工程能力和业务沟通能力。Palantir流派强调本体论驱动,另一些团队走场景驱动路线,但核心逻辑一致:用可复用的产品化能力,在现场解决客户的个性化问题。对于想走这条路线的人来说,从Agent开发和模型部署起步,逐步向微调和预训练深入,是比较务实的成长路径。
相关推荐

OpenAI办公室发现录音设备:安全与隐私再引关注
OpenAI在一处办公室发现录音设备,事件细节有限但引发对AI公司物理安全与隐私保护的广泛讨论。本文分析事件背景、行业影响及对AI从业者的安全启示。

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。