Fit Receipt:懂得何时调用JEV的隐私优先虚拟试衣Agent

Fit Receipt以虚拟试衣为载体,示范了AI Agent如何负责任地调用判断模型、隔离敏感数据并用代码守护事实。
Fit Receipt是一款在Vercel Day亮相的开源参考实现,表面上是隐私优先的虚拟内衣试穿工具,实质上是一套AI Agent工程范式的技术演示。其核心创新在于三个层面:其一,引入判断模型JEV,仅在必要时被调用,输出带校准置信度的评分,低置信度时主动保持未决而非强行作答;其二,采用「Agent处理对话、代码守护事实与定价」的分层架构,从工程层面切断幻觉风险;其三,将用户照片处理限制在浏览器本地,JEV只接触结构化字段,实践隐私最小化原则。这套设计对正在构建垂直AI Agent的开发团队具有较高的参考价值,其示范意义远大于产品本身的商业属性。
在Product Hunt的Vercel Day活动中,一款名为Fit Receipt的产品以73票排在第19位。它试图解决两个看似不相关的问题:如何让虚拟试衣更可信,以及如何在AI Agent产品中划清"聊天"与"事实"的边界。作为一个参考实现(reference implementation),它给出的答案值得开发者关注。
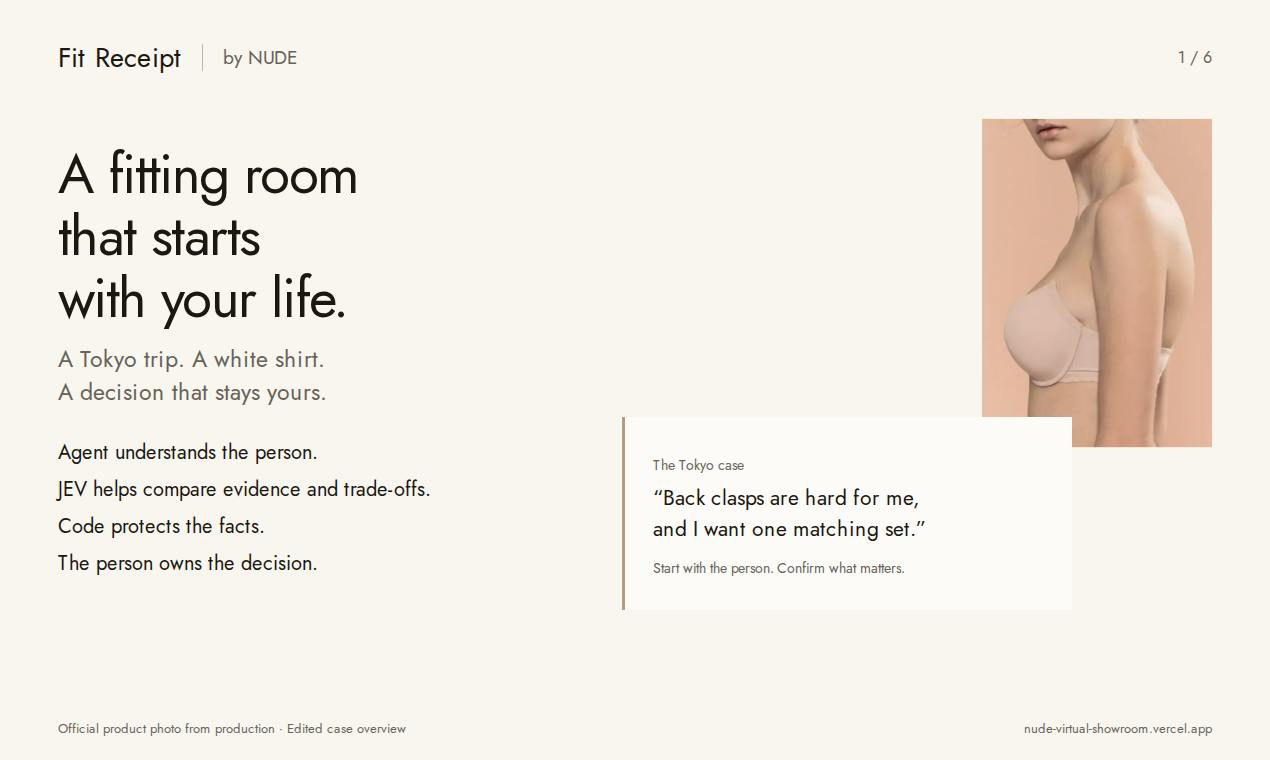
一个带"判决收据"的虚拟试衣工具
Fit Receipt的核心功能是在浏览器里虚拟试穿内衣,但它真正的卖点不在试穿本身,而在每一次选择都会附带一张"AI判决收据"(AI judgment receipt)。换句话说,产品不只告诉你某件商品是否合适,还会把判断依据记录下来,形成可追溯的凭证。
这种设计思路把"推荐"从黑箱变成了可审计的过程。对于内衣这类高度依赖尺码与个人偏好的品类,一个能解释"为什么推荐"的系统显然比单纯输出结果更有说服力。产品的定位横跨Productivity、Fashion与Developer Tools三个分类,也说明它并非纯粹的电商工具,而是带有明显的技术演示属性。
JEV:只在需要时被调用的判断模型
产品名中的JEV(TypeSafe)是整套系统的技术核心。按照官方描述,JEV是一个判断模型(judgment model),专门用来对权衡取舍打分,并给出经过校准的置信度(calibrated confidence)。它的响应速度约为300毫秒,输出的不是长篇大论,而是简洁的评分结果——"scores trade-offs, not essays"。
更关键的是它的调用逻辑。产品标语强调这是一个"知道何时该调用JEV"的Agent,意味着JEV并非每次都被触发。当判断结果置信度过低时,系统会保持"未决"状态(stay unresolved),而不是强行给出一个不可靠的答案。所有判断都会被记录,且整个流程在没有JEV的情况下依然能运行。
这套机制反映出一种务实的Agent设计哲学:模型只在有价值、有把握的场景介入,低置信度时宁可承认不确定,也不制造幻觉。对于依赖大模型输出的产品,这种"知道何时不作为"的能力往往比"什么都敢答"更重要。
「校准置信度」(calibrated confidence)是概率预测领域的一个核心概念,指模型输出的置信度数值与真实准确率之间的一致性。一个校准良好的模型,如果它说「我有80%的把握」,那么在大量此类预测中,它的实际准确率也应当接近80%。相比之下,未经校准的模型往往过度自信——即使内部不确定,也倾向于输出接近100%的置信度,这在医疗诊断、金融决策、商品推荐等场景中会造成严重误导。JEV的设计强调校准置信度,意味着它在输出评分的同时,会如实反映自身的不确定程度,从而让上层系统能够做出理性决策:置信度高时采纳判断,置信度低时保持悬而未决,而非掩盖不确定性强行给出答案。
Agent负责对话,代码负责守护事实
Fit Receipt提出了一条清晰的职责分工原则:Agent处理聊天,代码保护事实与定价(the agent handles chat; code protects facts and pricing)。
这是当前AI产品工程中一个愈发被重视的问题。大语言模型擅长自然交互,却不适合承担价格、库存、事实这类不容出错的信息输出。一旦把定价交给会"编故事"的模型,后果可能是灾难性的。Fit Receipt的做法是把这些关键事实用确定性的代码逻辑锁死,Agent只负责它擅长的对话层,从架构层面规避了幻觉风险。
这种"对话归对话、事实归代码"的分层,为其他构建垂直Agent的团队提供了一个可参考的范式。
这种分层设计在AI工程领域被称为「确定性护栏」(deterministic guardrails)模式。大语言模型的核心缺陷之一是「幻觉」(hallucination)——即以流畅的语言输出看似合理但实际错误的信息。对于价格、库存数量、法律条款、医学剂量等结构化事实,错误输出的代价远高于对话场景。因此,工程实践上的主流做法是:将此类数据存储在数据库或配置文件中,通过确定性代码逻辑读取和校验,模型只获得这些数据的只读视图,无法对其内容进行「创造性发挥」。Fit Receipt将这一原则明确纳入产品叙事,等于为开发者提供了一个清晰的架构决策框架:凡是「不允许出错」的信息,就不该由模型来「生成」,而应由代码来「查询」。
隐私设计:照片不离开浏览器
虚拟试衣绕不开一个敏感问题——用户照片。Fit Receipt在隐私上给出了相当克制的方案:
- 照片留在浏览器本地,服务器不存储任何照片(no server photo storage);
- JEV模型只能看到结构化的字段(typed fields),永远看不到照片;
- API做了限流(rate-limited)。
对于内衣试穿这种极度私密的场景,把图像处理限制在客户端、让判断模型只接触脱敏后的结构化数据,是一种符合隐私最小化原则的工程选择。它既保留了AI判断能力,又切断了照片外泄的路径。
「隐私最小化」(data minimization)是GDPR等数据保护法规的核心原则之一,要求系统仅收集和处理完成目标所必需的最少量个人数据。在本案例中,这一原则通过技术架构而非法律声明来实现:图像在客户端完成处理,服务器接收到的只是从图像中提取的结构化特征字段(如体型参数、尺码估算值),而非照片本身。这种「本地处理、只传元数据」的模式与苹果的「差分隐私」(differential privacy)思路一脉相承,即便服务器遭到攻击或数据泄露,也无法还原用户的原始图像。对于内衣这一涉及身体图像的高度敏感品类,这种架构选择不仅是隐私工程的最佳实践,也是降低合规风险的务实策略。
一次面向开发者的参考实现
值得强调的是,Fit Receipt反复自我定位为"reference implementation",并且是开源的、部署在Vercel上。它出现在Vercel Day活动中,收获11条评论、73票支持,更像是一次面向开发者社区的技术示范,而非成熟的消费级产品。
它想传递的信息其实很明确:如何在真实产品里负责任地使用判断模型——按需调用、校准置信度、承认不确定、隔离敏感数据、用代码守住事实底线。这些设计理念的价值,可能远超"虚拟试内衣"这个具体应用本身。
对于正在构建AI Agent的团队来说,Fit Receipt提供的不是一个可以直接抄的产品,而是一套关于"AI该在何时介入、又该如何被约束"的思考样本。
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。