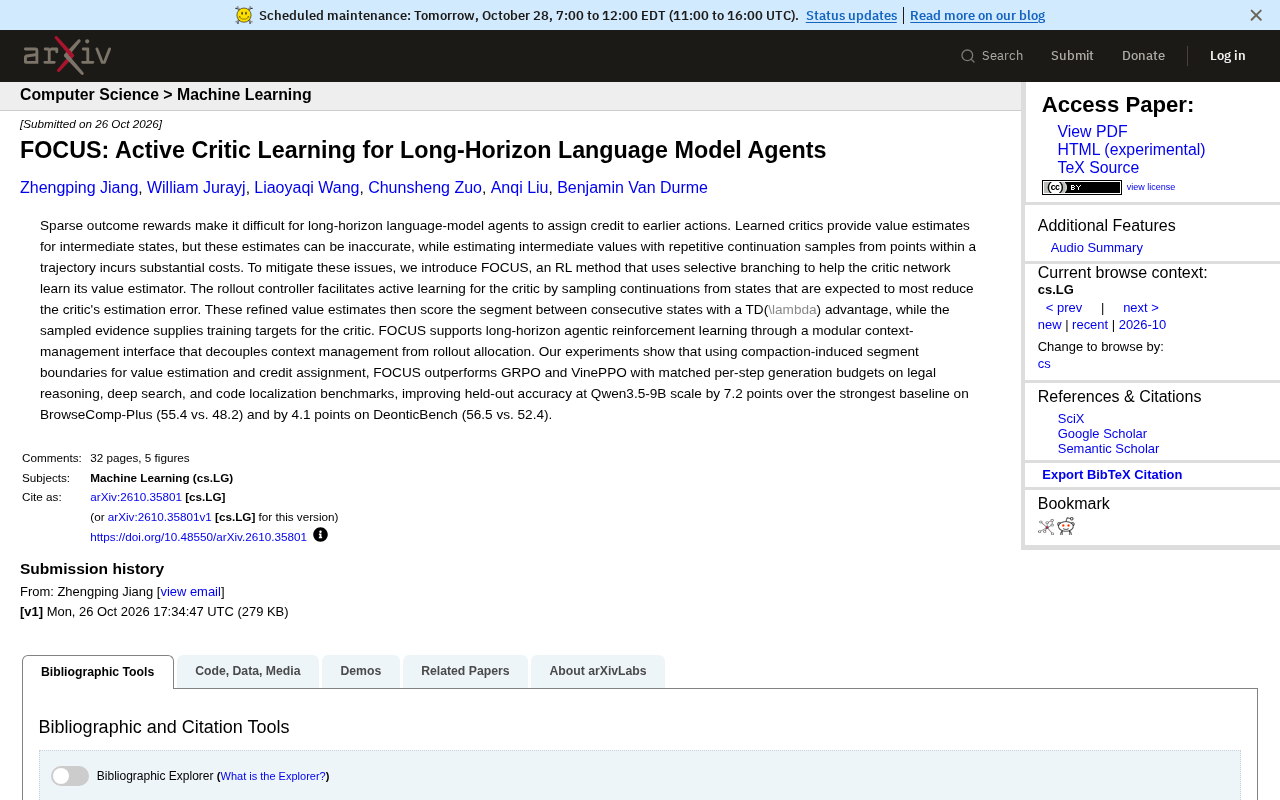
FOCUS:主动评论家学习破解长程智能体信用分配难题

FOCUS 用选择性分支和主动学习改进长程智能体的信用分配,在多个基准上超越 GRPO 与 VinePPO。
长程语言模型智能体在稀疏结果奖励下面临信用分配难题:最终奖励难以回溯到早期决策。传统方法要么依赖估值不准的评论家网络,要么在轨迹中间点均匀续写采样导致成本高昂。FOCUS 提出选择性分支机制,由 rollout 控制器主动挑选最能降低评论家估计误差的状态进行续写采样,将采样预算集中在高信息量区域,并用采样证据反哺评论家形成闭环。配合 TD(λ) 优势计算和模块化解耦的上下文管理,FOCUS 在 Qwen3.5-9B 规模的法律推理、深度搜索、代码定位三类基准上均优于 GRPO 和 VinePPO,预算匹配下 BrowseComp-Plus 提升 7.2 点、DeonticBench 提升 4.1 点。其泛化性与控制器自身误差仍是待验证的问题。
长程语言模型智能体在稀疏结果奖励下面临的核心难题是信用分配:当智能体执行数十甚至上百步操作后只得到一个最终奖励,如何判断哪一步真正起了作用?传统方法要么依赖学习到的评论家网络为中间状态估值,要么从轨迹中间点重复采样续写来估算价值,但前者估值不准,后者成本高昂。最近提出的 FOCUS 方法试图用“选择性分支”和主动学习来同时缓解这两个问题,在多个基准上取得了明显优于 GRPO 和 VinePPO 的表现。
稀疏奖励下的信用分配困境
长程智能体的强化学习与单步任务有本质区别。在数学推理或代码生成中,奖励信号通常可以相对直接地归因到输出;但在法律推理、深度搜索、代码定位这类任务里,智能体需要在多轮交互中逐步收集信息、调整策略,最终才得到一个对错判断。这个最终信号如何回传到早期的每一个决策上,就是信用分配问题。
据论文描述,稀疏的结果奖励使智能体很难将功劳或责任分配给较早的动作。学习到的评论家网络可以为中间状态提供价值估计,但这些估计可能不准确;而用重复的续写采样来估计中间价值,又会在轨迹的多个点上产生大量计算开销。这两条路各有代价,FOCUS 的设计思路是在两者之间找到一个更经济的平衡点。
评论家网络(critic network) 是 actor-critic 强化学习架构中的价值函数近似器,通常与策略网络(actor)共享或独立参数,负责为给定状态(或状态-动作对)输出一个标量价值估计。在长程智能体场景中,评论家需要在只有最终结果奖励的情况下学会判断“当前走到这一步,后续成功的概率有多大”。这本质上是一个回归问题,训练信号来自实际 rollout 的回报。问题在于,当轨迹很长而奖励极稀疏时,评论家早期看到的样本几乎都是失败轨迹,价值估计会高度同质化甚至坍缩,导致优势估计失真。FOCUS 选择性分支的一个直接动机,就是通过主动采集特定状态的后继结果来给评论家提供更有区分度的训练信号。
选择性分支:把采样预算花在刀刃上
FOCUS 的核心机制是“选择性分支”(selective branching)。与传统方法在每个状态都均匀采样续写不同,FOCUS 的 rollout 控制器会主动选择那些“预期最能降低评论家估计误差”的状态进行续写采样。换句话说,它不再盲目地到处采样,而是让评论家网络主动“提问”:我在哪些状态上最没把握?然后针对这些状态补充证据。
这种主动学习式的采样策略带来两个好处。其一,采样预算被集中用在评论家最不确定的区域,提升了单位采样成本的信息增益。其二,采样得到的证据既用于改进评论家的价值估计,又作为训练目标反哺评论家网络,形成一个闭环。论文将其描述为“通过选择性分支帮助评论家网络学习其价值估计器”。
VinePPO 是 FOCUS 的主要对比基线之一,其核心思想是在轨迹的中间状态处进行多次续写采样,用这些续写的经验回报均值作为该状态价值的蒙特卡洛估计,从而替代学习到的评论家。这种做法绕开了评论家估值不准的问题,但代价是每个中间点都需要额外的 rollout,采样开销随分支点数量线性增长。FOCUS 的选择性分支可以看作对 VinePPO 的“稀疏化”改造:不再对每个状态都做续写,而是由控制器挑选信息量最高的状态子集。理解这一对比有助于把握 FOCUS 的定位——它并非抛弃续写采样,而是把 VinePPO 的均匀预算改为自适应预算。
TD(λ) 优势与模块化上下文管理
在获得更精细的价值估计后,FOCUS 使用 TD(λ) 优势来为连续状态之间的片段打分。TD(λ) 是强化学习中的经典技术,能够在偏差与方差之间取得折中,适合长程场景下的信用分配。 refined 的价值估计配合 TD(λ),使得片段级别的优势计算更加可靠。
另一个值得关注的工程点是模块化的上下文管理接口。长程智能体的上下文会不断膨胀,压缩(compaction)几乎是必需的操作。FOCUS 将上下文管理与 rollout 分配解耦,使得压缩产生的片段边界可以直接用于价值估计和信用分配。这种设计让方法在面对不同上下文管理策略时保持灵活性,而不是把两者绑死。
TD(λ) 是时序差分学习中的一种多步回报方法,通过参数 λ∈[0,1] 在单步 TD 目标(低方差、高偏差)与蒙特卡洛回报(高方差、低偏差)之间做指数加权插值。λ=0 时退化为单步 TD,λ=1 时退化为完整轨迹回报。在长程信用分配中,TD(λ) 的优势在于它能把最终结果奖励沿轨迹逐步回传,同时用价值估计截断过长的回报链路以控制方差。FOCUS 在获得更精细的评论家估值后使用 TD(λ) 计算片段级优势,相当于让“可信的中间估值”承担 bootstrap 角色,把稀疏的终局奖励拆解为一系列可学习的局部信号。λ 的取值直接影响偏差-方差权衡,实践者通常需要按任务长度调整。
实验结果:在三个基准上超越强基线
论文在合法推理、深度搜索和代码定位三类基准上进行了实验,对比对象是 GRPO 和 VinePPO,且在每步生成预算匹配的条件下比较。据论文数据,在 Qwen3.5-9B 规模上,FOCUS 在 BrowseComp-Plus 上比最强基线提升了 7.2 个百分点(55.4 对 48.2),在 DeonticBench 上提升了 4.1 个百分点(56.5 对 52.4)。
这些提升的幅度在强化学习对比中不算小,尤其是在预算匹配的前提下,说明增益并非来自更多的采样量,而是来自采样位置的選擇和信用分配机制的改进。不过也需要看到,实验集中在特定规模(9B)和特定基准上,方法在更大模型和更广泛任务上的泛化性还有待验证。
对长程智能体训练的启示
FOCUS 的思路反映了一个更广泛的趋势:长程智能体的强化学习正在从“堆算力、堆采样”转向“更聪明地分配采样”。当轨迹长度增加时,均匀采样的成本会急剧上升,而主动选择高信息量状态进行分支,可能是更可持续的路径。
话说回来,将上下文管理与 rollout 分配解耦的设计也值得借鉴。长程任务中上下文压缩不可避免,如果压缩边界能顺带服务于信用分配,就相当于一鱼两吃。对于正在构建智能体训练管线的团队来说,FOCUS 提供的模块化视角比单一算法细节更有参考价值。
当然,主动学习式的评论家训练也引入了额外的复杂度:如何准确估计“哪个状态最能降低误差”本身就是个问题,控制器本身的误差可能影响采样效率。论文没有在摘要中展开这部分细节,实际落地时的调参成本需要实践者自行评估。
相关推荐
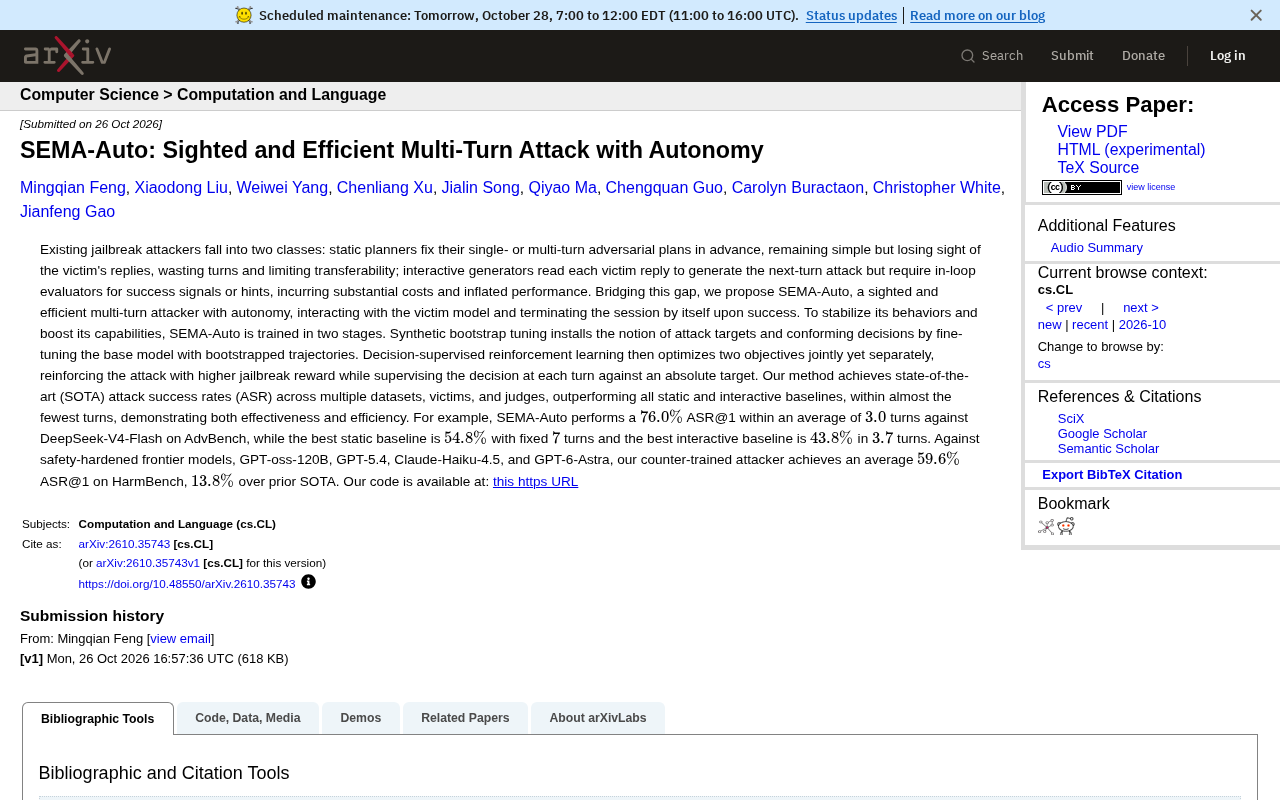
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
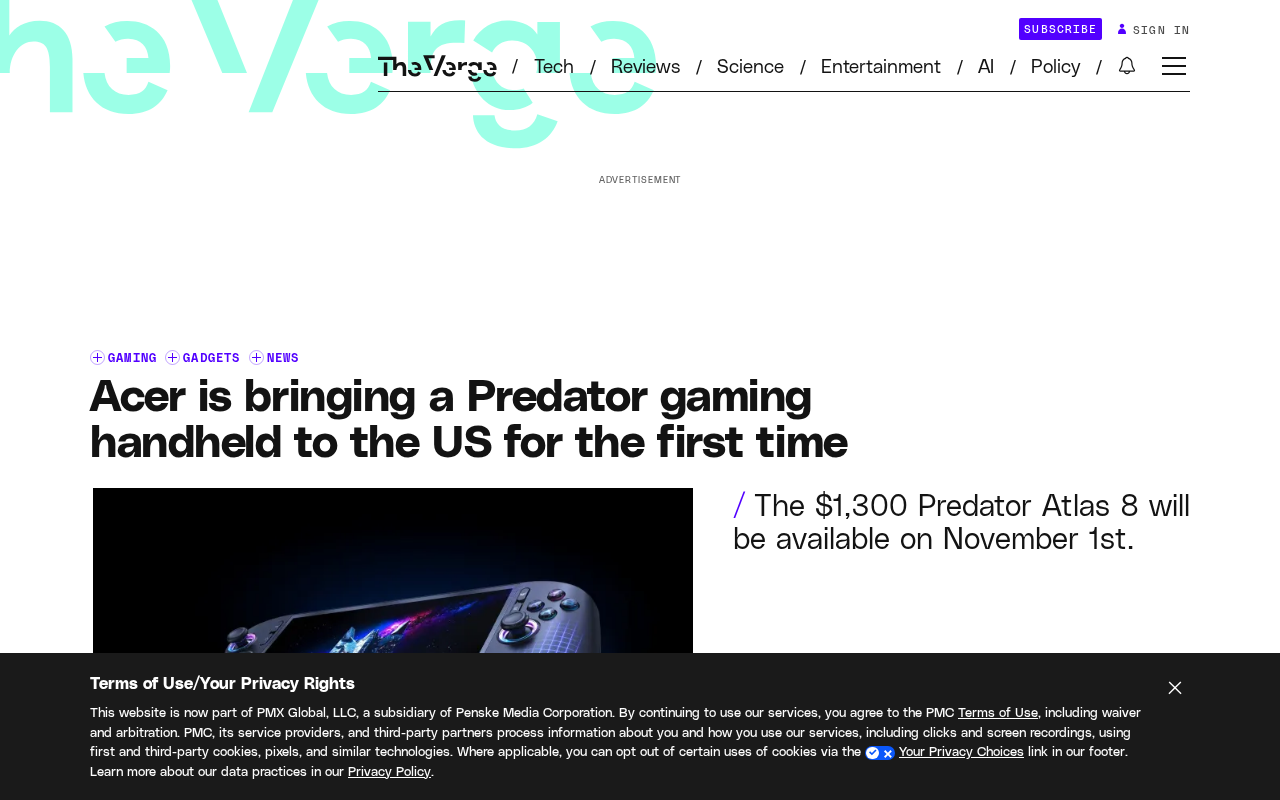
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。