ForeSeek:预判驱动的长视频推理新范式

ForeSeek 用预判驱动替代反应式检索,让多模态智能体以更少帧数理解长视频。
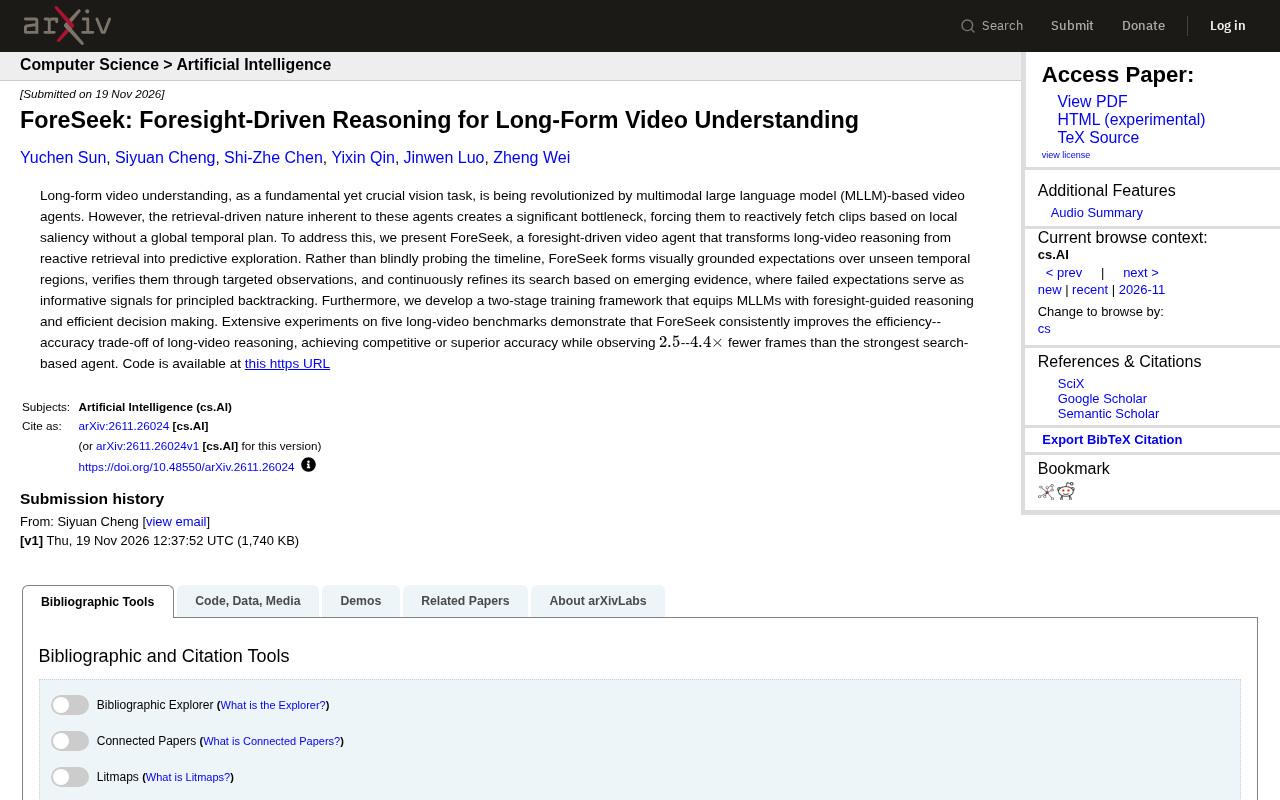
ForeSeek 针对长视频理解中检索驱动智能体缺乏全局时间规划的问题,提出预判驱动的新范式:模型先对未观察的时间区域形成视觉接地的预期,再通过定向观察验证假设,并将失败预期转化为有原则的回溯信号。为支撑这一循环,ForeSeek 设计了两阶段训练框架,为多模态大模型注入预判引导推理与高效决策能力。在五个长视频基准上,该方法以比最强搜索式智能体少 2.5 至 4.4 倍的观察帧数,取得有竞争力或更优的准确率。论文认为这一“预测-验证-回溯”范式可迁移至其他需要在庞大搜索空间中定位关键信息的任务,代码已开源。
长视频理解一直是个棘手的多模态任务:信息密度低、时序跨度大,模型很容易在冗余帧里“迷路”。现有基于多模态大模型的视频智能体大多采用检索驱动策略——根据局部显著性反应式地抓取片段,缺乏全局时间规划。ForeSeek 提出了一种预判驱动(foresight-driven)的新思路,把长视频推理从“被动检索”转变为“主动预测探索”,在多个基准上以更少的帧数取得了有竞争力甚至更优的准确率。
从反应式检索到预判式探索
检索驱动智能体的瓶颈在于“没有全局视野”:面对长达数小时视频,它只能依据当前片段的局部显著性决定下一步看哪里,像一个没有地图的搜索者,反复在时间轴上试探。ForeSeek 的核心主张是让模型先对未观察的时间区域形成视觉接地的预期,再通过定向观察去验证这些预期。
这种“先预测、再验证”的循环有几个好处。模型不必盲目扫描时间轴,而是带着假设去查找证据;当预期落空时,失败本身也成为有价值的信息,指引模型进行有原则的回溯。这与人类观看长视频的认知方式颇为相似——我们会根据上下文猜测接下来可能发生什么,然后快速跳到关键位置确认。
视觉接地的预期(visually grounded expectation) 是理解 ForeSeek 的关键概念。在多模态大模型语境下,“接地”指模型的语义预测必须锚定到具体的视觉证据,而非停留在抽象文本层面。具体到长视频,模型需要根据已观察片段,预测某个未来时间窗口内可能出现的视觉内容(例如“接下来应该出现人物打开门的镜头”),并把这一预期表示为可检索的查询或定位信号。与纯文本猜测不同,视觉接地预期要求模型能够把高层语义假设映射回时间轴上的具体位置,从而支持定向跳转。这一机制也解释了为何失败预期具有回溯价值:当预期与观察不符时,模型可以据此推断关键事件在时间轴上的实际偏移方向,而不是盲目重扫。
两阶段训练框架:让 MLLM 学会“预判”
仅有推理框架还不够,多模态大模型本身需要具备预判引导的推理能力和高效决策能力。为此,ForeSeek 设计了两阶段训练框架,把预判式推理和高效决策注入 MLLM。具体训练细节论文未在摘要中展开,但可以明确的是,这一框架的目标是让模型学会在探索过程中持续根据新出现的证据修正搜索方向,而不是一次性规划到底。
预判式推理的难点在于平衡“猜测”与“证据”。预期过于宽泛则失去指导意义,过于具体又容易频繁失败。ForeSeek 通过让失败预期充当回溯信号,把预测误差转化为搜索效率的来源,这一设计思路值得关注。
多模态大模型(MLLM)作为视频智能体的骨干,其能力边界决定了探索策略的上限。通用 MLLM 通常在图像-文本对上预训练,擅长单帧或短片段理解,但缺乏在长时序上做多步决策的经验。要让 MLLM 承担“预测-验证-回溯”的循环,需要针对性训练其两类能力:一是基于部分观察生成时间定位假设的预判推理,二是在有限观察预算下决定下一步看哪里的高效决策。两阶段训练的意义在于解耦这两类能力——先让模型学会“猜得准”,再让模型学会“看得省”,避免同时优化导致的训练不稳定。这也解释了为何 ForeSeek 强调训练框架而不仅是推理提示工程。
效率与精度的重新平衡
长视频理解长期面临效率与精度的权衡:看得帧越多,准确率通常越高,但计算成本也水涨船高。ForeSeek 在五个长视频基准上的实验显示,它能在观察到比最强搜索式智能体少 2.5 到 4.4 倍帧数的情况下,取得有竞争力或更优的准确率。
这一结果的意义不只是“更省算力”。帧数大幅减少意味着模型可以在相同预算下处理更长的视频,或者在同等视频长度下降低延迟,这对视频问答、内容审核、长视频摘要等实际应用都有直接价值。论文代码已在 GitHub 开源,便于社区复现和进一步验证。
长视频基准(long-video benchmarks) 通常指视频时长从数分钟到数小时、需要跨片段时序推理才能回答问题的评测集,典型任务包括长视频问答、事件定位与视频摘要。这类基准的核心难点在于信息稀疏:与问题相关的片段可能只占全视频的极小比例,而无关帧构成巨大搜索空间。因此,评价一个视频智能体不能只看准确率,还要看它消耗了多少帧或多少观察步数。ForeSeek 报告的“少 2.5 到 4.4 倍帧数”正是在这一评价逻辑下才有意义——它衡量的是单位观察预算下的信息获取效率,而非单纯的模型容量优势。
预判式推理的启示
ForeSeek 的价值在于提出了一种可复用的范式:把智能体的探索过程从“被动响应局部信号”升级为“主动维护全局假设”。这一思路未必局限于视频理解——任何需要在庞大搜索空间中定位关键信息的任务,都可能从“预测-验证-回溯”的循环中受益。
当然,预判驱动也带来新的问题:预期如何表示、失败信号如何量化、两阶段训练的数据从何而来,这些都需要在完整论文中寻找答案。对关注多模态智能体与长视频理解的研究者和工程师来说,ForeSeek 提供了一个值得跟进的探索方向。
相关推荐
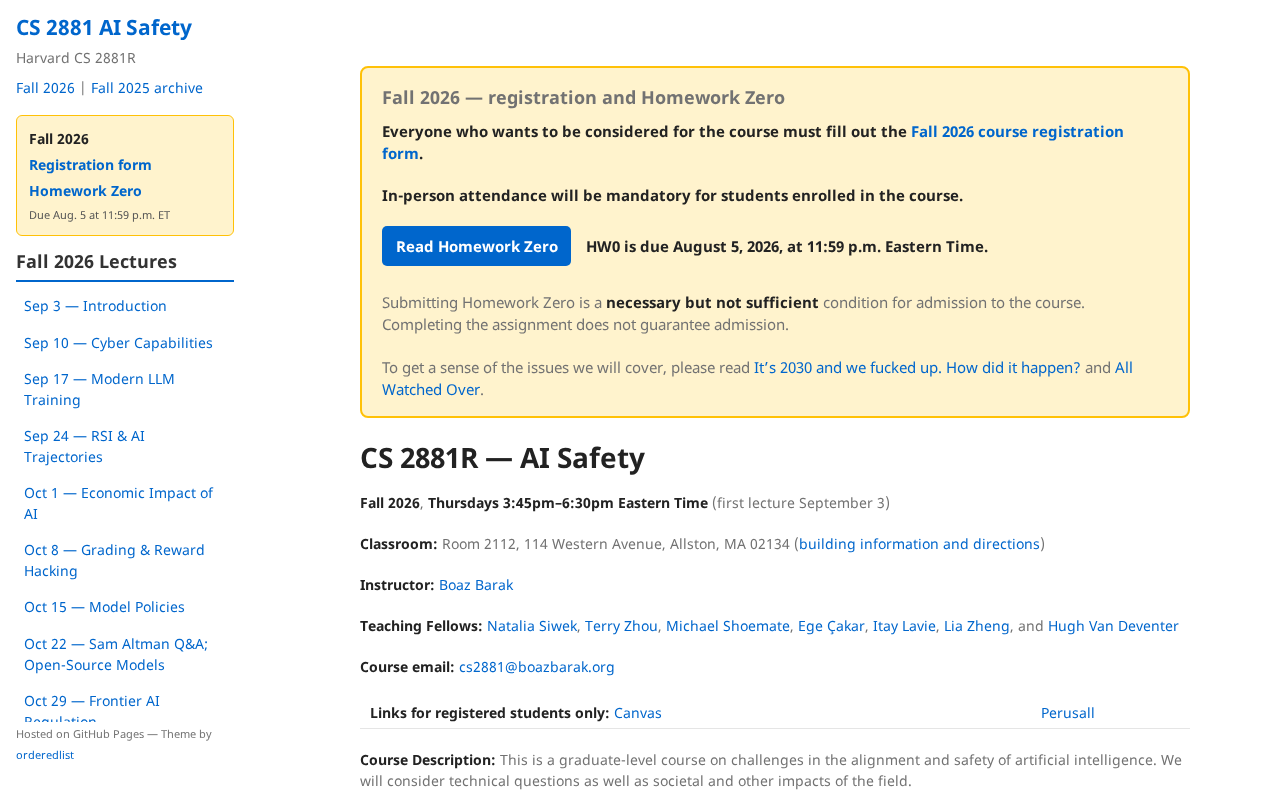
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。