改写题目能让LLM更会解题?效果取决于问题类型

改写问题陈述能提升LLM解题准确率,但收益取决于改写方式与问题类型的匹配。
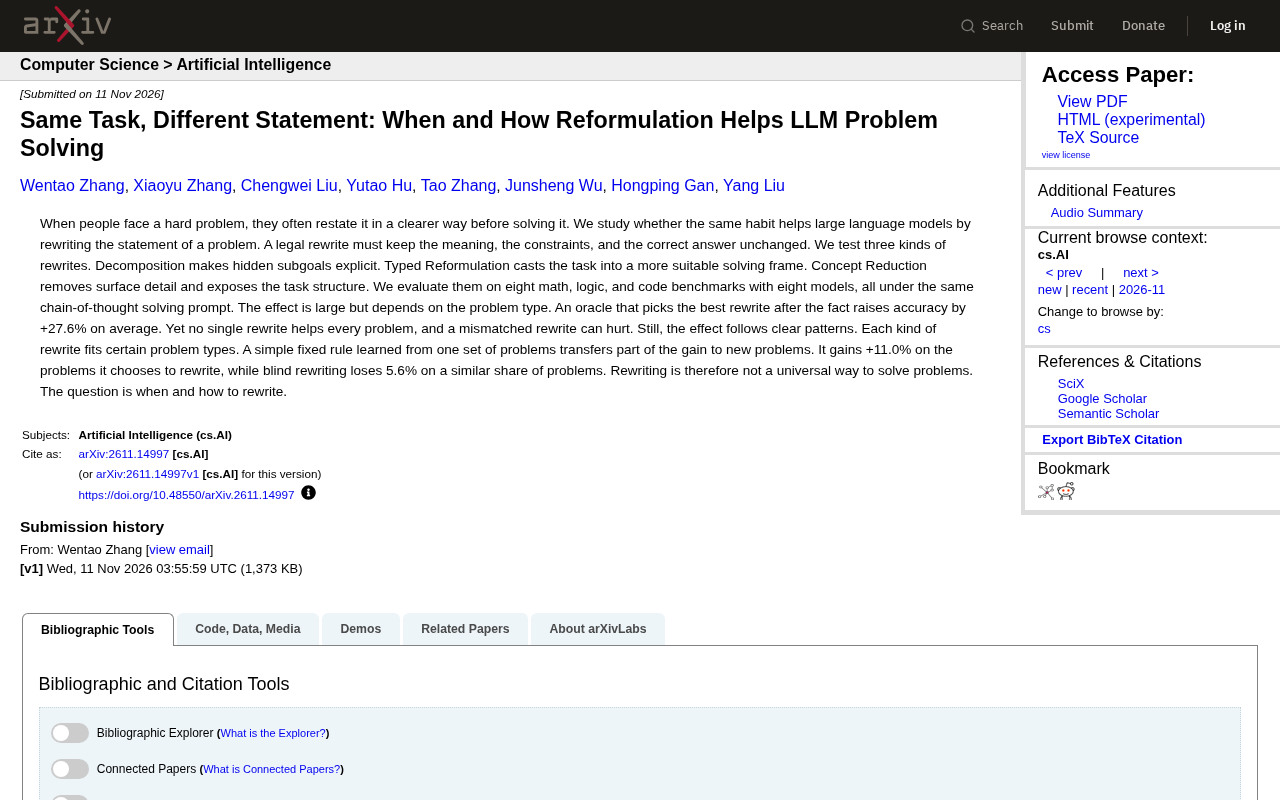
研究系统考察了让大语言模型“改写问题陈述”再解题的效果,定义了分解、类型化重构、概念约简三种保持语义与答案不变的合法改写策略,并在八个数学、逻辑与代码基准、八个模型上以统一思维链提示进行评测。结果显示,若能事后为每题挑选最优改写,平均准确率可提升27.6%,说明改写空间增益可观;但没有任何单一改写对所有问题有效,不匹配的改写甚至会降低表现。增益遵循问题类型与策略的匹配模式而非随机分布。从一组问题学到的简单固定规则可迁移部分增益:选择性改写提升11.0%,而相近比例的盲目改写损失5.6%。核心结论是应关注“何时改写、如何改写”,而非“是否改写”。
人与难题缠斗时,常会先用自己的话把问题重新表述一遍,理清思路再动手。这种习惯能否迁移给大语言模型?一项研究系统考察了「改写问题陈述」对LLM解题的影响,结论并不简单:改写确实能大幅提升准确率,但前提是改写方式与问题类型匹配,否则可能适得其反。
三种改写策略:从拆解到抽象
研究定义了三种合法的改写方式,要求改写后语义、约束条件和正确答案均保持不变。
分解(Decomposition):把隐藏的子目标显式化,让模型看到原本隐含的解题步骤。类型化重构(Typed Reformulation):将任务转换到更合适的求解框架中,相当于换一种「语言」描述同一个问题。概念约简(Concept Reduction):剥离表面细节,暴露任务的结构骨架。
这三种策略分别对应人类解题时的不同直觉:拆步骤、换视角、抓本质。研究在八个数学、逻辑和代码基准上、用八个模型进行评测,所有模型使用相同的思维链(chain-of-thought)提示,以隔离改写本身的影响。
思维链(Chain-of-Thought, CoT)提示是让大语言模型在给出最终答案前,先输出中间推理步骤的一种提示技术。其核心思想源于人类解题时“把思路写出来”的习惯:模型被引导生成“首先……然后……因此……”这类显式推理序列,从而把隐含的多步计算外化为可追踪的文本。CoT 在数学应用题、逻辑推理和符号操作任务上能显著提升准确率,尤其对参数量较大的模型效果更明显。本研究中所有模型统一使用 CoT 提示,目的是把“改写问题”与“改变推理方式”两个变量分离开,使观测到的准确率差异能够归因于改写策略本身,而非提示格式的变化。
效果显著,但没有「万能改写」
最引人注目的数据来自一个「事后先知」式的上界估计:如果能在看到结果后为每道题挑选最合适的改写,平均准确率可提升 +27.6%。这说明改写空间中蕴含的增益非常可观。
但关键陷阱在于:没有任何一种改写对所有问题都有效,不匹配的改写甚至会拉低表现。换言之,改写不是「免费的午餐」,盲目改写可能引入误导性框架或丢失关键约束。
增益并非随机分布,而是遵循清晰模式——每种改写方式都适配特定类型的问题。分解适合子目标隐蔽的多步推理题,类型化重构适合需要转换求解范式的任务,概念约简则适合表面信息冗余、结构清晰的题目。这一发现将问题从「是否改写」转向「何时改写、如何改写」。
**“事后先知”上界(oracle upper bound)**是机器学习评测中常用的一种理想化基准:假设存在一个全知的选择器,能在看到每道题的正确答案后,为每道题挑选表现最好的方法或配置,据此计算出的平均性能即为上界。它并不代表实际可部署的系统,而是用来衡量“如果选择完全正确,方法空间中最多能挖出多少增益”。本研究用这一上界估计改写空间的潜力,得到 +27.6% 的提升幅度。把上界与实际固定规则的表现(+11.0%)对比,两者的差距正好刻画了“选择器不够完美”所造成的损失,也说明提升选择判断力是后续研究的关键方向。
固定规则也能迁移部分增益
一个更实用的发现是:从一组问题上学习到的简单固定规则,可以部分迁移到新问题上。该规则在它选择改写的题目上获得 +11.0% 的提升,而在相近比例的问题上,盲目改写反而损失 5.6%。
这组对比揭示了改写的真实价值:不在于「改写」这个动作本身,而在于「选择性改写」的判断力。一个简单的分类规则就能捕获相当一部分增益,说明问题类型与改写策略之间的对应关系具有一定的可学习性和泛化性。
选择性改写与盲目改写的对照需要放在同一基准下理解:前者指规则先判断题目类型、只在预测适配的题目上施加改写,后者指对相近比例的问题不加区分地统一改写。两者覆盖的题目数量大致相当,因此 11.0% 的提升与 5.6% 的损失可以直接比较,差额反映的是“判断力”本身的价值,而非改写覆盖率的差异。这也解释了为何简单的固定规则仍能迁移部分增益:问题类型与改写策略之间存在可学习的统计关联,即便规则很粗糙,只要它在该改写时改写、不该改写时保持原题,期望收益就为正。
对提示工程的启示
这项研究对日常使用LLM解题有直接启发。思维链提示已被广泛采用,但改写问题陈述是一个独立且可叠加的维度。实践中,与其对所有问题统一套用某种改写模板,不如先判断问题类型,再决定改写策略——多步推理题尝试显式拆解子目标,范式不匹配的题尝试重新表述求解框架,信息冗余的题则做概念约简。
研究也提醒我们警惕「改写幻觉」:看似更清晰的表述可能悄悄改变了约束条件或引入错误假设。合法的改写必须严格保持语义与答案不变,这一约束在实际应用中需要仔细校验。
结语
改写问题陈述对LLM解题有实质帮助,上限可观,但收益高度依赖问题类型与改写策略的匹配。选择性改写优于盲目改写,简单规则可迁移部分增益。真正的问题不是「要不要改写」,而是「对什么问题、用什么方式改写」。
相关推荐

间谍蜜罐训练内幕:情感解离与锚定技术
间谍如何被训练执行蜜罐任务?一位受训者披露情感解离、香水与关键词锚定、目标照片绑定等心理学技术,解析条件反射如何被用于情报行动,并揭示这套机制在日常生活营销中的类似应用。

前沿AI风险管理:从训练到部署的全链路实践
OpenAI系统阐述前沿AI风险管理框架:从训练阶段的模型对齐,到部署阶段的沙箱隔离与阻断式防护,再到部署后的持续监控,构建贯穿模型全生命周期的分层风险控制体系。

Databricks推出Genie Migrate,简化Serverless迁移
Databricks 发布 Genie Migrate for Serverless,帮助用户将既有工作负载迁移到 Serverless 计算。本文解析该迁移工具的定位、对用户的实际意义以及尚未明确的细节。