GAI框架:统一迭代策略改进与递归自我改进的形式化理论
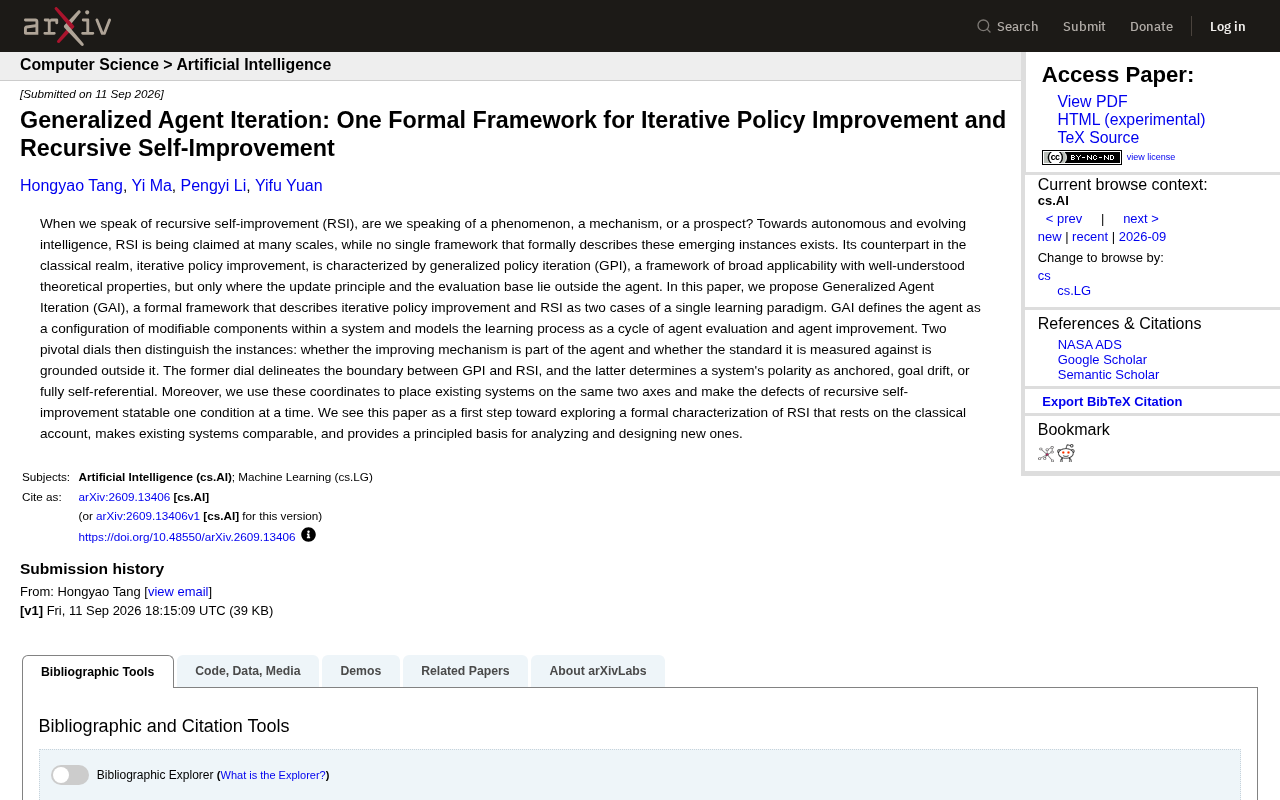
GAI框架用两个形式化旋钮统一描述传统强化学习与递归自我改进,为AI安全分析提供共同坐标系。
一篇arXiv论文提出"广义智能体迭代"(GAI)框架,试图为"递归自我改进"(RSI)这一被广泛援引却定义模糊的概念建立形式化基础。框架的核心是将经典强化学习中的广义策略迭代(GPI)与RSI统一为同一学习范式的两种特例,关键在于两个"旋钮":其一,改进机制是否属于智能体自身;其二,衡量标准是否外置于智能体之外。第二个旋钮进一步将系统分为锚定型、目标漂移型和完全自指型三类,与AI对齐中最受关注的失控场景直接对应。该框架的实用价值在于让不同系统可在同一坐标轴上横向比较,并使RSI的潜在缺陷"逐条可陈述",而非笼统的"可能失控"。论文定位为初步探索,价值不在于提出新算法,而在于建立共同的概念语言。
递归自我改进究竟是什么?
当我们谈论递归自我改进(Recursive Self-Improvement, RSI)时,究竟指的是一种现象、一种机制,还是一种可能性?这个看似哲学化的追问,正是一篇新发表于 arXiv 的论文(arXiv:2609.13406v1)试图厘清的核心问题。
在通向自主进化智能的道路上,RSI 这一概念被广泛援引,从模型自我微调到智能体自主重写代码,各种规模的系统都在宣称实现了某种形式的自我改进。但问题在于,学界至今缺乏一个能够形式化描述这些新兴案例的统一框架。换句话说,大家都在用同一个词,却指向了截然不同的东西。
这篇论文提出的 广义智能体迭代(Generalized Agent Iteration, GAI) 框架,正是为了填补这一空白。它的野心在于:把经典强化学习中的迭代策略改进与前沿的递归自我改进,纳入同一个学习范式来描述。
从 GPI 到 GAI:经典范式的延伸
要理解 GAI 的意义,需要先回到它的经典对应物——广义策略迭代(Generalized Policy Iteration, GPI)。
GPI 是强化学习领域一个应用广泛、理论性质被充分理解的框架,它将策略学习刻画为「策略评估」与「策略改进」交替进行的循环。但 GPI 有一个隐含的前提:更新原则(update principle)和评估基准(evaluation base)都位于智能体之外。也就是说,改进智能体的那套机制,以及衡量它好坏的标准,都是外部给定的、固定不变的。
这恰恰是 GPI 无法覆盖 RSI 的原因。递归自我改进的关键特征,正是智能体开始改造那些原本外置的机制——它不仅在优化策略,还在优化「如何优化策略」这件事本身。
GAI 的做法是把智能体重新定义为系统中一组可修改组件的配置(configuration),并把学习过程建模为「智能体评估」与「智能体改进」的循环。这个抽象层次的提升,使得 GPI 和 RSI 能够被视为同一学习范式下的两种特例。
两个关键旋钮:区分 GPI 与 RSI
GAI 框架的精妙之处,在于它用**两个关键「旋钮」(dials)**来区分不同的实例,这也是整篇论文最具操作性的贡献。
第一个旋钮:改进机制是否属于智能体?
第一个维度关注的是:那个负责改进的机制,究竟是不是智能体自身的一部分?
- 如果改进机制在智能体之外(比如由人类设计的固定优化器),那么这就落在 GPI 的范畴;
- 如果改进机制本身也是智能体可修改的组件,那么它就跨入了 RSI 的领域。
这个旋钮划定了 GPI 与 RSI 之间的边界,把一个长期模糊的分界线变成了可以明确判定的条件。
第二个旋钮:衡量标准是否外置?
第二个维度则决定了系统的「极性」(polarity)——即衡量智能体好坏的标准是否扎根于智能体之外。根据这个旋钮,系统可以被划分为三种类型:
- 锚定型(anchored):评估标准完全外置,系统始终对齐一个外部目标;
- 目标漂移型(goal drift):标准部分内化,系统的目标可能随改进过程发生偏移;
- 完全自指型(fully self-referential):标准完全由系统自身定义,智能体既是运动员又是裁判员。
这三种极性对理解 AI 安全问题极具价值——「目标漂移」和「完全自指」恰恰对应了对齐研究中最令人担忧的场景。
让 RSI 的缺陷「逐条可陈述」
GAI 框架真正的实用价值,体现在它把不同系统放到了同一套坐标系之上。
借助上述两个旋钮构成的坐标,研究者可以将现有的各类系统——无论是传统的强化学习智能体,还是宣称具备自我改进能力的前沿系统——标定在相同的两个轴上进行比较。这意味着过去那些「各说各话」的 RSI 声明,第一次有了可以横向对照的共同语言。
更重要的是,论文指出这套坐标能够让递归自我改进的缺陷变得「逐条可陈述」(statable one condition at a time)。也就是说,一个自我改进系统可能出现的问题,不再是笼统的「它可能失控」,而是可以拆解为具体的、单个条件层面的分析对象。这为形式化地分析 RSI 的风险提供了扎实的抓手。
意义与局限
作者将这篇论文定位为「第一步」——一次基于经典理论、尝试对 RSI 进行形式化刻画的初步探索。它的三重目标清晰:立足经典的策略迭代理论、使现有系统可比较、为分析和设计新系统提供原则性基础。
从研究价值看,GAI 的贡献不在于提出某个具体算法,而在于建立一套共同的概念坐标系。在 RSI 概念被大量滥用、缺乏严格定义的当下,这种「先把话说清楚」的工作往往比又一个新模型更为稀缺,也更为重要。
当然,作为一篇理论性的框架论文,它的实际影响仍有待观察:GAI 的抽象定义能否被广泛采纳为社区通用语言,能否真正指导实证系统的设计与评估,都需要后续工作来验证。但至少,它为「递归自我改进」这一充满想象力却又含糊的概念,提供了一个值得认真对待的形式化起点。
相关推荐
Vercel AI SDK 更新:sandbox-just-bash 组件发布补丁版本
Vercel AI SDK 组件 @ai-sdk/sandbox-just-bash 发布 1.0.111 补丁版本,同步更新 harness 依赖。本文解读此次更新内容及其对开发者的意义。
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新,主要同步升级底层依赖 ai@7.0.101。本文解析该版本更新内容、React 集成能力及开发者升级建议。
Vercel AI SDK 发布 @ai-sdk/rsc@3.0.101 补丁更新
Vercel AI SDK 发布 @ai-sdk/rsc@3.0.101 补丁更新,同步升级 ai 核心包至 7.0.101。本文解读该版本的更新内容、@ai-sdk/rsc 的作用及对开发者的影响。