Gamer:面向长时任务的通用视觉-语言-动作基础模型
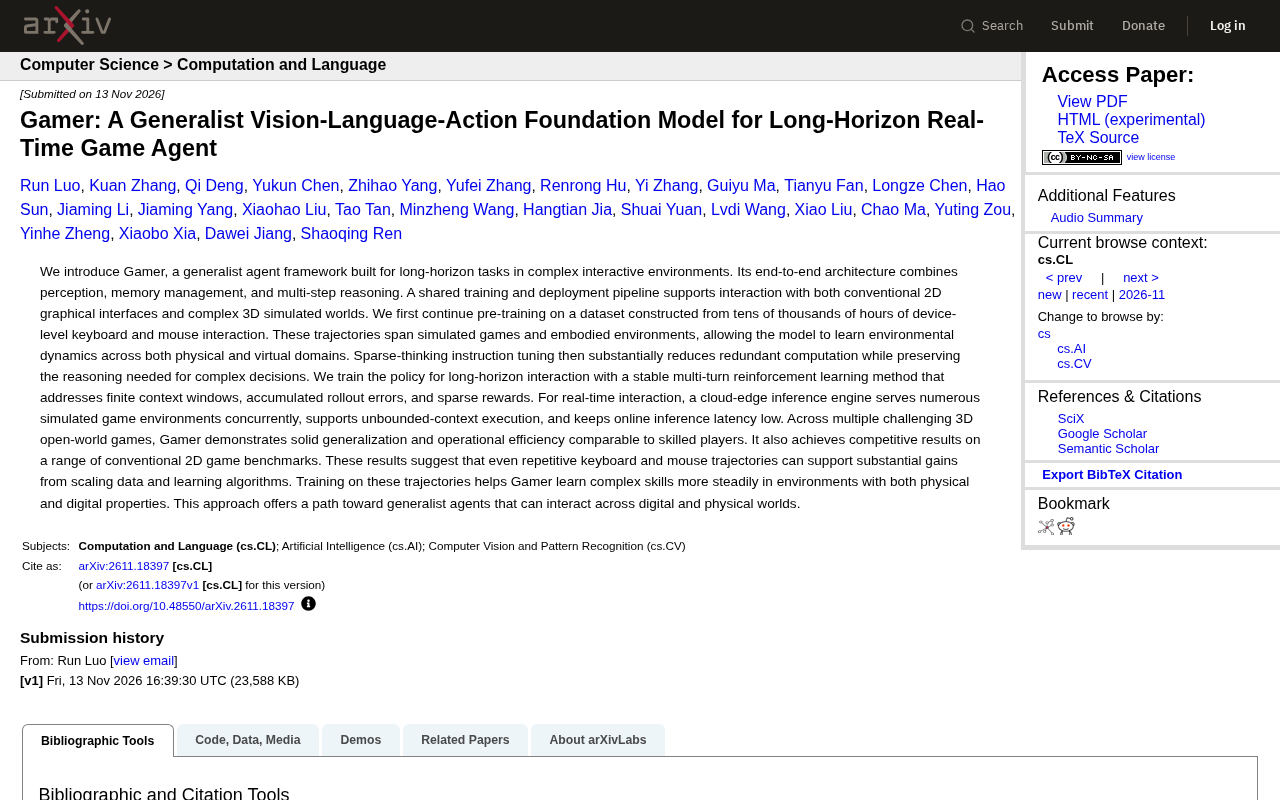
Gamer以端到端架构统一感知记忆推理,用键鼠轨迹训练跨2D与3D的通用游戏智能体。
Gamer是一个面向通用游戏智能体的端到端框架,将感知、记忆管理与多步推理整合进单一模型,并用同一套训练与部署管线兼容2D图形界面和3D模拟世界。其训练起点是数万小时设备级键鼠交互轨迹,经持续预训练后引入稀疏思考指令微调以削减冗余计算,再通过稳定的多轮强化学习应对有限上下文、rollout误差累积与稀疏奖励三大长时交互难题。配套的云边推理引擎支持大量环境并发与无界上下文执行。在多个3D开放世界游戏和2D基准上,Gamer展现出接近熟练玩家的泛化能力,为跨越数字与物理世界的通用智能体提供了可复用路径。
游戏智能体正从单一任务演示走向通用化。最新提出的Gamer框架,试图用一套端到端架构打通2D图形界面与3D模拟世界的长时交互,为通用智能体提供了一条可复用的技术路径。
统一感知、记忆与推理的端到端架构
Gamer的核心设计是将感知、记忆管理和多步推理整合进一个端到端模型。与常见将感知、规划、执行拆分为独立模块的智能体方案不同,这种一体化结构让模型在长时任务中能持续维持对环境的内部表征,而非在每个决策步重新拼接上下文。
支撑这一架构的是一套共享的训练与部署管线,同时兼容传统2D图形界面和复杂的3D模拟世界。这意味着同一模型无需为不同环境重写接口逻辑,降低了跨域迁移的工程成本。对于需要长期运行的游戏智能体而言,架构的统一性直接决定了它能否在环境切换时保持行为一致性。
从数万小时键鼠轨迹中学习环境动态
Gamer的训练起点并非精心标注的任务数据集,而是从设备层面采集的键盘与鼠标交互轨迹,累计时长达到数万小时。这些轨迹覆盖模拟游戏与具身环境,使模型得以在物理与虚拟两个域中同时学习环境动态。
这一选择值得关注:键鼠轨迹本身高度重复、信噪比低,通常被认为不适合作为通用能力的学习信号。但Gamer的结果表明,只要数据规模与学习算法同步扩展,即便是重复性操作轨迹也能支撑复杂技能的稳定习得。这为“数据 Scaling 能否弥补信号质量不足”提供了一个正面案例。
持续预训练(Continual Pre-Training) 指在已具备通用能力的基座模型上,用领域相关数据继续进行下一词预测式训练,使模型习得该领域的统计规律与行为模式,而非从零训练。与指令微调不同,它不依赖任务标注,只依赖原始序列数据,因此特别适合键鼠轨迹这类无标签、低信噪比的信号。Gamer在此阶段让模型从海量交互序列中隐式学习“按键—画面变化”的因果动态,为后续指令微调和强化学习提供具备环境常识的初始化权重,这也是低质量轨迹能转化为可用能力的前提。
稀疏思考指令微调:削减冗余计算
在持续预训练之后,Gamer引入稀疏思考(Sparse-thinking)指令微调。其目标是压缩推理过程中的冗余计算,同时保留复杂决策所需的推理能力。
长时任务智能体面临的一个现实矛盾是:推理越充分,决策质量越高,但实时性越差。稀疏思考通过让模型在多数步骤走轻量路径、仅在关键节点展开推理,缓解了这一矛盾。原文强调该步骤“大幅减少冗余计算”,但未披露具体压缩比例,其实际收益仍需后续评测验证。
多轮强化学习破解长时交互三大难题
策略训练阶段采用了一种稳定的多轮强化学习方法,针对性解决长时交互中的三类问题:有限上下文窗口、累积的 rollout 误差以及稀疏奖励。
这三者相互耦合——上下文窗口有限导致历史信息丢失,误差随回合累积放大,稀疏奖励又让信用分配变得困难。Gamer的方法在训练稳定性上做了专门设计,使模型能够在长回合中保持策略一致,而非在数十步之后行为漂移。这是长时任务智能体区别于短程任务智能体的关键工程挑战。
rollout 误差累积 是强化学习在长回合任务中的典型问题:策略在环境中执行(rollout)时,每一步的预测或动作偏差会改变后续状态分布,使智能体逐渐偏离训练时见过的状态,误差随回合长度非线性放大,最终导致行为漂移甚至崩溃。缓解手段通常包括缩短有效信用分配跨度、对状态分布做校正、或在训练中引入多轮重置与稳定化约束。Gamer 针对该问题做了专门设计,目标是在数十步乃至更长回合中维持策略一致性,这正是长时任务智能体与短程任务智能体在工程上的核心差异之一。
云边推理引擎支撑实时并发
为满足实时交互需求,Gamer配套了云边协同的推理引擎。该引擎可同时服务大量模拟游戏环境,支持无界上下文执行,并将在线推理延迟维持在较低水平。
无界上下文执行是这里的要点:长时任务天然要求模型记住很久之前发生的事件,而传统上下文窗口无法无限扩展。云边架构通过将部分状态管理下沉到边缘侧,为长回合交互提供了工程层面的解法。
无界上下文执行(unbounded context execution) 指智能体在执行长时任务时,不受固定上下文窗口长度限制,能够持续访问和利用远早于当前时刻的历史信息。常见做法是将历史状态压缩后存入外部记忆,或把部分状态管理下沉到边缘侧,由检索或摘要机制按需召回,而非把所有历史 token 都塞进模型上下文。对游戏智能体而言,这意味着它能记住数百步之前的地图信息或任务进度,同时不牺牲在线推理延迟,是长回合交互在工程上可行的关键支撑。
3D开放世界与2D基准的双重验证
在多个具有挑战性的3D开放世界游戏中,Gamer展现出与熟练玩家相当的泛化能力与运行效率;在一系列传统2D游戏基准上,它也取得了有竞争力的结果。
需要说明的是,原文仅以定性方式描述性能表现,未公布具体胜率、分数或对比基线数值。因此对这些结论应理解为方向性验证,而非精确的性能排名。不过,跨2D与3D双域取得可比较的表现,本身已说明统一架构的迁移潜力。
对通用智能体的启示
Gamer的价值不只在游戏本身。它验证了一条路径:以设备级交互轨迹为燃料,配合稀疏推理与稳定多轮强化学习,可以训练出在数字与物理属性并存的环境中稳定习得复杂技能的智能体。
原文指出,这一方法“为能够在数字与物理世界之间交互的通用智能体提供了路径”。从游戏到具身环境,键鼠轨迹所承载的环境动态知识,或许正是通用智能体跨越虚拟与现实边界所需的那类底层信号。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。