告别tok/s内卷:社区私有质量基准测试倡议

社区应停止迷信tok/s,转向私有质量基准评估模型尤其是量化后的真实表现。
文章批评本地大模型社区过度关注每秒令牌数(tok/s),将其视为衡量模型的唯一标尺,导致模型质量评估被严重忽视。作者指出,HuggingFace生态中“Benchmaxxing”现象泛滥,公开榜单容易被针对性优化污染。为此,帖子倡议每位社区成员建立私有质量基准,重点测试不同量化等级下的模型表现,只分享结果图表而不公开测试集,既防止基准污染,又保留协作价值。文章认为,量化对质量的影响无法用速度衡量,私有基准能填补这一空白,尽管面临标准化和横向比较的挑战,但其代价远小于继续沉迷tok/s。
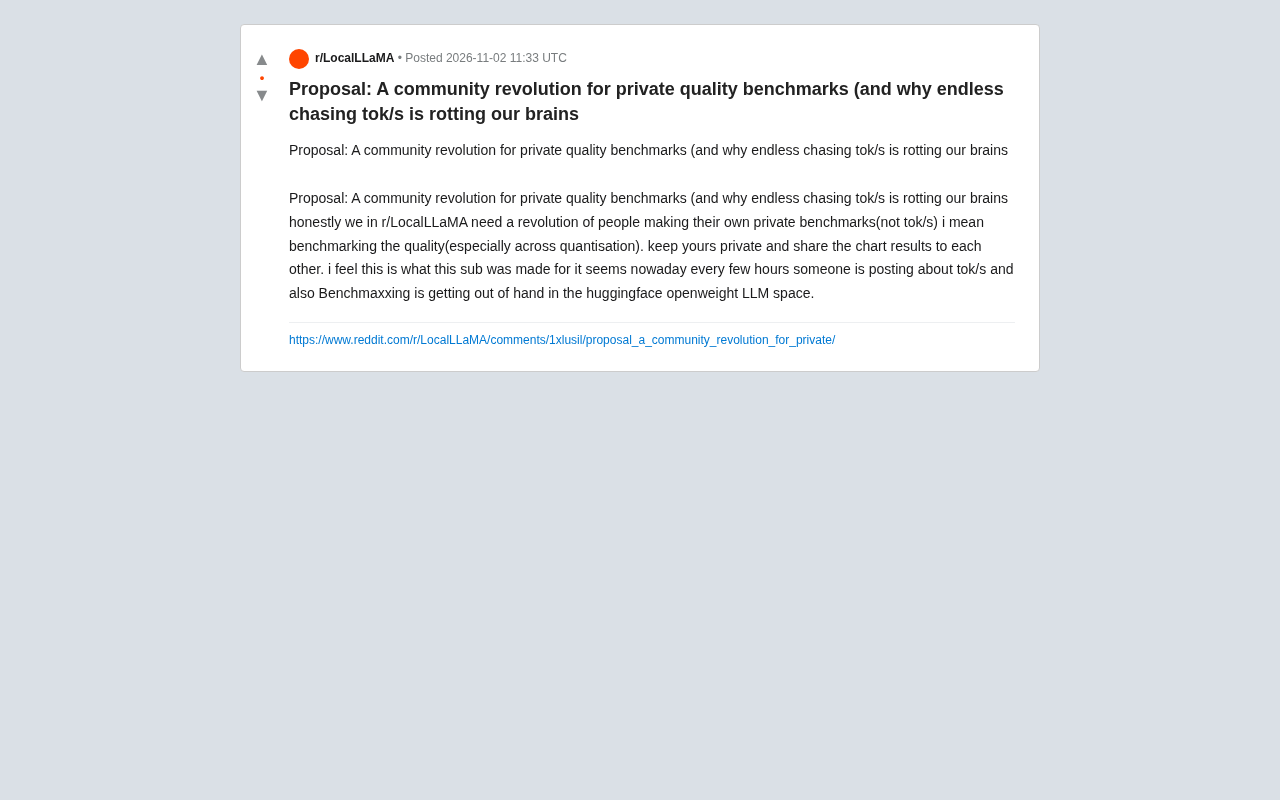
在本地大模型社区,每秒令牌数(tok/s)几乎成了衡量模型好坏的唯一标尺。但一位Reddit用户r/LocalLLaMA的帖子提出了一个尖锐的批评:无止境地追求tok/s正在“腐蚀我们的大脑”,而真正重要的模型质量——尤其是量化后的质量变化——却被严重忽视。这篇帖子呼吁一场社区革命:每个人建立自己的私有质量基准,只分享图表结果,不公开测试集。
tok/s崇拜与Benchmaxxing的泛滥
帖子指出,社区里每隔几小时就有人发布tok/s相关的帖子,仿佛推理速度就是模型能力的全部。同时,HuggingFace开放权重模型生态中“Benchmaxxing”(为刷榜而优化)的现象愈演愈烈。作者认为,这种风气偏离了本地LLM社区的初衷——探索模型在实际任务中的表现,而非在单一指标上内卷。
这一观察有现实基础。tok/s容易测量、便于比较,天然适合传播;但质量评估复杂、主观且耗时,导致讨论声量严重失衡。当速度成为唯一焦点,量化带来的质量损失、不同提示词下的稳定性、长上下文中的一致性等关键问题就被掩盖了。
Benchmaxxing 是近年模型社区衍生的俚语,由 benchmark(基准测试)与 -maxxing(极致追求)组合而成,指模型开发者或微调者为了让模型在公开排行榜(如 MMLU、HumanEval、GSM8K 等)上取得高分而进行针对性优化。常见手段包括在训练数据中混入与测试集高度相似的样本、针对特定题型做格式对齐、甚至直接数据污染。其结果是榜单分数与实际使用体验脱节:一个在排行榜上名列前茅的模型,可能在开放式对话、长文写作或真实代码库理解中表现平平。对本地部署用户而言,Benchmaxxing 的危害尤其隐蔽,因为用户往往依据公开分数选择模型,却难以察觉分数背后的过拟合。私有基准之所以被提出,正是为了绕开这一激励扭曲——当测试集不公开时,针对性优化就失去了靶子。
私有质量基准:一个可操作的替代方案
作者提出的方案并不复杂:社区成员各自设计私有基准测试,重点评估模型质量,特别是跨量化等级的表现。测试集保持私有,只将结果图表分享出来互相参考。
这个设计的巧妙之处在于防止基准污染。公开基准一旦流行,模型开发者可能针对性地优化,导致分数虚高。私有基准让每个用户根据自己的实际使用场景(代码生成、写作、翻译、推理等)设计测试,结果更贴近真实需求。分享图表而非测试集,则保留了社区协作的价值——你可以看到不同量化版本在同一测试下的相对表现,但无法直接刷分。
帖子强调,这正是r/LocalLLaMA“应该有的样子”。社区的核心价值在于集体智慧,而非追逐单一数字。
量化质量评估为何被低估
在本地部署场景中,量化是绕不开的话题。用户需要在显存限制和模型质量之间权衡,但量化对质量的影响很难用tok/s衡量。一个Q4量化模型可能速度更快,但在复杂推理任务上错误率显著上升——这种损失不会体现在速度指标里。
私有基准恰好能填补这个空白。用户可以设计一组覆盖自身任务的测试,对比不同量化等级的输出质量,形成自己的判断。这种评估方式虽然不如公开排行榜“权威”,但对个人决策更有价值。
量化(Quantization) 是将模型权重从高精度(如 FP16、BF16)压缩到低精度(如 8-bit、4-bit 甚至更低)的技术,目的是降低显存占用、提升推理速度,使大模型能在消费级硬件上运行。常见方案包括 GPTQ、AWQ、GGUF 系列(如 Q4_K_M)等。量化的核心代价是数值精度损失:权重被舍入到更粗的网格上,可能导致模型在细微语义区分、多步推理和长尾知识上出现退化。这种退化具有任务依赖性——有些模型在 Q4 下几乎无损,有些则在复杂推理上明显掉点。更麻烦的是,退化往往不表现为流畅度下降,而是表现为“看似合理但实际错误”的输出,用户若不做针对性测试很难发现。因此,量化质量评估需要覆盖自身任务分布的系统性对比,而非仅看 perplexity 或速度指标。
社区协作的新范式
这项倡议本质上是在重构社区协作方式:从“统一榜单”转向“分布式私有测试+结果共享”。它承认了模型评估的主观性和场景依赖性——没有放之四海皆准的基准,但可以有透明的结果对比。
挑战也很明显。私有基准缺乏标准化,结果难以横向比较;参与者需要投入时间设计测试;分享图表可能引发新的“图表攀比”。但帖子作者显然认为,这些代价远小于继续沉迷tok/s的代价。
对于本地LLM玩家来说,这个提议值得认真对待。下次看到tok/s帖子时,不妨问问自己:这个模型在我关心的任务上,质量到底如何?
相关推荐

AI编程工具成新攻击面:伪造Claude扩展窃取开发者信息
伪造Claude代码扩展现身Cursor市场,11小时内影响多达5000名开发者,窃取主机信息并植入SSH后门。了解攻击手法、自查步骤与AI编程工具的安全防御策略。
ChatGPT 12月起改算Token:聊天与Codex共用额度,谁最受影响?
ChatGPT 12月起改用Token计费,聊天与Codex共用额度。简单问题可用Instant免额度,重度Codex用户影响最大。本文解析新规则、额度查询与Credits购买方式。

ChatGPT与Codex合并额度:谁先用完?
OpenAI将于12月合并ChatGPT与Codex的付费额度,统一按token计量。本文解析合并细节、token计量的模糊性、OpenAI的财务动机,以及用户应对策略。