高含金量AI Agent项目的六大硬核标准
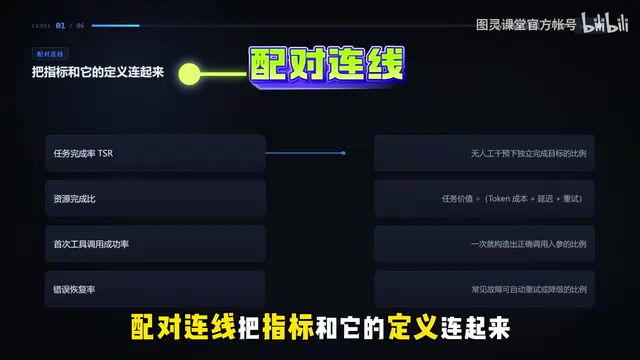
判断AI Agent项目含金量的六大硬核标准:从业务指标到评测护栏的系统工程框架。
这篇文章梳理了AI Agent项目从demo走向生产交付所需的六大硬核标准。核心论点是:Agent在演示时聪明、在生产中失灵,根源在于工程标准缺失而非模型能力不足。六大标准依次为:业务价值可量化(先定指标再写代码)、模型分层调度(按任务复杂度匹配成本)、上下文工程(以信息密度而非窗口大小为核心)、Skill工程(将能力固化为可复用操作手册)、RAG与工具接入(检索需经改写-过滤-重排-引用流水线)、评测与护栏(任务完成率90%+、闭环完成率85%+为可落地门槛)。贯穿全文的核心判断是:确定性胜过智能感,稳定的80分胜过偶尔的100分。
从demo到生产,AI Agent项目最大的落差往往不在模型能力,而在工程标准。很多智能体在演示时"很聪明",一到真实交付就"变蠢"——PR能跑却不能合,改了三轮最后发现漏传参数,读了20个文件却忘了前面的约束。这篇文章基于一份系统化的Agent开发教程,梳理出判断一个Agent项目是否"高含金量"的六大硬核标准。
标准一:业务价值必须可量化
评价一个Agent项目好不好,第一关不是技术炫技,而是能否让别人在30秒内听懂"这个项目值多少钱"。核心原则是:先定义指标,再写第一行代码。没有指标的项目,只能证明它"跑起来了",而不能证明它有价值。
真正的业务价值需要落到可换算的数字上:任务完成率从多少提升到88%、实验成本下降63%、单次处理成本仅0.21元。把这些收益换算成节省的时间成本和提升的准确率,才叫业务价值。
这里有一个关键辨析:用了最大的模型、接入了12个工具,这些都是"技术手段"而非"价值"。真正能证明业务价值的,是"完成率达到88%、成本下降40%"这类结果性指标。手段是过程,结果才是价值。
几个核心指标的定义值得记住:任务完成率指"无人工干预下独立完成目标的比例";资源完成比等于价值除以成本;首次调用成功率和错误恢复率反映的是系统稳定性。项目启动的正确顺序应当是:先定义可量化指标,再拆解子任务,设好验收基线,最后才动手写代码。
标准二:模型分层调度
第二个硬核标准是模型的分层调度。核心一句话:不要用旗舰模型去回答"今天星期几"。一个路由函数(root函数)就可能决定整个项目的成本量级。
合理的分层逻辑是:简单任务交给轻量小模型,不浪费预算;深度推理才升级到旗舰模型;图像语音类交给多模态模型;超长文档交给长上下文模型。比如用户问"今天北京天气怎么样",正确的做法不是丢给旗舰模型推理,而是用轻量小模型加上一个天气工具调用即可。
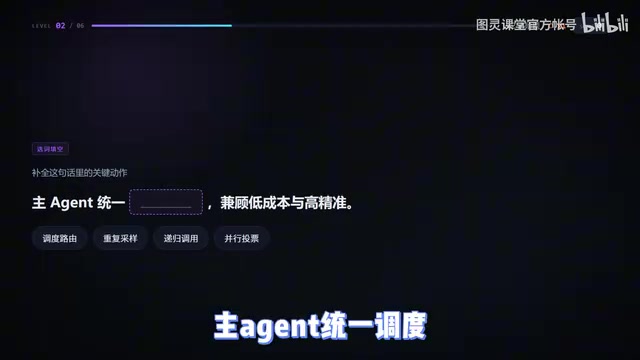
任务与模型层的匹配关系可以这样理解:闲聊和检索用轻量模型,复杂推理交给旗舰模型,图像语音用多模态模型,超长文档用长上下文模型。由一个主Agent统一调度路由,才能同时兼顾低成本与高精准。这是把Agent从"能用"推向"用得起"的关键一环。
标准三:上下文工程
Agent变"蠢"的根源,往往不是模型不够强,而是上下文管理失控。一个典型场景:读完20个文件之后,Agent开始忘记前面看过什么,约束被冲淡、被截断,挤出了"工作台"。
这里的核心认知是:上下文不是聊天记录,而是执行前组装好的工作台。问题不在窗口长度,而在信息密度。当Agent读完20个文件就忘记约束时,正确做法既不是换更大的模型,也不是把温度调到0,而是分层读摘要、把关键信息固化到文件。
上下文的分层结构可以这样组织:内层常驻层放身份定义与绝对禁止项;按需加载层放skills;运行时注入层放时间与用户偏好;记忆层保存跨会话经验。上下文压缩的正确策略包括滑动窗口、模型摘要、工具结果替换——而单纯调大参数、调高温度并不属于压缩手段。
上下文窗口(Context Window)是大语言模型一次能"看到"的最大token数量。早期模型的窗口只有4K tokens,现代旗舰模型已扩展到128K甚至百万token级别,但窗口变大并不意味着问题消失——模型对窗口中部信息的注意力会显著衰减,这被称为"中间迷失"(Lost in the Middle)现象。这也是为什么即便给Agent一个100万token的窗口,仍然需要精心设计上下文的分层结构:不是把所有内容堆进去,而是确保最关键的约束始终出现在模型最容易"看到"的位置(通常是开头和结尾),同时用摘要替代原始内容来提升信息密度。
标准四:Skill工程
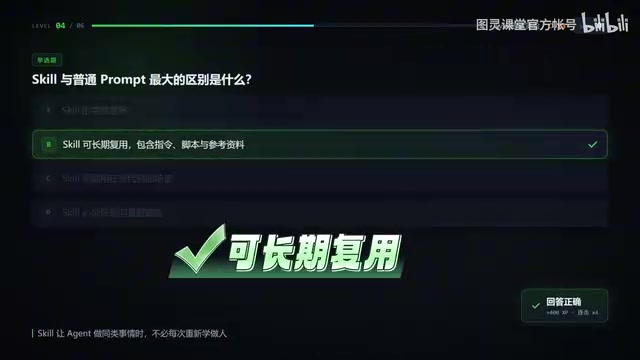
第四关是把"每次提醒变成默认动作"。skill.md写的不是鸡汤,而是执行纪律。Prompt与Skill有本质区别:Prompt是一次性的当前对话指令,Skill则是可以长期复用的能力包。
一个完整的Skill包含指令、脚本和参考资料,具备稳定可控、低token消耗、高确定性、安全可审计的特性。它让Agent不必每次都"重新学做人",而是直接调用固化好的操作手册。
几个概念的准确定位值得厘清:Prompt是一次性指令,Skill是可复用的操作手册,函数调用是原子单元,Agent是有状态的决策者。优质Skill的四条要求按重要性排列为:稳定可控、低token、高确定性、安全可审计。
标准五:RAG与工具接入
第五个标准聚焦检索与工具接入,目标是让每一个关键判断都能落回证据。检索的价值不在于"多读一点",而在于"读得准"。最怕的不是没检索到,而是检索到一堆看似相关的垃圾。
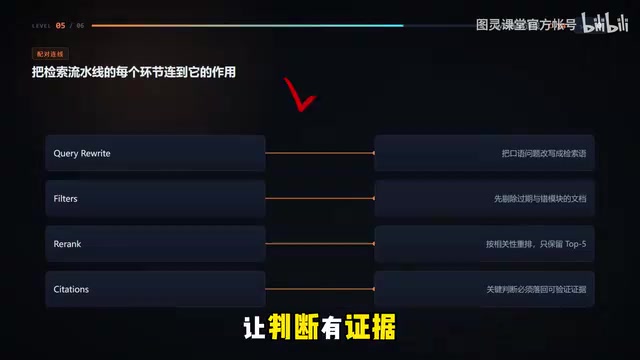
一条合理的检索流水线应当是:改写查询(把口语问题变成检索语)、重排、过滤、带引用作答。当同时检索到接口文档V1和V2时,正确做法不是都塞给模型自判,也不是只取排最前那份,而是先过滤版本、再重排、带上引用——版本混乱正是幻觉的来源。
流水线各环节的职责很清晰:查询改写把口语问题转成检索语;filters先剔除过期文档;re-rank只保留前五条;citations让判断有证据支撑。而MCP真正解决的问题是认证分散、错误格式不统一、工具描述漂移,而不是把模型变得更大更快。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与语言模型结合的架构:模型生成答案前,先从向量数据库或搜索引擎中检索相关文档片段,再将其作为上下文注入到Prompt中。这种方式的核心价值在于让模型的回答有据可查,而不是依赖训练时记住的静态知识。MCP(Model Context Protocol)是Anthropic提出的一套开放协议,旨在标准化Agent与外部工具之间的接入方式——统一认证机制、错误格式和工具描述规范,使不同厂商的工具能被Agent以一致的方式调用,解决的是工程集成层面的碎片化问题,而非模型能力本身。
标准六:评测与护栏
最后一关是评测与护栏,核心是"把有时候好变成稳定好"。没有护栏的Agent,本质上是在赌博。评测框架(harness)比换一个更大的模型更关键——因为模型决定上限,护栏决定稳定性,它决定了Agent能不能稳定跑成闭环。
可落地的评测门槛包括:任务拆解率和工具选择准确率都要达到90%以上,闭环完成率不低于85%,错误恢复率不低于80%。安全护栏的核心机制则包括权限最小化、输出过滤、人工兜底,而不是"全开工具、只管打日志"。
评测框架(Evaluation Harness)是一套自动化的测试基础设施,用于对Agent在标准化用例集上的表现进行持续度量。与单元测试不同,Agent评测需要应对非确定性输出:同一输入可能产生结构不同但语义等价的答案,因此评测通常结合规则匹配、LLM-as-Judge(用另一个模型打分)和人工标注多种方式。护栏(Guardrails)则是在模型输出之后、送达用户之前的拦截层,负责过滤有害内容、检测越权操作、触发人工审核等。两者合力构成Agent的"质量下限"——护栏保证不出大错,评测保证持续可见,这是"稳定80分"胜过"偶尔100分"的工程基础。
从demo到生产的一页总结
六大硬核标准可以一页带走:先定指标(业务价值可量化)、分层调度(模型按任务分级)、管好上下文(信息密度优先)、沉淀Skill(能力可复用)、让检索有证据(RAG带引用)、让交付有护栏(评测闭环)。
贯穿始终的一句话是:确定性胜过智能感,稳定的80分胜过偶尔的100分。这也是Agent项目从"demo很聪明"走向"生产可交付"的分水岭。
相关推荐
AI Agent实战指南:三层用法让效率翻倍
一篇系统梳理AI Agent用法的实战指南,从填表格、视频转录等基础杂事,到CLI、Skill、插件的能力叠加,再到行程规划、Final Cut Pro剪片等复杂目标的自主实现,三层递进讲透如何用Agent让工作效率翻倍。
从0到1搭建企业级AI Agent:三阶段学习路径全解析
一套从0到1搭建企业级AI Agent的748集教程解析,涵盖ReAct框架、LangChain与AutoGen实战、RAG混合架构及智能客服、数据分析、多Agent协作三大落地项目,附完整学习路径。
好莱坞对AI末日警告的态度:眼前的威胁比生存危机更紧迫
科技行业警告AI可能毁灭人类,好莱坞娱乐劳工组织却呼吁关注眼前现实:生成式AI对创意工作岗位、版权和演员形象的冲击。迪士尼、Netflix等制片厂已在使用AI,两种AI焦虑正在碰撞。