高通CEO放话:2028年手机或将常驻千亿参数AI大模型

高通描绘2028年手机常驻千亿参数模型的愿景,但内存、散热与功耗构成真实落地的三重壁垒。
高通CEO近日提出,AI公司希望到2028年让手机持续运行100B参数大模型。技术社区对此进行了深入推演:4bit量化下100B模型权重约占50GB内存,看似可行,但真正的瓶颈在于上下文KV缓存——全注意力机制下长上下文会使内存需求急剧攀升,稀疏注意力是目前最现实的压缩方案。散热、低推理速度(约4 token/秒)和电池续航同样是不可回避的硬件约束。相比之下,Google更现实的路线是在32GB内存上运行Gemma 4 31B级别的中等模型。此外,将模型烧录进硅片虽可节省内存,但无法更新,引发"计划性淘汰"担忧。社区也对高通此番表态的商业属性保持警惕,认为其背后折射的是超大规模数据中心扩张难以持续的行业判断,而非单纯技术路线图。
高通抛出激进设想:手机常驻千亿参数模型
高通CEO近日透露,部分AI公司希望到2028年让手机能够持续运行千亿(100B)参数规模的大语言模型。这一表态在技术社区引发热议——它既代表了端侧AI的雄心,也暴露出当前移动硬件与大模型之间的巨大鸿沟。
这个设想的核心逻辑并不难理解:当数据中心的算力成本持续攀升,把推理任务下放到用户设备上,成为分摊成本、保护隐私、降低延迟的诱人路径。但从社区的激烈讨论来看,"手机跑百亿模型"距离现实落地,还有不少硬骨头要啃。
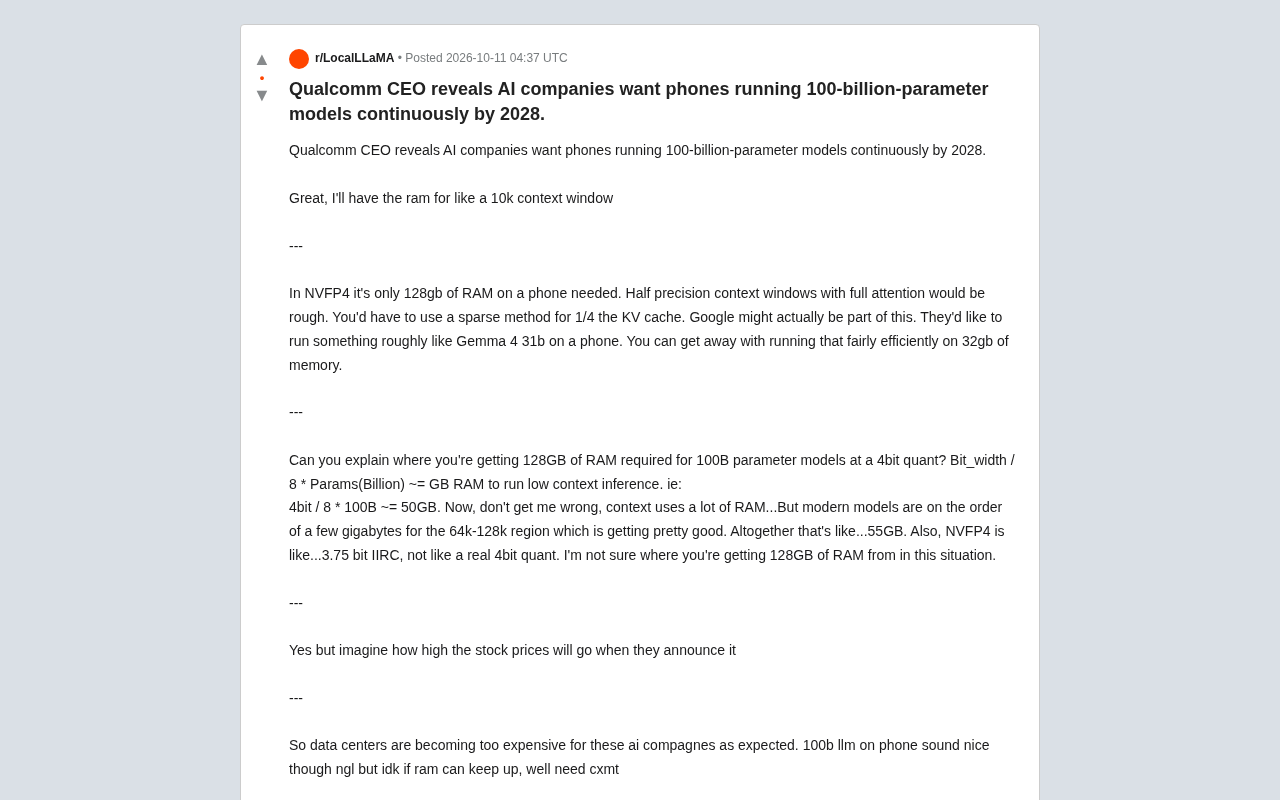
到底需要多少内存?一场精确的技术辩论
讨论中最有价值的部分,是围绕"100B模型究竟需要多少RAM"展开的拉锯。
有观点抛出"NVFP4量化下只需128GB手机内存"的说法,但很快被更严谨的计算推翻。按照业界通行的估算公式:
内存占用(GB) ≈ 位宽/8 × 参数量(十亿)
以4bit量化为例,100B参数模型的权重占用约为 4/8 × 100 = 50GB。再叠加上下文(context)所需的KV缓存,现代模型在64k–128k上下文窗口下大约需要额外几个GB,合计约55GB左右即可支撑低上下文推理。
讨论者还特别指出,NVFP4实际约为3.75bit,并非严格意义上的4bit量化,因此"128GB"这个数字缺乏依据。换句话说,纯权重并不是最大的拦路虎,真正吃内存的是上下文窗口与注意力机制。有人半开玩笑地吐槽:"好极了,我大概能有支撑一万token上下文的RAM了。"
上下文才是真正的内存杀手
若使用半精度上下文窗口配合完整注意力(full attention),内存压力会急剧上升。社区给出的务实方案是采用稀疏注意力(sparse attention),将KV缓存压缩到约1/4,从而让有限内存容纳更长的上下文。这也反映出一个趋势:端侧大模型的工程重点,正从单纯压缩权重转向优化推理时的动态内存开销。
稀疏注意力(sparse attention)是对标准Transformer中全注意力(full attention)机制的一种改进。标准注意力的计算复杂度与上下文长度的平方成正比(O(n²)),意味着上下文越长,KV缓存占用的内存和计算量会急剧膨胀。稀疏注意力通过只让每个token关注序列中的一个子集(例如局部窗口、固定步长的全局token,或通过学习选取的重要位置),将复杂度降至接近线性,同时大幅压缩需要常驻内存的KV缓存体积。在端侧推理场景下,这一压缩效果尤为关键:同等内存预算下,稀疏注意力可以支持约4倍于全注意力的上下文长度,或在相同上下文长度下将峰值内存降至约四分之一。代价是:对于需要跨越长距离依赖的任务(如超长文档问答),稀疏模式可能遗漏关键信息,因此实践中常与检索增强(RAG)结合使用,以弥补注意力覆盖范围不足的问题。
Google的现实路线:中等模型更靠谱
相比"百亿常驻"的激进目标,讨论中也出现了更接地气的参照。有人提到Google可能参与其中,而其真正想在手机上跑的,或许是类似Gemma 4 31B这种中等规模模型——在约32GB内存上就能较为高效地运行。
这个判断颇具代表性:对多数手机场景而言,一个能做好检索(search)与推理(reason)的模型可能已经足够,未必非要把千亿参数塞进口袋。正如一位用户所言:"我们真的需要一个超强模型吗?能搜索、能推理就够了吧?"端侧AI的价值,更多在于响应速度与隐私,而非盲目堆参数。
散热、功耗与硬件瓶颈的现实
抛开内存,散热和功耗是另一道无法回避的坎。有人用调侃的方式点破问题:"这主意不错,我可以一边用手机4 token/秒推理,一边用它发出的热量炖锅牛肉。"低速推理叠加持续高负载,对手机的热管理和电池续航都是严峻考验。
内存供应链同样被提及——有观点认为普通RAM难以跟上需求,可能需要像CXMT这类厂商提供更高密度、更低成本的存储方案。还有一个脑洞颇具启发性:将模型权重直接固化(烧录)进硅片,这样推理时就无需用RAM存储权重。代价则是模型一旦固化便无法更新,有人立刻警告这将成为"完美的计划性淘汰"——每次模型升级都意味着换新机。
商业动机:技术叙事还是股价叙事?
值得玩味的是,社区对高通这番表态的商业解读相当直白。有人一针见血:"想象一下他们宣布这个消息时股价能涨多高。"
这类前瞻性路线图,往往兼具技术愿景与资本叙事的双重属性。但其背后也折射出一个真实的行业判断:超大规模数据中心(hyperscaling)的无限扩张在长期难以持续。将算力向边缘设备分散,可能是行业应对成本压力的理性方向,而非单纯的营销噱头。
超大规模数据中心(hyperscaling)指科技巨头通过持续扩建GPU集群、增加服务器规模来线性提升AI推理与训练能力的路线。这一模式在过去几年驱动了ChatGPT等服务的快速扩张,但其边际成本正在成为行业隐忧——电力供应瓶颈、冷却基础设施投入、芯片供应链紧张,使得单纯靠堆算力的路线面临边际收益递减。"边缘计算"或"端侧推理"正是在这一背景下被重新重视:如果用户设备能承担相当比例的推理负载,云端集群的峰值压力将显著下降,同时还能规避数据出境的合规风险与网络往返延迟。因此,高通力推端侧大模型,既有真实的行业结构性需求支撑,也在资本市场叙事上占据有利位置——毕竟在AI算力需求爆炸式增长的时代,能让每一部手机都成为推理节点,是一个极具想象空间的商业故事。
结语:愿景很大,路还很长
从社区的技术推演来看,100B模型上手机并非天方夜谭——4bit量化下约50–55GB的权重内存需求,在未来几年的硬件演进中并非遥不可及。真正的挑战集中在上下文内存、散热功耗、供应链和模型更新机制上。
更现实的落地形态,很可能是32GB内存运行30B级别模型,配合稀疏注意力与检索增强,满足绝大多数日常AI需求。至于"千亿参数常驻手机",与其说是2028年的确定目标,不如说是一场关于端侧AI边界的集体想象。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。