GAP架构:注意力与MLP合二为一的门控Transformer块
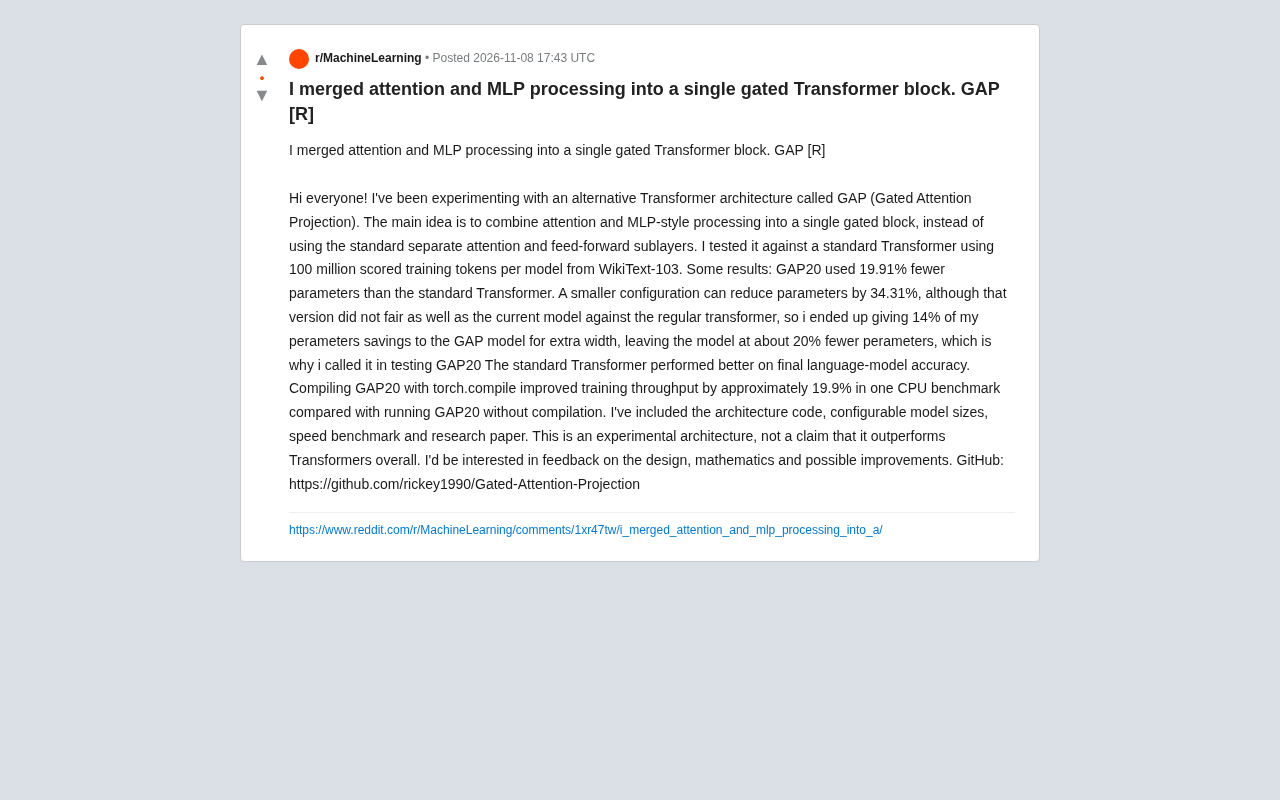
研究者提出GAP架构,将注意力与MLP合并为单个门控块,参数减少约20%但精度略逊。
Reddit 研究者 rickey1990 提出 GAP(Gated Attention Projection)架构,把标准 Transformer 中交替堆叠的注意力子层与 MLP 子层合并进单个门控块,目标是探索参数效率而非追求更高精度。作者在 WikiText-103 上以 1 亿计分 token 训练,对照标准 Transformer:GAP20 参数少 19.91%,但最终语言模型准确率更低;更激进的 34.31% 参数削减版本表现不佳,作者让渡 14% 的参数节省用于加宽,最终保留约 20% 参数优势。torch.compile 使 GAP20 在一个 CPU 基准中训练吞吐提升约 19.9%,这属于工程收益。作者明确其为实验性架构,并开源代码、论文与速度基准征求反馈。
Transformer 架构自提出以来,注意力子层与前馈网络(MLP)子层一直作为两个独立模块交替堆叠。Reddit 上一位研究者(rickey1990)提出了名为 GAP(Gated Attention Projection)的替代架构,尝试把这两步合并进单个门控块中。作者在 WikiText-103 上做了对照实验,并开源了代码、论文与速度基准。
设计动机:为什么要把注意力与MLP合并
标准 Transformer 的每个层由注意力子层和 MLP 子层串联组成,两者各有独立的参数与残差路径。GAP 的思路是用一个门控结构同时完成 token 间的注意力交互与逐 token 的特征变换,从而减少重复的投影矩阵和中间激活。
据作者描述,这一设计的目标并非追求更高的最终精度,而是探索参数效率:在相同训练 token 预算下,能否用更少的参数承载相近的语言建模能力。这种“结构合并”的思路与近年门控线性注意力、状态空间模型的方向有相似之处,但 GAP 保留了标准注意力的形式,改动集中在块内组织方式上。
门控线性注意力(Gated Linear Attention, GLA)是一类将门控机制引入线性注意力变体的模型。标准 Softmax 注意力需要计算所有 token 对之间的相似度,复杂度随序列长度呈二次增长;线性注意力则通过核函数近似或重写注意力计算,把复杂度降到线性。GLA 在此基础上为每个通道引入数据相关的门控向量,控制历史信息的保留与遗忘,形式类似 RNN 中的遗忘门。这类结构在长序列建模上比标准注意力更高效,但通常需要精心设计门控的初始化与归一化,否则训练容易不稳定。GAP 与 GLA 的区别在于,GAP 保留了标准注意力的形式,改动集中在把注意力与 MLP 两步合并进同一个块,而非替换注意力本身的计算方式。
状态空间模型(State Space Model, SSM)是一类用隐状态递推描述序列演化的模型,其连续时间形式可离散化为线性递推,从而以线性复杂度处理长序列。代表性工作如 Mamba 将输入相关的选择性机制引入 SSM,使其在语言建模上接近 Transformer 的表现。SSM 与门控线性注意力在数学结构上有相通之处:两者都用数据相关的门控控制隐状态的更新,都可以看作带门控的线性递推。GAP 被拿来与这些方向类比,是因为它们都试图用更紧凑的块内结构替代“注意力 + MLP”两段式堆叠,但 GAP 并未采用递推形式,它仍保持对 token 间做显式注意力交互。
实验设置与关键数据
作者使用 WikiText-103 数据集,每个模型训练 1 亿个计分 token(100 million scored training tokens),对照组为标准 Transformer。核心结果包括:
- GAP20 比标准 Transformer 少用 19.91% 的参数;
- 更小的配置可将参数减少 34.31%,但该版本相对标准 Transformer 的表现不如当前模型,因此作者将 14% 的参数节省让渡给 GAP 模型以增加宽度,最终参数仍少约 20%,测试中称为 GAP20;
- 在最终语言模型准确率上,标准 Transformer 表现更好;
- 在一个 CPU 基准测试中,使用 torch.compile 编译 GAP20 后,训练吞吐相比未编译版本提升约 19.9%。
这些数字说明 GAP 在参数效率上有一定空间,但精度上的让步是明确的。作者本人也强调,这是一个实验性架构,并不声称其整体优于 Transformer。
计分 token(scored training tokens)指参与损失计算的 token 数量,通常不包括填充、掩码位置或仅作为上下文而不预测的 token。在语言建模中,用计分 token 数而非原始 token 总数来衡量训练预算,可以更公平地比较不同上下文长度或不同掩码策略下的模型。100 million scored training tokens 意味着每个模型在训练中实际用于更新参数的预测目标约为一亿个,这一规模小于 WikiText-103 上常见的完整训练轮次,因此结果更适合作为架构可行性的初步对照,而非最终性能结论。
如何解读这一结果
参数减少约 20% 而精度略逊,意味着 GAP 在“每参数性能”上未必占优,但在显存或存储受限的场景下可能有参考价值。更值得关注的是 34.31% 参数削减版本表现不佳这一细节:它提示门控合并带来的容量损失并非线性可补偿,单纯加宽只能部分恢复性能。
torch.compile 带来的吞吐提升属于工程层面的收益,与架构本身的语言建模能力是两件事。作者将其单独列出,也说明当前阶段的重点是验证设计可行性,而非刷榜。
torch.compile 是 PyTorch 2.x 引入的编译前端,它通过 TorchDynamo 捕获 Python 层面的计算图,再交由后端(如 Inductor)生成优化后的内核代码,从而减少框架调度开销、融合逐元素运算并提升吞吐。它不改变模型数学定义,因此编译前后模型的精度应当一致,差异只体现在训练或推理速度上。这也解释了为什么 GAP20 的 19.9% 吞吐提升应被归为工程收益:它衡量的是同一架构在编译优化下的运行效率,与门控合并本身带来的参数效率是两个独立维度。
开放问题与可改进方向
作者在帖子中公开征求对设计、数学推导和改进方向的反馈,并提供了可配置模型大小的代码。对于关注高效 Transformer 结构的研究者,以下几个问题值得进一步验证:门控函数的初始化与归一化位置是否影响训练稳定性;在更大规模数据上参数优势是否保持;以及合并块与标准块混合堆叠能否兼顾精度与效率。
仓库地址为 github.com/rickey1990/Gated-Attention-Projection,包含架构代码、速度基准与研究论文。
相关推荐
全球电网神秘同步扰动,德国团队找到元凶
全球多国电网出现神秘的同步功率跌落,德国研究团队找到背后元凶。本文解读这一协调性扰动的现象特征、研究突破及其对电网监测与运维的启示。
英伟达董事会调查间谍案:CEO承认婚外情引发内部风波
英伟达董事会调查间谍案:CEO承认婚外情引发内部风波
英伟达董事会启动间谍案调查,起因是CEO承认婚外情。本文分析事件背景、公司治理逻辑及对英伟达的潜在影响,并指出当前信息有限,需理性看待。
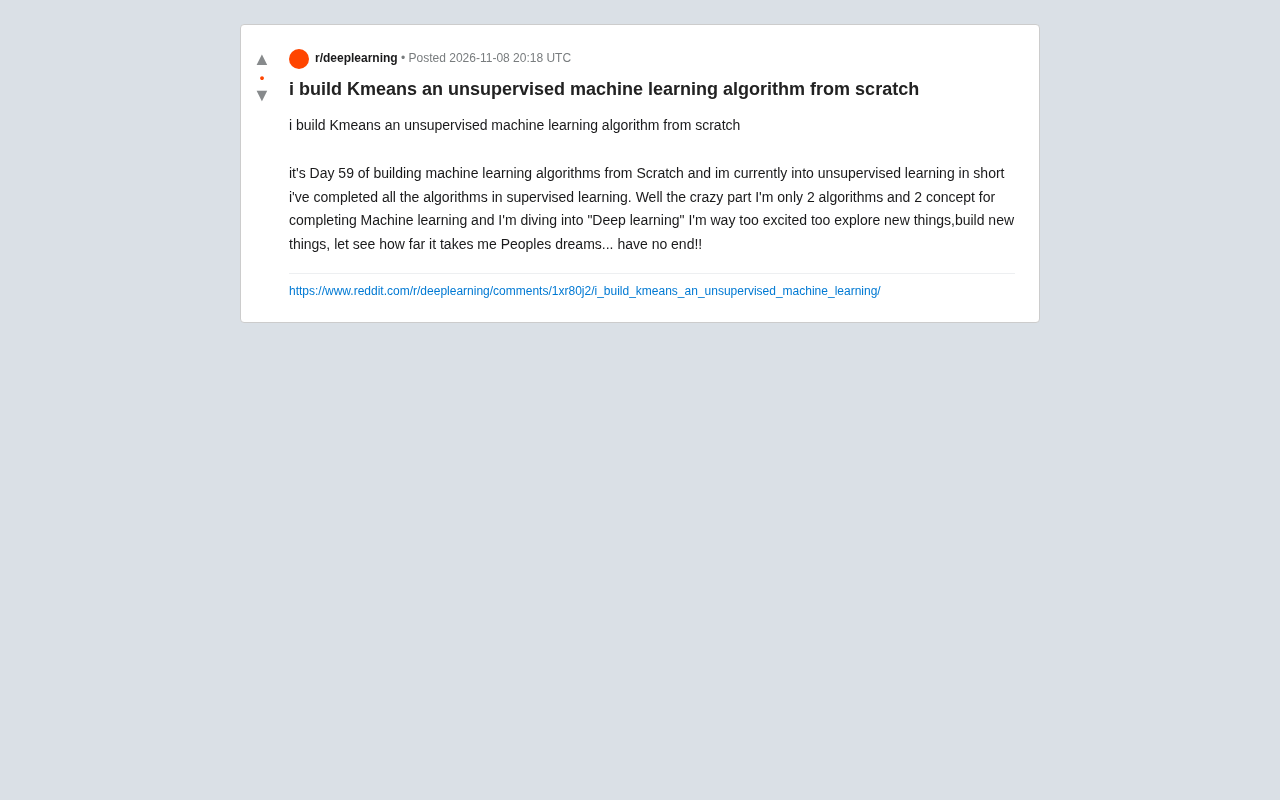
从零手写K-Means:一位开发者的机器学习进阶之路
一位开发者分享从零手写K-Means聚类算法的第59天进展:已完成监督学习全部算法,进入无监督学习阶段。本文解析手写K-Means的初始化策略、向量化距离计算、收敛判定与空簇处理等工程要点,并探讨从零实现算法对深入理解机器学习的价值。