GAUGE研究:何时不能信任LLM-as-a-Judge的智能体评测
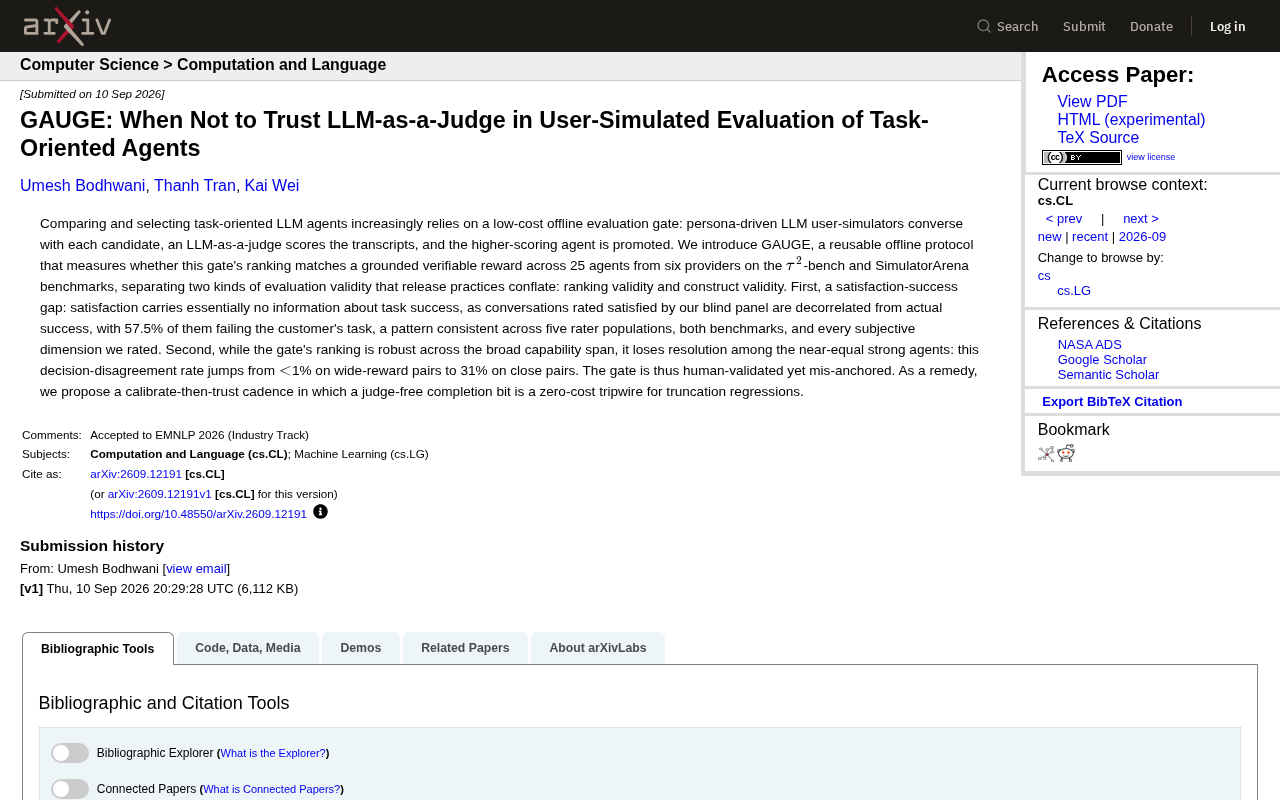
GAUGE研究揭示:LLM裁判打分与任务真实完成率严重脱节,57.5%满意对话实为失败。
GAUGE是一套覆盖25个智能体的可复用离线评测协议,专门检验当前流行的「LLM模拟用户对话+LLM裁判打分」评测门禁是否真正有效。研究发现两大核心问题:其一,用户满意度与任务成功几乎不相关,57.5%被评为满意的对话实际上未完成任务,且这一规律跨越五个评分群体和两个基准,具有系统性;其二,LLM裁判虽能在能力差距明显的智能体间给出可靠排序,但面对势均力敌的顶尖模型时决策分歧率从不足1%飙升至31%,恰恰在最需要精细区分的场景下失灵。研究提出「先校准再信任」方案,建议引入零成本的客观「完成位」信号来兜底,防止截断类性能回退被主观分数掩盖。
一个被广泛依赖却存在盲区的评测门槛
当下比较和挑选任务型 LLM 智能体(task-oriented agent),越来越依赖一种低成本的离线评测流程:先用带有人物设定(persona)的 LLM 用户模拟器与每个候选智能体对话,再由「LLM 充当裁判」(LLM-as-a-judge)为对话记录打分,分数更高的智能体便获得晋级。这套流程之所以流行,是因为它便宜、可复用、无需真人参与,几乎成了模型迭代发布前的默认「门禁」。
但这个门禁真的可靠吗?一篇名为 GAUGE 的最新 arXiv 研究给出了颇具警示意味的答案:它是「经过人工验证的,却又锚定错了目标」(human-validated yet mis-anchored)。
GAUGE 是什么:一个可复用的离线评测协议
GAUGE 是研究者提出的一套可复用离线评测协议,目的在于检验上述「模拟器对话 + LLM 裁判打分」的门禁,其排序结果是否真正匹配一个有据可查、可验证的奖励信号(grounded verifiable reward)。
研究覆盖了来自六家供应商的 25 个智能体,并在 τ²-bench 和 SimulatorArena 两个基准上进行测试。GAUGE 的关键贡献之一,是区分了业界在发布实践中经常混为一谈的两种评测有效性:
- 排序有效性(ranking validity):评测能否正确地把强者排在前面。
- 构念有效性(construct validity):评测所测量的指标,是否真的对应我们想要衡量的东西(即任务成功)。
把这两者拆开来看,才暴露出问题的本质。
τ²-bench 是一个专门用于评测任务型对话智能体的基准测试集,其设计核心是提供可验证的地面真值(ground truth)——即每条对话是否真正完成了用户任务,有客观标准可以核查,而非依赖主观感受。SimulatorArena 则是另一个基于 LLM 模拟用户的对话竞技场,侧重于让不同智能体在相同条件下与模拟用户交互并横向比较。两者结合,使 GAUGE 能够同时兼顾「有客观答案的任务」与「偏向自然对话质量」的评测场景,从而让发现的规律具备更强的跨场景泛化性。值得注意的是,τ²-bench 中的可验证奖励信号正是研究用来判断「门禁是否锚定正确目标」的核心参照——有了这把客观的尺子,才能量出满意度打分偏离了多远。
发现一:满意度与任务成功几乎不相关
GAUGE 最值得警惕的发现,是所谓的「满意度—成功鸿沟」(satisfaction-success gap)。
研究显示,用户满意度对于任务是否真正完成,几乎不携带任何信息。那些被盲评小组判定为「满意」的对话,与实际任务成功之间是去相关的——其中高达 57.5% 的对话,实际上并没有完成客户的任务。
换句话说,用户(或模拟用户)觉得聊得很愉快、体验不错,并不代表问题被解决了。这是一种典型的「感觉良好但没办成事」的错觉。更说个细节,这一规律在五个不同评分群体、两个基准、以及所有主观评价维度上都保持一致,说明它并非某个特定裁判或数据集的偶然偏差,而是一种系统性现象。
对于依赖满意度类主观打分来筛选智能体的团队,这意味着他们可能一直在用一个与真实目标脱节的指标做决策。
这一现象在心理学和用户体验研究中被称为**「体验—结果解耦」**,在人机对话领域有其特殊成因:LLM 驱动的智能体普遍具备流畅、礼貌、富有同理心的语言表达能力,即便任务实际上没有完成(比如工单未被正确提交、账户信息未被修改),也能让用户感觉「被倾听了」「态度很好」。这种语言流畅性本质上是一种表面满意度的「通货膨胀」,会系统性地拉高满意度分数,却与实际业务结果脱钩。对于客服、流程自动化等以「办成事」为核心 KPI 的场景,这一偏差尤为致命——评测分数高不代表用户问题被解决,甚至可能掩盖严重的功能性缺陷。
发现二:面对势均力敌的强模型,门禁「失焦」
第二个发现关乎排序的分辨率。好消息是,在能力差距较大的智能体之间,这套门禁的排序是稳健的——强弱分明时它判断得很准。
问题出在那些实力接近的顶尖智能体之间。研究用「决策分歧率」(decision-disagreement rate)来量化这一点:
- 在奖励差距较大的配对上,分歧率低于 1%;
- 但在实力接近的配对上,分歧率飙升至 31%。
这意味着,当你最需要评测帮忙区分两个都很强的候选模型、做出精细选择时,恰恰是这套门禁最不可靠的时候。它能分辨优等生和差生,却分不清两个尖子生谁更好。而在实际的模型迭代中,团队面对的往往正是这种「近似相等的强智能体」之间的抉择。
补救方案:校准后再信任
面对这些局限,GAUGE 并没有全盘否定 LLM-as-a-judge,而是提出了一种「先校准、再信任」(calibrate-then-trust)的节奏。
其中一个具体建议颇具工程价值:引入一个无需裁判的「完成位」(judge-free completion bit),作为零成本的「绊线」(tripwire),专门用来捕捉对话被截断(truncation)导致的性能回退。这类问题往往被主观打分掩盖,而一个客观的完成信号可以在几乎不增加成本的情况下发出预警。
这套思路的核心逻辑是:主观的满意度信号可以保留,但不能作为唯一或最终的锚点;必须辅以可验证的、客观的成功信号来校准,才能避免被「聊得开心却没办成事」误导。
「完成位」(completion bit)是一个二值信号(0/1),只记录对话是否在任务完成之前被截断或终止,不涉及任何主观质量判断。对话截断是任务型智能体中常见但隐蔽的失败模式:智能体可能因上下文长度限制、工具调用超时或流程逻辑错误而提前结束对话,而用户模拟器和 LLM 裁判往往将这类「有头无尾」的对话打出中等甚至偏高的分数,因为对话前半段的语言质量并无问题。引入完成位相当于在评测流水线中埋入一个纯客观的「熔断器」:一旦检测到截断率异常升高,立即触发告警,无需等待裁判打分结果,从而以极低成本防止系统性回退被主观分数掩盖。
对从业者的启示
对于正在搭建智能体评测流水线的团队,GAUGE 的结论提供了几点直接可用的参考:
- 不要把用户满意度等同于任务成功,二者可能高度脱节。
- LLM 裁判的排序在能力差距大时可信,但在筛选顶尖候选时需谨慎。
- 引入客观的、可验证的完成/成功信号作为兜底,成本极低却能防止严重回退。
随着任务型智能体在客服、自动化流程等场景中加速落地,评测方法的可靠性直接关系到上线质量。GAUGE 的价值不在于推翻现有做法,而在于清晰界定了它「什么时候能信、什么时候不能信」的边界。
相关推荐
MIT衍生公司将塑料废料变身高韧性建筑材料
MIT衍生初创公司Atlas Building Composites将塑料废料转化为高韧性建筑与基础设施部件,探索塑料回收的高价值产业化出路。本文解析其技术路径与产业意义。
CCPS采样法:保留推理多样性,无需微调提升LLM表现
arXiv新论文提出Chopthin-Consensus Power Sampling(CCPS),通过保留推理多样性的重采样与语义多数选择机制,在不进行任何训练的情况下提升大语言模型推理准确率,最高绝对增益达10.6个百分点。
HardFlow算法:让生成式AI满足安全关键场景的硬约束
HardFlow是一种新算法,旨在让生成式AI在安全关键场景中严格遵守硬约束条件,同时保持高质量输出。本文解析其核心思路、技术难点与在机器人、工程设计等领域的应用前景。