GeeksforGeeks 数据科学360课程解析:12个Sprint覆盖AI全栈技能
GFG推出Data Science 360课程,12个Sprint覆盖Python到Agentic AI,主打系统入门与项目背书。
GeeksforGeeks 推出的 Data Science 360 是一门面向零基础与转行学员的宽口径 AI/数据科学训练营,课程分为 12 个 Sprint,内容跨度从 Python 基础、SQL、BI 工具,一路延伸至机器学习、深度学习、RAG、LLM 微调与 Agentic AI 等前沿方向。技术栈覆盖 PyTorch、Scikit-learn、LangChain、CrewAI、Ollama 等工业界主流工具,并配套多个 Capstone 实战项目以打磨简历。完成后可获得 GFG 与 IBM 双证书。课程官方定位为"扎实基础"而非"一步到位",更适合作为进入 AI 领域的系统起点,而非职业终点。
GeeksforGeeks(GFG)推出了一门名为 Data Science 360 的课程,主打"360度全覆盖",试图在一门课里囊括从 Python 基础到 Agentic AI 的完整数据科学与 AI 技能链。对于想从其他领域转行进入 AI 的初学者,这类"一站式"课程颇具吸引力,但也值得冷静审视它究竟提供了什么、又适合谁。
课程覆盖了哪些内容
按照官方介绍,Data Science 360 的技能地图相当庞大:Python、SQL、Excel、Power BI、Tableau,再到机器学习、深度学习、生成式 AI(Gen AI)、RAG(检索增强生成)、Agentic AI、LLM 微调等前沿主题,全部拆分到 12 个 Sprint(学习阶段) 中逐步推进。
第一个 Sprint 从 Python 与文件管理入手,第二个 Sprint 转向统计、概率与基于 Python 的数据分析,后续再逐层推进到更高阶的建模与大模型内容。这种由浅入深的阶梯式设计,是面向零基础学员的典型做法。
从广度上看,课程几乎把当下数据科学岗位所需的能力都列了进去:数据分析、假设检验、数据库管理与 SQL 优化、数据可视化、预测建模、NLP、神经网络架构、提示工程(Prompt Engineering)、LLMOps、检索增强、模型微调、本地化 LLM 部署、多模态 Gen AI,以及多智能体编排(Multi-agent Orchestration)。
RAG(检索增强生成) 和 Agentic AI 是课程中两个较为前沿的主题,对初学者来说可能较为陌生。RAG 是一种将大语言模型与外部知识库结合的技术架构:用户提问时,系统先从向量数据库中检索相关文档片段,再将其作为上下文喂给 LLM 生成回答,从而弥补模型知识截止日期的局限,并减少"幻觉"现象。Agentic AI 则是指让 LLM 具备自主规划、调用工具、执行多步骤任务的能力——不再只是"问答",而是能够像代理人一样分解目标、调用搜索引擎或代码解释器、根据中间结果动态调整行动。这两项技术目前正从研究阶段快速走向产业落地,也是当前 AI 工程师岗位需求增长最快的方向之一。
技术栈与实战项目
课程宣称覆盖的工具链同样密集,基本对应了当前工业界主流:
- 数据处理与分析:NumPy、Pandas、SQL、MongoDB
- 机器学习与深度学习:Scikit-learn、PyTorch
- 可视化与 BI:Power BI、Tableau
- 大模型与 Agent 生态:Hugging Face、LangChain、Ollama、CrewAI、LangSmith、LangGraph、Chainlit
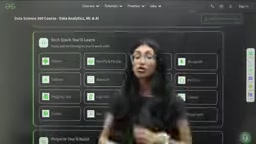
课程强调"边学边做",配套了多个 Capstone(毕业)项目,例如自动化数据管道(Automated Data Pipeline)、日志取证分析器(Forensic Log Analyzer)等,学员会用到 Selenium、Power BI 等工具把所学落地。官方页面对每个项目会用到哪些技术、能学到什么都做了说明。
这种设计的核心逻辑是:用可展示的项目为简历背书。正如课程中反复提到的,导师普遍认为在如今的求职环境里,仅有理论不够,必须证明自己"真的动手做过",项目经历正是credibility(可信度)的来源。
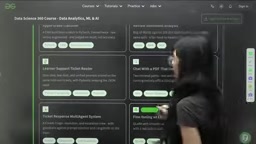
LangChain、LangGraph 与 CrewAI 是当前 Agentic AI 生态的核心框架,值得单独说明。LangChain 是一个用于构建 LLM 应用的编排框架,提供链式调用、记忆管理、工具集成等能力;LangGraph 是其扩展,专门用于构建有状态、可循环的多步骤 Agent 工作流,适合需要反复"思考-行动"的复杂任务。CrewAI 则是多智能体协作框架,允许开发者定义多个具备不同角色的 Agent,让它们分工协作完成目标。LangSmith 是配套的可观测性平台,用于调试和监控 LLM 应用的运行过程。Ollama 则让开发者能够在本地机器上运行开源 LLM(如 Llama、Mistral),无需依赖云端 API,对隐私敏感场景尤为实用。这些工具共同构成了从单一模型调用到复杂 Agent 编排的完整工程链路,也是当前 AI 工程师岗位中频繁出现的技能要求。
证书、导师与开课信息
完成课程后,学员可获得 GFG 与 IBM 双证书。其中 IBM 证书需通过对应的认证考试。对于希望在简历上增加权威背书的转行者来说,IBM 这类第三方认证具有一定的市场识别度。
课程还提供 24/7 的 AI 助手支持、现代 AI 工具包,以及贯穿全程的实战训练。导师阵容方面,介绍中提到了 GFG 学术高级总监 Sampoorn Rattan,以及在数据科学领域颇有声望的资深导师 Ashish。
新一期课程从 9 月 19 日开班,官方表示当前有限时折扣价格。完整的 12 个 Sprint 大纲、宣传册、报名入口以及咨询电话均可在课程页面查看。
客观看待"一站式"课程
课程 FAQ 中出现频率最高的疑问是:"仅靠这一门课能否成为数据科学家或 AI/ML 工程师?" 官方给出的回答是——课程提供了跨越数据科学、机器学习、深度学习、Gen AI、RAG、Agentic AI 与 LLM 微调的"扎实基础",并辅以实战项目支撑。
这个措辞值得注意:它承诺的是"strong foundation(扎实基础)",而非"一步到位成为工程师"。这也符合现实——大模型、Agent 编排等主题即便在专业岗位上也需要持续深耕,一门入门到进阶的课程更适合定位为"系统入门 + 建立技能框架"。
对于零基础学员或转行者,这类课程的真正价值在于:提供清晰的学习路径、降低选课与拼凑资料的成本、并用统一的项目体系产出可展示成果。而它的局限也同样明显——覆盖面越广,单个主题能深入的程度往往越有限。学员在报名前,建议结合自身目标岗位,判断课程深度是否匹配,并把"双证书"和"Capstone 项目"视为求职加分项而非充分条件。
小结
Data Science 360 是一门面向初学者的宽口径 AI/数据科学训练营,卖点集中在三处:12 Sprint 的系统化路径、覆盖主流工具链的实战项目,以及 GFG + IBM 双认证。它适合想要一次性建立完整技能框架、并借项目打磨简历的转行者。至于能否"仅凭一门课成为工程师",更务实的期待是把它当作进入 AI 领域的起点,而非终点。感兴趣的读者可通过课程页面查看完整大纲与开课信息。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。