给AI智能体装上「手」:用MCP安全控制Docker
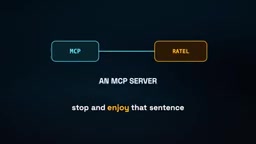
通过MCP服务器Ratel给AI装上Docker这双「手」,演示从诊断到动手的跨越,并以权限分层与范围控制为AI工具安全定下原则。
文章讲述AI智能体从「知道」走向「动手」的关键一步:选择Docker作为第一双「手」,因其控制面干净、动作可命名、爆炸半径可调。工具Ratel以MCP服务器形式接入,一次部署即让实验室所有AI客户端获得Docker能力,兑现N+M红利。作者重点警示Docker socket等于机器上的任意权限,read-only挂载标志对此无效,真正的安全来自把范围限制在一台可牺牲的主机上。演示中AI读取日志定位配置拼写错误并成功重启应用,既展示价值也提示风险。由此提炼出权限分层:读与安全写默认授予,破坏性操作必须显式同意,并为「善意的误解」而设计。
从「知道」到「动手」:AI智能体的下一步
在上一阶段,我们给AI装上了记忆和协议,让它能读取实验室的数据、了解基础设施的状态。但正如视频作者所说,这一切都停留在「知道」的层面——AI能像一位博学的朋友那样,坐在沙发上准确而毫无用处地告诉你系统的状况。
真正的转折点在于给它「手」。而第一双「手」的选择至关重要,因为它会设定习惯。作者选择了Docker,理由很清晰:容器已经是这个系列里我们熟悉的环境;Docker有干净、定义明确的控制面(list、inspect、logs、stats、start、stop、restart);每个动作都有名字,有名字就能被单独允许或拒绝;更重要的是,它有一个天然的「爆炸半径旋钮」——Docker控制工具只与指定的主机通信,可以把一台可牺牲的机器交给AI,而让真正重要的资产保持不可触及。
相比之下,直接给AI一个shell,攻击面几乎是无限的。作者的原则是:第一双手应当有能力、可读、可控制。
Ratel:一个MCP服务器带来的N+M红利
这个工具叫Ratel(蜜獾,小而无所畏惧,与实验室的「动物园」命名风格一致)。关键之处在于,Ratel是一个MCP服务器。这意味着不需要编写集成、不需要拼接API——客户端已经会说这个协议,部署、连接之后,实验室里每个AI大脑立刻就知道如何握住这个新工具。
这就是上一集埋下的N+M红利:一次接入,所有AI客户端自动获得新能力,而且会在后续每一个工具上持续兑现。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年底提出并开源的开放协议,目标是标准化「AI 应用如何连接外部工具与数据源」。它采用客户端-服务器架构:AI 客户端(如 Claude Desktop、各类 IDE 插件、自研 Agent 框架)作为 MCP Client,通过 JSON-RPC 与 MCP Server 通信;Server 则把一组工具(tools)、资源(resources)和提示模板(prompts)以统一模式暴露出来。对工具开发者而言,这意味着只需实现一次 Server,所有支持 MCP 的客户端即可即插即用,无需为每家 AI 平台分别编写集成代码。文中所谓的「N+M 红利」正源于此:N 个 AI 客户端与 M 个工具之间原本需要 N×M 次适配,经协议标准化后降为 N+M。
部署的核心风险:Docker socket意味着什么
Ratel由两部分组成:AI客户端连接的网关,以及部署在每台Docker主机上的小节点。要让节点控制Docker,就必须把Docker socket交给它。
作者在这里放慢了语速,因为几乎所有教程都会一笔带过这一点。用大白话说:任何能访问Docker socket的东西,都能在那台机器上做任何事——不只是管理容器。它可以启动一个挂载整个文件系统的容器,读取机器上的每一个文件。这不是Docker的缺陷,这正是socket的设计用途。
特别值得记住的是:网上很多人会给socket挂载加上只读(read-only)标志,以为这样就安全了。作者坦言自己也一度相信过。但这个标志只是让socket文件只读,对你通过它发送的命令毫无作用。稍后的演示中,工具会通过这种挂载重启容器——这是写操作。如果只读标志真的有效,演示根本无法运行。
真正让它安全的,是你把它指向哪里。Ratel今天不碰集群,也不碰关键层,只拿到一台放在工作台上的备用小机器,在集群之外,跑着几个故意不重要的演示应用。它的岗位描述就是「可牺牲」:不承载任何东西,也没有任何东西信任它。先划定范围,再建立信任,逐步扩展——这个反射动作适用于你部署的每一个有能力的工具。
Docker socket(/var/run/docker.sock) 是 Docker 守护进程(dockerd)暴露的 Unix 域套接字,Docker CLI 正是通过它与守护进程通信,下发创建、启动、停止、删除容器等指令。谁能读写这个 socket,谁就等价于拥有宿主机上的 root 权限:攻击者可以让守护进程启动一个把宿主机根目录挂载进容器的特权容器,从而读写任意文件、逃逸到宿主机。也正因如此,社区常说的「挂载 socket 等于把机器交出去」并非夸张。read-only 挂载标志只作用于 socket 这个文件本身是否可被写入,而通过已建立的连接发送的 API 请求不受该标志约束,因此它无法限制任何容器操作。
演示:从诊断到动手
沙箱主机上一个演示应用处于不健康状态,在不断崩溃重启。作者事先埋了一个配置文件里的拼写错误——就像现实中真正会发生的故障那样。AI对此一无所知。
用一句大白话提问:「沙箱主机上的Web应用挂了,能帮我查查为什么吗?」
接下来的工具调用是整集最精彩的部分:列出容器、看到重启次数、发现崩溃循环;拉取50行日志,然后真正去读它们;找到堆栈跟踪,回溯,用平实的语言回来汇报——应用启动失败是因为某个配置值格式错误,这是那一行,这是那个值,这大概应该是它该有的样子。
作者对这件事的评价很克制:模型没有施展魔法,它做的是分诊——和你自己会跑的那套循环一样:读日志、找错误、形成假设。但它在一瞬间完成,在凌晨一点不需要睡眠,并且用自然语言解释自己。光是诊断这一步就值回票价。
但到目前为止,一切都还只是「读」。接下来跨过那条线:作者修好配置,应用需要重启才能生效。他没有自己敲命令,而是说「直接重启吧」。然后,容器重启了——这个房间里一台真实机器的状态发生了改变,因为一个语言模型判断这个请求合理,并且它有一个能执行它的工具。应用恢复了,AI还检查了自己的工作:拉取新日志,确认干净启动,然后汇报。
作者提醒观众同时感受两件事:这确实有用,诊断加修复、免动手,正是整个系列一直在构建的梦想;但它也应该让你手臂上的汗毛竖起来。读不会破坏任何东西,做可以。后续几集的所有内容,都源于认真对待这第二种感觉。
权限分层:一句话概括AI工具安全
Ratel的权限按层级划分,这套设计哲学值得借鉴。
第一层:默认授予。 包括读操作(list、inspect、logs、stats),以及「安全写」——start、stop、restart、拉取镜像。为什么这些是默认?因为它们是日常主力操作,最坏情况有界且可恢复。一次错误的重启是道歉,不是事故。
第二层:每次都要显式选择加入。 这是破坏性操作:删除容器、在容器内执行任意命令、启动全新的容器。
新容器为什么危险?和socket危险是同一个原因:新容器可以被赋予整台机器。如果想给AI这些权力,你必须有意识地、有范围地、有理由地授予,而且工具会让你大声说出来。
默认读与安全写,破坏性操作必须刻意同意——这一句话,就是大部分实用的AI工具安全原则。用这条线去审视任何人给你的工具:找到那条线,看看越线之前需要谁签字。
最小权限原则(Principle of Least Privilege) 是信息安全中的基础准则:任何主体只应获得完成其任务所必需的最小权限,且仅在必要的时间内持有。文中的权限分层正是这一原则在 AI 工具场景下的落地——把工具能力按风险切分,读与安全写默认开放,破坏性操作则要求显式、逐次的授权。与之配套的常见机制还有「人在回路」(human-in-the-loop)审批闸门与「不信任执行者的检查」:前者在危险动作执行前强制暂停等待人类确认,后者在执行后由独立于模型的校验逻辑验证结果,二者共同降低模型误判带来的实际损害。
现实检验:为「善意的误解」而设计
作者给出了一个预测,认为这比回避更诚实:有手的智能体最终会做出你没打算让它做的事。不是因为它有恶意,而是因为你的指令不够精确。你说「清理旧容器」,心里想的是那两个;它把「旧」理解得很宽泛,而且在字面上完全正确。
失败不是模型不服从,而是模型服从了一句你并不真正想表达的句子。人类在给另一个人下指令时也会遇到这种情况。所以要为那一天做设计,而不是绕着它祈祷:保持范围小,一台主机,直到有真正的理由再加第二台;把破坏性权力放在显式同意之后;即将到来的还有不信任执行者的检查,以及危险操作必然停下来等待人类的闸门。
诚实的终局不是一个我完全信任的AI,而是一个信任不是承重结构的系统。
下一集:给AI装上「眼睛」
今天留下的缺口是:AI重启了应用,也读了日志确认它启动了。但「进程起来了」和「网站真的能用」是两个不同的断言,而现在AI只能验证前者。下一集将给它一个真实的浏览器——沙箱化、受控、指向实验室——让它真正去看自己做了什么。闭环开始合拢。
本文基于Smart Workshop频道关于MCP与Docker控制的视频内容整理。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。