Gemini 3.1 Pro vs Opus 4.6 vs GPT-5.3 Codex:三大AI编程模型终极对决

2026年2月三款AI编程模型密集发布,各据推理、工程与终端场景,选型应基于实测而非基准分数。
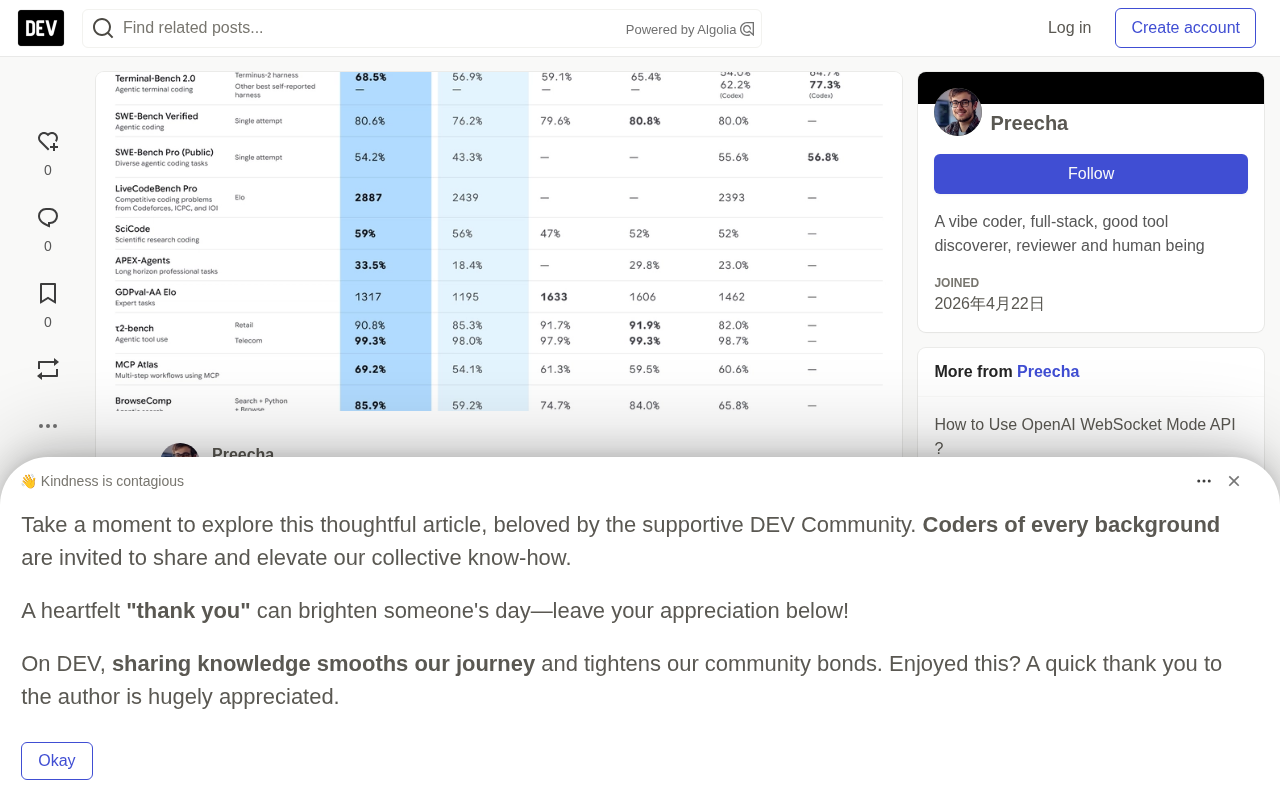
2026年2月,Anthropic、OpenAI与Google在15天内相继发布Claude Opus 4.6、GPT-5.3 Codex和Gemini 3.1 Pro,均自称"最强编程模型"。本文从基准测试、定价、差异化功能与实际场景四维度拆解:Gemini 3.1 Pro在ARC-AGI-2(77.1%)和LiveCodeBench上领先,定价$2/$12,约为Claude的七分之一;Claude Opus 4.6在SWE-Bench Verified达80.8%,并以Agent Teams多代理协作改变工作流;GPT-5.3 Codex在Terminal-Bench 2.0以77.3%占优,凭交互式引导与自举沙箱将反馈循环压缩至秒级。文章指出三者并非同赛道竞争,专业开发者正转向按任务路由的多模型策略,真实选型应依据自身负载的实测数据。
2026年2月,AI编程模型赛道迎来了一场罕见的密集发布潮。短短15天内,Anthropic、OpenAI和Google相继推出Claude Opus 4.6、GPT-5.3 Codex和Gemini 3.1 Pro,每款都宣称自己是"最强编程模型"。但对于开发者而言,真正的问题不是谁最强,而是在什么场景下该用哪一个。
本文将从基准测试、定价策略、核心功能和实际使用场景四个维度,对这三款模型进行深度拆解。
一、三款模型的核心定位差异
这三款模型并非在同一条赛道上竞争,而是各自占据了开发工作流的不同环节:
- Gemini 3.1 Pro:推理与算法任务的价格性能之王,ARC-AGI-2得分77.1%,定价仅为每百万token $2/$12,成本是Claude的七分之一
- Claude Opus 4.6:真实软件工程的质量标杆,SWE-Bench Verified达到80.8%,独有的Agent Teams功能支持多代理协作
- GPT-5.3 Codex:终端工作流的专业选手,Terminal-Bench 2.0得分77.3%,支持交互式引导和25%更快的推理速度
Anthropic在2月5日率先发布Opus 4.6,OpenAI几小时后跟进GPT-5.3 Codex,Google则在2月19日以"16项基准中赢下13项"的姿态入局。这种紧咬不放的发布节奏说明,三家实验室都在争抢同一个高价值群体——需要AI辅助编程的专业开发者。
二、基准测试:没有全能冠军
推理能力:Gemini 3.1 Pro大幅领先
ARC-AGI-2测试的是模型的抽象推理能力,即解决未见过的逻辑模式。Gemini 3.1 Pro的77.1%相比Gemini 3 Pro的31.1%是一次巨大飞跃,Claude Opus 4.6以68.8%紧随其后,GPT-5.2为52.9%(GPT-5.3 Codex数据尚未公布)。
在LiveCodeBench竞技编程评测中,Gemini 3.1 Pro以2887 Elo同样占据榜首。对于算法竞赛和需要使用不熟悉方法解决问题的场景,Gemini优势明显。
ARC-AGI-2 全称 Abstraction and Reasoning Corpus for Artificial General Intelligence,由前 Google 研究员 François Chollet 提出,是一套专门用来衡量模型"流体智能"的评测集。它的题目通常是彩色网格的变换谜题,每道题只给少量示例,模型必须自行推断规则并应用到新输入。与依赖海量文本记忆的考试型基准不同,ARC-AGI 的题目在训练语料中不存在,因此更接近人类面对全新问题时的推理过程。第一代 ARC-AGI 长期被视为大模型的"滑铁卢",人类平均得分约 85%,而 2024 年前的主流模型普遍低于 5%。ARC-AGI-2 于 2025 年发布,进一步提高了组合复杂度与抗记忆性,分数达到 70% 以上意味着模型已具备相当强的泛化推理能力,这也是 Gemini 3.1 Pro 的 77.1% 被反复引用的原因。
真实软件工程:Claude Opus 4.6独占鳌头
SWE-Bench测试模型能否解决GitHub上的真实Python仓库issue,是目前最接近实际工程任务的评测。Claude Opus 4.6在Verified子集上达到80.8%,而GPT-5.3 Codex和Gemini 3.1 Pro在Pro Public子集上分别为56.8%和54.2%。
需要注意,Verified和Pro Public是不同的评测子集,直接对比需要谨慎。但在人类偏好评估的GDPval-AA基准上,Claude Opus 4.6获得1606 Elo,远超Gemini 3.1 Pro的1317 Elo,说明Claude的输出在主观质量上更受认可。
SWE-Bench 由普林斯顿大学团队提出,任务来源是 GitHub 上真实的 Python 开源仓库 issue 与对应 pull request。评测时,模型需要在完整代码库中定位问题、修改多个文件,并让原本失败的测试全部通过,因此考察的是跨文件理解、长上下文定位与真实调试能力。它分为三个常用子集:Full 包含全部 2294 个任务但成本高;Verified 由人工筛选出描述清晰、答案唯一的 500 个任务,最常被引用;Pro Public 则强调任务难度与贴近真实工程分布。正因为三者筛选标准不同,跨子集直接比较分数往往会失真,这也是文中强调"直接对比需要谨慎"的技术原因。GDPval-AA 则是衡量人类专家对模型输出偏好度的对照榜单。
终端工作流:GPT-5.3 Codex的专属舞台
Terminal-Bench 2.0评估模型在终端环境下的表现,涵盖调试、系统管理、git操作和构建系统。GPT-5.3 Codex以77.3%领先,Gemini 3.1 Pro为68.5%,Claude的数据未见广泛公布。这反映了OpenAI对交互式终端工作流的专项优化。
学术知识:Gemini再次领先
在GPQA Diamond研究生级别科学问答中,Gemini 3.1 Pro以94.3%略胜GPT-5.2的92.4%和Claude Opus 4.6的91.3%。虽然这不是编程专属评测,但对科学计算类应用有参考价值。
三、定价对比:成本差距不容忽视
定价是规模化使用AI模型时不可回避的因素。Gemini 3.1 Pro在标准上下文(200K token以下)的定价为输入$2/百万token、输出$12/百万token,Claude Opus 4.6为$5/$25,GPT-5.3 Codex尚未公布定价。
以一个代码审查任务为例(3000输入token、800输出token):Gemini成本约$0.016,Claude约$0.035。对于大型文件重构(15000输入、12000输出),Gemini约$0.174,Claude约$0.375。在处理超大仓库分析时差距更明显——50万输入token的场景下,Gemini花费约$2.05,Claude约$5.11。
但聪明的团队会关注真正的指标:每次成功任务的成本。如果Claude一次就能正确完成任务,而Gemini需要三次迭代,后者的成本优势就消失了。建议以Gemini作为成本敏感场景的起点,同时追踪任务完成率来计算真实的性价比。
四、差异化功能:谁改变了你的工作方式
Claude Opus 4.6的Agent Teams
这是三款模型中最具范式变革意义的功能。Agent Teams允许多个Claude实例以不同角色(规划者、执行者、审查者)协同工作——一个代理写代码,另一个写测试,第三个做安全审查。有一位开发者用这套机制在5天内交付了93000行代码,包含44个pull request。
此外,Claude Opus 4.6支持自适应思考模式,在处理复杂问题时动态分配思考时间,减少来回迭代次数。
GPT-5.3 Codex的交互式引导
Codex支持在模型执行过程中实时纠偏,不丢失上下文地提供反馈。其自举沙箱能自动创建隔离环境、测试自身代码并自主调试,将反馈循环从分钟级压缩到秒级。Deep Diffs功能不仅展示代码变更内容,还解释变更原因,对代码审查和Git工作流效率提升明显。
所谓"自举沙箱",指的是模型在受控的隔离环境中运行自己生成的代码,观察执行结果、读取报错栈,再据此修正下一轮输出,形成一个不依赖人类介入的闭环。传统模式下,模型写代码、人类运行、人类报错、模型再改,一个来回通常以分钟计;而沙箱把编译、测试、调试全部自动化后,反馈周期可以压缩到秒级,使模型能在一次会话内连续迭代数十次。这一机制对终端操作类任务尤为关键,因为 shell 命令、构建脚本和依赖安装的结果高度依赖运行环境,只有真正执行才能暴露问题。Deep Diffs 则是同一思路在代码审查环节的延伸:它不只给出 diff 文本,还生成结构化的变更说明,帮助评审者理解"为什么这样改"。
Gemini 3.1 Pro的多模态与生态
100万token的标准上下文窗口意味着可以一次性加载整个代码库。多模态能力覆盖900张图片、8.4小时音频或1小时视频的处理。与Google生态深度整合,可通过Vertex AI企业部署,并在2月19日起进入GitHub Copilot预览。
上下文窗口指的是模型在一次请求中能够同时处理的 token 总量(含输入与输出)。100 万 token 大致相当于 70 万至 80 万个英文单词,或约 3 万行中等密度的代码,这意味着可以把整个中型项目的源码一次性喂给模型,省去检索增强和分块拼接的工程成本。不过需要注意,超长上下文并不等于等价的注意力质量——业界普遍观察到"中间遗忘"现象,即位于上下文中段的信息更容易被忽略。此外,标准上下文与扩展上下文往往在定价和速率限制上分开计算,超过 200K token 的部分通常按更高单价计费,这也是文中反复强调"标准上下文定价"这一限定语的原因。
五、实际使用中的痛点与选择策略
开发者反馈揭示了每款模型的局限:Gemini偶尔在只需要代码时输出冗长解释,且主观任务上的输出不够精致;Claude的成本在高频使用时成为瓶颈,1M上下文仍处于beta阶段且响应速度较慢;Codex的API访问尚未全面开放,定价缺失也带来预算不确定性。
实践中,越来越多专业开发者采用多模型策略:按任务类型路由(算法用Gemini、工程用Claude、终端操作用Codex),在成本累积时降级切换,或对关键代码使用质量共识机制。
测试这三款模型的最佳方式是通过统一的API工作空间进行对比。例如用Apidog配置三组端点,通过环境变量管理API密钥,发送相同prompt后对比响应时间、token消耗和输出质量。加上后置脚本自动计算成本,就能获得基于实际数据的选型依据。
六、总结:从"谁最强"到"谁最适合"
2026年2月的这轮发布标志着一个转折点——AI编程模型已经从"哪个最好"的单一维度竞争,转向"哪个最适合这个具体任务"的精细化选择。Gemini 3.1 Pro是推理密集型任务的性价比冠军,Claude Opus 4.6是真实工程场景的质量标杆,GPT-5.3 Codex是终端工作流的专业利器。
与其执着于选出一个"最佳",务实的做法是组合使用,在各自擅长的环节发挥优势。最终的选择依据,应当来自你自己工作负载上的实测数据,而非营销话术或单一基准分数。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。