Gemini 3.8 Live发布,Google内部引入Claude编程模型
Gemini 3.8 Live低成本多模态、OpenAI真人审核争议、Google内部用Claude,AI行业一日密集动态
本文汇总了AI领域多条值得关注的进展。Google推出Gemini 3.8 Live,以每小时0.84美元的低价音频输入成本和在Arkham Banking基准排名第一的成绩,主打实时多模态交互;其Extended Thinking模式可将Speech-to-Speech Index从76%提升至82.6%,为用户提供速度与精度间的灵活取舍。OpenAI的Project Lily曝光了数百名合同工阅读真实ChatGPT对话的内部做法,引发隐私与透明度争议,揭示了RLHF训练对人工标注的结构性依赖与用户隐私期望之间的张力。Google则将竞争对手Anthropic的Opus 5引入内部开发平台,体现了大厂在实际工程场景中"用最好的工具"的务实态度。国内方面,字节A-Drive、火山方舟、百度千帆等服务密集更新,联发科天玑9600 Pro推进端侧AI推理能力,"分档订阅+Token额度"成为主流定价模式。
Gemini 3.8 Live:实时对话与视觉呈现的融合
Google推出的Gemini 3.8 Live把实时对话智能、流畅交互和视觉呈现整合进同一套Live体验,试图在多模态实时交互这个赛道上抢占先机。从公开的评测数据看,这套系统的竞争力主要体现在成本和推理能力两端。
评测图显示,Gemini 3.8 Live的输入音频每小时成本为0.84美元,在同类Live对比项中处于较低水平。对于需要长时间语音交互的应用场景来说,这个成本优势会随使用规模被放大,直接影响商业化落地的可行性。
在Arkham Banking基准测试中,开启Extended Thinking模式的Gemini 3.8 Live得分35.1%,在参与对比的模型中排名第一。Speech-to-Speech Index方面,标准版本为76%,Extended Thinking高档进一步提升到82.6%。这些数据勾勒出一个思路:在保持低成本的同时,通过"扩展思考"模式换取更高的任务准确率,让用户按需在响应速度与推理深度之间做取舍。
Extended Thinking(扩展思考)模式是近期多模态大模型中出现的一种推理机制。与标准推理不同,该模式允许模型在给出最终答案之前,先在内部执行更长链路的"思维链"步骤——类似于人类在回答复杂问题前先打草稿。其代价是响应延迟增加,优势则是在需要多步逻辑推导、数学运算或复杂指令遵循的场景下准确率更高。Arkham Banking基准是专门针对金融领域对话任务设计的评测集,考察模型在银行、贷款、合规等场景下的问答准确性,被视为衡量实时语音模型在垂直行业可用性的重要参考。Speech-to-Speech Index则综合评估语音输入到语音输出全链路的理解与生成质量,包括语义准确率、对话连贯性等维度。
OpenAI真人审核:改进模型背后的隐私争议
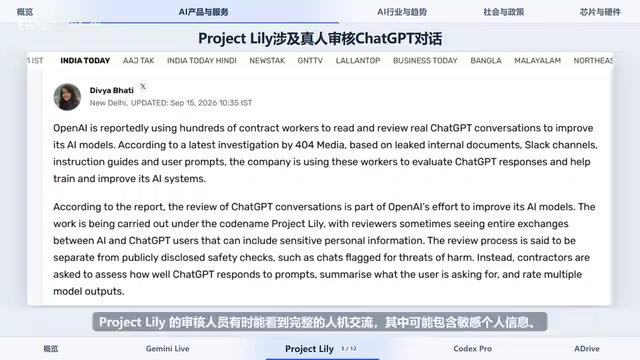
据404 Media调查、India Today转述,OpenAI雇佣了数百名合同工阅读并评估真实的ChatGPT对话,以此改进模型。这个名为Project Lily的项目,审核人员有时能看到完整的人机交流内容,其中可能包含用户的敏感个人信息。
审核人员的工作不止于阅读,他们还会概括用户意图、检查模型回答是否符合训练指令,并对多份模型输出进行评分。这种"人在回路"的方式对提升模型对齐质量确有帮助,但也把一个老问题重新摆上台面——用户在与AI对话时投入的私密信息,最终可能被真人逐字阅读。透明度和数据边界的问题,会持续成为大模型厂商需要回应的焦点。
与审核话题形成对照的是OpenAI在开源生态上的动作。其Codex for Open Source计划推出100美元的Pro方案,并将资助名额翻倍。该计划面向开源软件维护者,已获得资助的维护者也被鼓励重新申请,意在把AI编程工具的能力回馈给开源社区的长期贡献者。
**RLHF(基于人类反馈的强化学习)**是当前主流大语言模型训练的核心环节之一,而"人在回路"(Human-in-the-Loop)的数据标注正是其中不可缺少的一步。标注人员通过对模型多个输出版本进行对比评分,帮助训练奖励模型,进而引导语言模型向更符合人类偏好的方向优化。Project Lily所描述的工作流——概括用户意图、评估回答合规性、对多版本输出打分——与标准RLHF标注流程高度吻合。问题的核心在于:大模型的训练质量与数据标注规模正相关,而提升标注质量往往需要标注者接触真实用户对话,这与用户对数据隐私的合理期望之间存在结构性张力。目前各大厂商普遍在隐私政策中保留将对话用于模型改进的条款,但实际审核链路的透明度参差不齐。
Google内部引入Claude:巨头之间的微妙合作
Business Insider报道,Google已向全公司工程师开放Anthropic的编程模型,用于内部开发。具体使用的是Opus 5,入口被限制在Google的内部开发平台AntiGravity。
这是一个耐人寻味的信号。Google自身拥有Gemini系列模型,却在内部编程场景中引入竞争对手Anthropic的Opus 5,说明在具体的编程任务上,工程师群体倾向于选择当下体验最好的工具,而非固守自家产品。这种务实态度也反映出,模型能力的差异在实际开发工作流中会被直接感知,厂商很难仅凭"用自家的"来维系内部采用率。
国内AI服务与硬件的密集更新
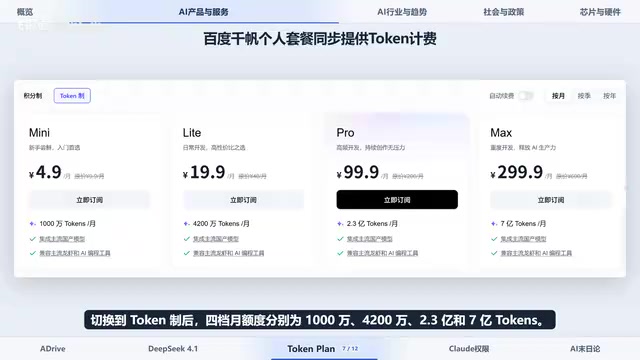
国内厂商在订阅计费和企业服务上继续加码。36氪报道,字节跳动将发布独立企业智能网盘A-Drive,目前已开启适用申请。A-Drive由火山引擎打造,主打连接AI应用,让文件与产物持续可用,并统一文件存储和团队协作。
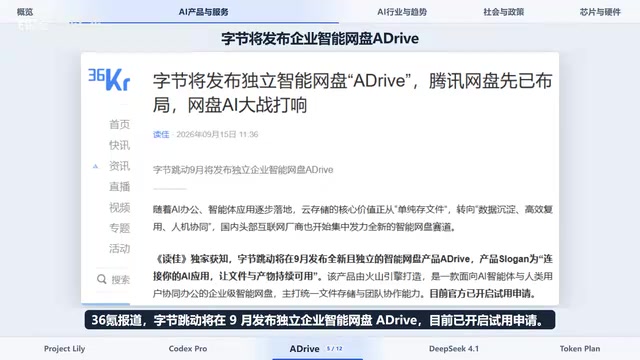
火山方舟的Agent Plan已列出DeepSeek 4.1 Flash,并在9月15日至28日的活动中按五折计算积分。这个个人订阅计划提供全模态模型、四档规模,以及Agent用量查看,还兼容多种编程Agent工具。百度千帆个人版则展示了Mini、Lite、Pro、Max四档积分套餐,月价从4.9元到299.9元;换算成Token后,四档月额度分别为1000万、4200万、2.3亿和7亿Tokens。这种"分档订阅+Token额度"的定价模式正在成为国内AI服务的标准打法。
硬件方面,联发科发布天玑9600M和9600Pro,其中Pro采用2纳米工艺与2+3+3全大核架构,集成双NPU,并强调支持在设备端运行AI模型。端侧AI推理能力的持续增强,意味着更多AI任务有望脱离云端、直接在手机上完成。
**端侧AI推理(On-device AI Inference)**指在终端设备(如手机、平板)的本地芯片上直接运行AI模型,而非将请求发送至云端服务器处理。其优势包括:降低网络延迟、保护用户数据隐私(数据不离开设备)、在弱网或无网环境下仍可运行,以及降低云端算力成本。制约端侧推理的主要因素是芯片算力与能效——NPU(神经网络处理单元)的集成规格直接决定可本地运行的模型参数量上限。联发科天玑9600 Pro采用2纳米工艺并集成双NPU,正是在这一方向的持续突破。随着量化压缩技术(将模型精度从FP16压缩至INT4等)的成熟,10亿至70亿参数规模的语言模型已逐步可在旗舰手机上流畅运行,这为离线场景下的AI助手、实时翻译、本地代码补全等应用打开了空间。
行业观察:叙事氛围与职场变化
据美金网援引报道,英伟达CEO黄仁勋在9月14日表示,国内关于AI的叙事方式更务实,讨论中没有人在谈"AI末日论"。他用这句话概括了两种截然不同的舆论氛围——一边聚焦落地应用,一边纠缠于风险恐慌。
LinkedIn的一项研究则揭示了AI时代职场关系的裂痕:72%的Z世代专业人士感到与能帮助自己职业发展的人疏离,职业影响力与社交信心出现错位。
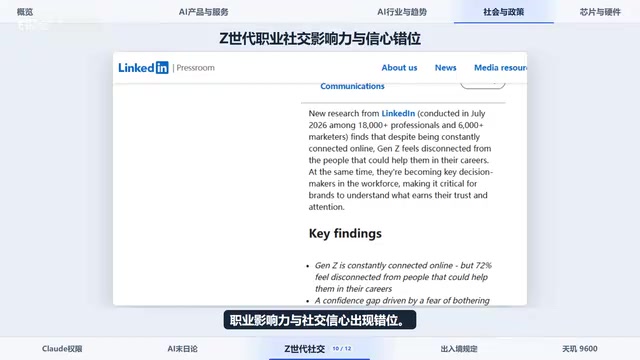
同一研究显示,27%的Z世代通过线上职业社群找到下一份机会,而有内部关系的求职者被录用的概率接近普通求职者的七倍。在AI改变工作方式的同时,人际网络在职业发展中的权重并未削弱,反而通过线上社群以新的形态延续。
相关推荐
抵制不支持Linux的软件:一位开发者的选择哲学
一位只用Linux的开发者分享他抵制不支持Linux软件的选择哲学:不牺牲生产力,用编程Agent扩展开源工具,并点评Valve、Proton、Omarchi等推动Linux主流化的力量。
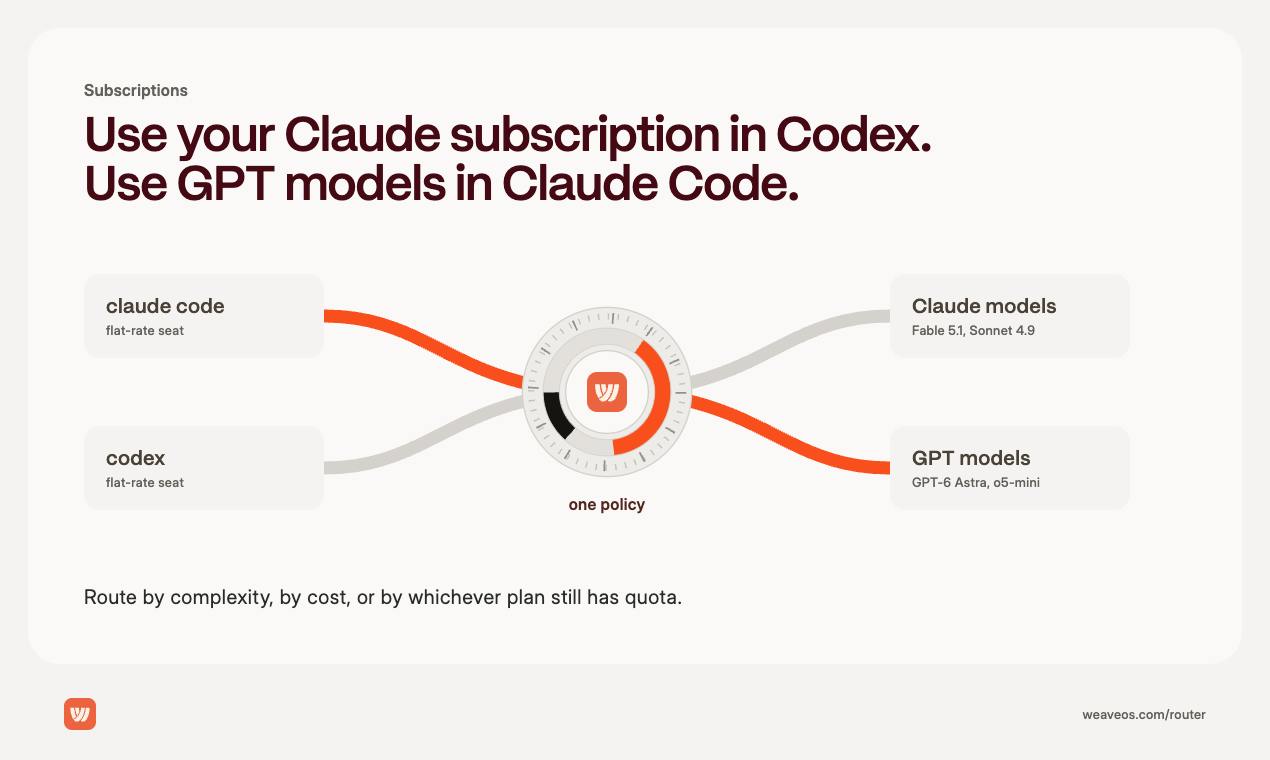
Weave Router 2.0:跨订阅智能路由的编程助手调度器
Weave Router 2.0 是一款订阅感知的 AI 编程助手路由器,可跨 Claude、Codex、GPT 订阅自动调度请求。官方称在 Terminal-Bench 4.0 与 SWE-Atlas 上对标 GPT-6 Astra,成本减半、速度翻倍。
Appwrite 2.0:面向AI智能体与开发者的开源云平台
Appwrite 2.0 发布:开源 BaaS 平台重构底层引擎,新增向量数据、原生 PostgreSQL/MySQL、S3 存储与 OAuth 2.1 身份能力,定位面向 AI 智能体与开发者的开源云。