Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5:实测谁更强

Gemini 4 Argon、GPT-6 Astra 与 Claude Opus 5.5 三强实测对比,编码与多模态各有胜负。
本文基于 YouTube 频道实测与官方数据,对比 Google Gemini 4 Argon、OpenAI GPT-6 Astra 和 Anthropic Claude Opus 5.5 的真实战力。Argon 在多模态、长文档和成本上优势明显,Google 自家 19 项基准中拿下 14 项第一,但在真实编码和 WebDev 榜上落后;Astra 强于真实仓库修复和快速智能体任务;Opus 5.5 则统治终端编码、综合智能指数和超长会话。文章深入分析 Argon 百万 token 为何救不了编码,指出共享配额、阅读为主、错误复利、闭环循环和工具链五大原因,最终给出场景化选型建议。
三强争霸:Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5 谁真正胜出?
Google 发布 Gemini 4 Argon 的架势,像极了压轴登场的终极 BOSS:铅笔草图实时变成物理模拟,一小时即可构建可玩游戏,百万 token 上下文更是引爆全网。但擂台上还站着两位老对手——OpenAI 的 GPT-6 Astra 与 Anthropic 的 Claude Opus 5.5。本文基于 YouTube 频道 Greed Hunter Academy 的实测与官方数据,逐一拆解三者的真实战力。
三大选手的定位差异
据该 UP 主总结,三者各有鲜明人设:GPT-6 Astra 是“现场工程师”,在 Codex 中负责构建候选方案、反复测试;Claude Opus 5.5 是“谨慎工匠”,擅长在不破坏既有功能的前提下迭代改进;Gemini 4 Argon 则是“视觉科学家”,能把代码、证据与视觉呈现连接起来。
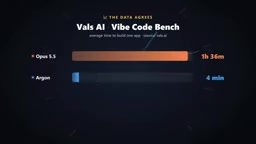
这种定位差异在实测中体现得淋漓尽致。Argon 拿到一个游戏或动画的提示词,往往在一两个小时内就能交付可玩的东西;而同样的提示词交给 Opus 或 Astra,可能需要五小时甚至一整天。原因并不神秘:后两者会像偏执的 QA 工程师一样反复测试、重跑、修正,最终交付的是“你真正需要的东西”。
多模态与成本:Argon 的绝对优势
Google 官方展示是 Argon 的超级能力秀:风筝草图变成实时气流模拟、手与花朵被逐部分标注、猫咪窗景与 3D 鱼骨图、彩色铅笔和矩形变成完整 3D 画廊,甚至秋千上的孩子被追踪速度、角度和受力。它能同时摄入文本、图像、音频、视频和 PDF,并在所有模态间推理。
价格上,Argon 是三家中最便宜的:输入每百万 token 2 美元、输出 10 美元(发布优惠价),12 月将涨至 4 和 20 美元。Opus 为 4 和 20,Astra 则高达 10 和 50。上下文窗口三者都在百万 token 级别,但 Argon 默认最大输出仅 65,000 token,百万输出仅在特殊长解码模式下可用,且与输入共享配额。
官方基准:Argon 霸榜,但编码项目失守
Google 自己的 19 项基准表中,Argon 拿下 14 项第一:知识工作 Wells 指数 68.9、百万 token 图数据推理 84.2、长视频理解 91.7。但在编码细分项上,局面反转:终端任务 Terminal Bench 4.0 中 Opus 以 66.4 胜出,Argon 仅 57.4;真实仓库修复 Frontier SWE 中 Astra 以 65.5 领先,Argon 为 55。
你可能没注意到长视频测试的“小字条款”——Google 给竞争对手的帧数更少,这一比较的公平性存疑。
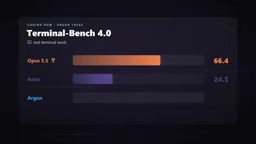
Terminal Bench 与 Frontier SWE 是评估编码智能体真实能力的两个关键基准。Terminal Bench 聚焦于命令行环境下的多步骤任务,要求模型能理解 shell 指令、操作文件系统并完成端到端流程,考验的是“用工具完成任务”的综合能力;而 Frontier SWE 则模拟真实开源仓库中的缺陷修复,模型需阅读代码、定位问题并提交补丁,更贴近软件工程实践。两者都强调交互式、迭代式的解决过程,而非单次生成代码片段。因此,在这类基准上领先,往往意味着模型在真实开发场景中更可靠,也解释了为何 Opus 5.5 和 Astra 能在编码细分项上反超 Argon。
第三方裁判:WebDev 才是试金石
抛开 Google 自家记分牌,Artificial Analysis 智能指数显示:Opus 5.5 以 58 分居首,Astra 与 Argon 同为 53 分。Arena 文本榜上 Argon 排名第一,但在真实网站投票的 WebDev 榜上,Argon 跌至第九,Opus 第一、Astra 第二。Arena 智能体模式下,Argon 的 shell 命令可靠性在 top 5 中垫底。
结论很清晰:Argon 强在视频、图像、长文档、知识工作与低成本;Astra 强在真实仓库修复、科学智能体、计算机使用和智能体任务的速度;Opus 5.5 则统治终端编码、综合智能指数、Web 开发和超长会话(其客户报告称 Opus 5.5 单任务可坚持 18 小时以上)。
Artificial Analysis 智能指数是一个综合性的第三方评测指标,它汇总了多个主流基准(如 MMLU、HumanEval、GSM8K 等)的得分,并对模型进行归一化排名,旨在提供一个跨模型、跨任务的统一智能水平参考。该指数不依赖厂商自报数据,而是通过独立运行标准化测试来减少偏差,因此常被用来交叉验证官方宣传。在本文中,Opus 5.5 以 58 分居首,而 Astra 与 Argon 同为 53 分,这一结果与 Google 自家基准中 Argon 的强势表现形成对比,提示厂商特定优化可能影响排名。
百万 token 为何救不了编码?五个原因
如果 Argon 能输出百万 token,为何编码仍落后?UP 主给出五点解释:
1. 共享油箱。 输入输出共用同一个百万配额。若 Argon 写满百万,就没空间读你的代码了——不会读代码的智能体,写出来的东西质量可想而知。
2. 编码智能体主要在“读”。 某基准中 Codex 内的 Astra 读了 2.64 亿 token,写出的不到 200 万,超过 99% 是阅读。读得越多,理解越深。
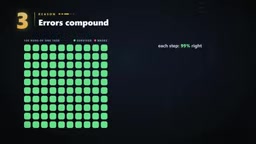
3. 错误会复利。 若每步正确率 99%,100 步后整条链存活率仅约 37%;500 步后不足 1%。研究还表明,模型一旦在上下文中看到自己早先的错误,表现会进一步恶化。
4. 循环胜过独白。 “计划—编写—跑测试—报错—修复—重复”的闭环,在 Alpha Codium 研究中把 GPT-4 的成绩从 19% 拉到 44%。同一个模型,套上不同的循环,分数可以天差地别。
5. 工具链。 真实编码离不开 shell、测试运行器和 git,而这恰是 Argon 在 Arena 智能体数据中的软肋。
Alpha Codium 是一项针对代码生成的研究,它提出了一种“计划—编写—测试—修复”的迭代流程:模型先生成测试用例,再基于测试结果反复修正代码。实验表明,这种闭环方法能将 GPT-4 在 CodeContests 基准上的通过率从 19% 提升至 44%,远超单次生成的效果。这印证了编码任务中“循环胜过独白”的论点——模型通过自我验证和错误反馈,能显著弥补单次输出中的不足,也解释了为何拥有超大上下文但缺乏高效工具链的模型在真实编码中仍可能落后。
最终裁决
窗口越大,摔得越重。编码不是比谁能写更多,而是比谁更快发现自己错了并修正。公平地说,Google 否认 Argon 在真实世界编码中较弱的报道,它在 DeepSWE 等基准上仍居前列——它是一台草稿机器,而非坏掉的机器。
选型建议:需要视觉模拟、长文档理解和低成本,选 Argon;需要真实仓库修复、科学智能体与快速智能体任务,选 Astra;需要终端编码、Web 开发和马拉松式长会话,选 Opus 5.5。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。