微软Project Gecko:用AI为非洲农民架起语言桥梁

微软Project Gecko用母语AI问答帮非洲农民从万条视频中精准获取农耕知识。
微软研究院非洲团队与Digital Green合作开展Project Gecko,开发了PharmaChat应用,让非洲农民用母语提问并获得视频片段答案。项目基于超过10,000个农业视频构建知识库,并通过微调小型语言模型保证答案准确且可落地。团队在肯尼亚实地测试,观察农民的真实使用方式和语言偏好。随后加入MMCT Agent实现多模态答案,可同时返回视频片段和农耕书籍章节。团队还在评估文本、图像、视频、语音各模态的表现,并开发基库尤语模型以覆盖不懂斯瓦希里语和英语的农民。最后,项目发布Paza、Vibhasha、Atlas三个交互式手册,将经验转化为可复用资源,降低他人构建包容性AI的门槛。
在非洲的田间地头,语言障碍常常成为农民获取农业知识的最大壁垒。微软研究院非洲团队与Digital Green合作开展的Project Gecko项目,正试图用AI打破这道屏障。他们开发的PharmaChat应用,让农民可以用母语提问,并获得基于视频片段的精准答案。
从10,000个视频到智能问答
Project Gecko的核心是一个简单却强大的想法:用农民熟悉的语言和文化方式,提供他们真正需要的农业信息。据项目团队介绍,多年来他们积累了超过10,000个农业视频。这些视频是宝贵的知识库,但传统上农民很难快速找到自己需要的片段。
PharmaChat的出现改变了这一切。这是一个AI驱动的应用,农民可以用母语(如斯瓦希里语)提问,系统会返回视频中真正回答该问题的片段。团队正在微调小型语言模型,以确保答案不仅准确,而且易于农民应用到实际耕作中。
小型语言模型(SLM) 是与GPT-4等大模型相对的概念,参数量通常在数十亿以下。它们经过特定领域数据的指令微调和蒸馏后,可以在边缘设备或低带宽环境下运行,推理成本远低于调用云端大模型。对于非洲农村场景,SLM的优势尤为明显:不依赖持续稳定的高速网络,且更容易用本地语言语料进行定制。PharmaChat正是通过微调SLM,将领域知识(农业问答)压缩进一个可在本地部署的模型中,从而在保证回答准确性的同时,降低对基础设施的要求。
检索增强生成(RAG) 是PharmaChat类应用背后的关键技术范式。它不要求模型记住所有知识,而是先从外部知识库(此处为10,000多个农业视频)中检索出与用户问题最相关的片段,再交给模型生成或直接返回该片段。这种做法能显著减少模型“胡编乱造”的风险,并让答案可溯源——农民看到的正是视频中真实讲解该问题的画面。
深入田间:真实场景的AI测试
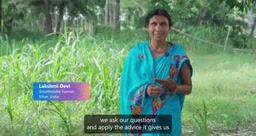
要构建真正为所有人服务的AI,必须走进田野。项目团队在肯尼亚进行了实地测试,观察农民如何接受这款应用、他们最初会问什么问题,以及在使用过程中遇到哪些挑战。他们还特别关注农民更偏好使用斯瓦希里语还是英语。
一位农民用户反馈说:“自从有了PharmaChat,我们一直在用它提问,情况比以前好多了。它帮我认识到自己在耕作中犯的错误。”这种来自一线的声音,验证了AI落地农业的价值。
MMCT Agent:多模态答案的进化
项目并未止步于视频检索。团队为PharmaChat加入了一个强大的新功能——基于智能视频理解系统的MMCT Agent。现在,PharmaChat能够提供多模态答案,这些答案在文化和语言上都与农民相关。
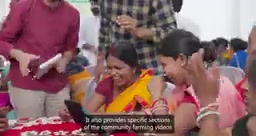
具体来说,系统不仅返回视频片段,还能提供社区农耕书籍的特定章节。这种文本与视频的结合,让答案更加完整。正如一位农民所说:“有些人在学习时看不懂文字,但看视频就能理解更多。”
多模态检索 指系统同时处理文本、图像、视频、语音等多种信息形态。MMCT Agent需要把农民的语音或文字提问转成统一的语义表示,再在视频帧、字幕文本和书籍章节等多个库中做跨模态匹配。例如,农民问“玉米叶子发黄怎么办”,系统既要找到视频中展示黄叶病状的片段,也要定位书中对应的病害防治章节。这比纯文本检索复杂得多,因为视频需要先做分段、语音转写和视觉特征抽取,才能被检索到。
性能评估与基库尤语模型
团队正在与机器学习工程师合作,评估这些模型在不同模态下的表现:文本、图像、视频、语音,哪种效果更好?模型的失败模式是什么?如何提高准确率?这些问题的答案将决定AI能否真正可靠地服务农民。
另一个重要方向是创建基库尤语模型。对于既不懂斯瓦希里语也不懂英语的农民,他们仍然可以用自己完全掌握的语言提问并获得答案。这体现了项目对语言多样性的承诺。
低资源语言(low-resource language) 指在互联网和公开语料中数据量极少的语言,基库尤语即属此类。主流大模型对这类语言的支持通常很差,因为训练数据中几乎不存在它们。为基库尤语构建模型面临双重困难:一是缺乏平行语料(基库尤语-英语对照数据),二是缺乏评测基准。常见做法包括利用斯瓦希里语等相近语言做跨语言迁移、借助社区众包收集语音和文本数据,以及采用参数高效微调(如LoRA)在有限数据上适配模型。这也是项目强调“语言多样性承诺”的技术含义。
三个交互式手册:赋能他人
Project Gecko团队并不满足于自己构建AI,他们希望帮助其他人也能做到。为此,他们发布了三个交互式手册:Paza、Vibhasha和Atlas。
Paza语音手册提供了稳健模型训练、部署和评估所需的最佳实践。Vibhasha则为构建跨语言和文化的大型语言模型应用提供实用指南。Atlas指导开发者构建基于真实生活经验的AI。这些资源将项目的经验转化为可复用的知识,降低了其他团队进入这一领域的门槛。
从田野测试到开源手册,Project Gecko展示了一条让AI真正包容所有人的路径——不是用技术取代当地知识,而是用技术让当地知识更易获取。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。