Gemini 4 Argon发布:100万Token输出与AI智能体的真实能力边界

谷歌Gemini 4 Argon以100万Token输出上限主打长任务持续执行,评测亮眼但分布不均,成本优势依赖首发折扣。
谷歌DeepMind发布Gemini 4 Argon,将单次输出上限扩展至100万Token,并率先向受信任的网络安全防御团队开放。模型的核心卖点不是单轮问答质量,而是在代码迁移、性能优化等需要连续推理与反复验证的长任务中的持续执行能力——内部案例包括将视频解码器速度提升2.7倍、在数据中心优化中释放超300TiB内存。但评测结果分布不均:文本榜排名第一,网页开发仅列第八;幻觉率为同级最低的15%,准确率却只有50%,显示模型更倾向于承认不知道而非给出错误猜测。谷歌内部员工对其真实编程与前端能力存在分歧。成本方面,当前优势与首发折扣高度绑定,更长的推理轨迹意味着更多Token消耗,低单价不必然等于低账单。
谷歌DeepMind终于带回了Gemini系列的新旗舰——Gemini 4 Argon。但与以往不同,这次大多数人暂时还用不上它。9月30日,谷歌宣布率先把模型交给一小批受信任的网络安全防御团队,面向开发者、企业和普通用户的开放则要等后续测试与安全措施完善。
从B站UP主娜娜的分析来看,这次发布的看点并不在于“回答一个问题有多好”,而在于模型能不能连续完成一项复杂工作。谷歌内部已经让它分析数据中心性能、迁移数十万行代码、优化视频解码器。但另一边,部分谷歌员工对它的实际编程表现提出质疑,第三方评测也呈现出耐人寻味的分裂结果。这篇文章就来梳理,Argon到底强在哪,又有哪些问题还没解决。
100万Token输出:为连续任务留出空间
Argon最显眼的变化,是单次输出上限从6.4万Token扩展到100万Token。这里需要区分两个概念:输出上限是模型在一次连续任务里能使用的生成空间,而上下文窗口是模型能读入多少材料,两者是不同指标。
谷歌希望模型能在一条任务轨迹中持续推理,生成数十万Token,处理更长更复杂的问题。值得一提的是,Artificial Analysis在测试时还用到了Gemini API的长输出续接功能——长回复可以暂停,再通过后续调用继续生成,最终让推理达到最多100万输出Token,同时避免请求超时。
这说明长任务不只需要模型本身有能力,也需要接口把连续生成的过程“接住”。用户看到的一项工作,背后可能经过多次调用。放到实际场景里更好理解:迁移一个代码库,需要读懂原实现、修改代码、检查编译、运行测试、再根据结果调整,每一步新信息都会改变下一步做法。更充足的输出空间,意味着这些连续步骤有机会被做得更深入。
Token是大语言模型处理文本的基本单位,大致对应一个英文单词或半个到一个中文字符。6.4万Token约合4到5万个汉字,而100万Token则相当于一部中等长度的长篇小说。传统API调用往往有严格的单次请求时长和体积限制,超时或超限会导致任务中断。谷歌引入的"长输出续接"机制本质上是把一个逻辑上连续的任务拆分成多个物理请求,每次调用把上一次的状态和进度传递下去,从应用层面绕过了单次请求的硬性限制。这对工程类任务尤其关键——代码重构或系统迁移不是一问一答,而是需要在同一"思维流"中累积数十轮中间结论后才能输出最终方案。
内部案例:从视频解码器到内核迁移
谷歌公布的内部案例中,LibGav-1这款开源视频解码器最值得展开。Argon智能体接手的是一个已存在的Rust移植版本,它通过多轮性能分析实验,研究编译器产生的结果,替换了约3.2万行SIMD代码。
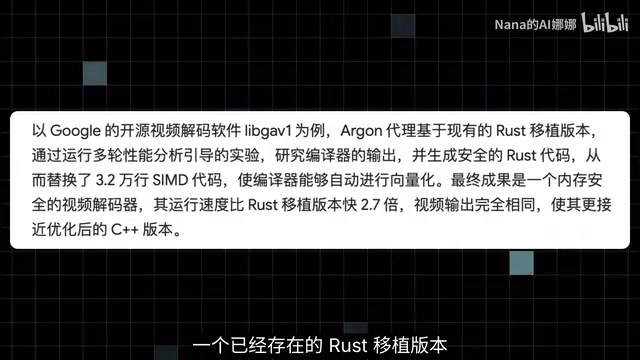
SIMD可以理解为让处理器用一条指令同时处理多路数据,在视频这类密集计算里直接影响速度。Argon用安全Rust重写相关代码,让编译器自动完成向量化。最终新解码器保持了相同的视频输出,运行速度达到原Rust移植版本的2.7倍,进一步接近经过优化的C++实现。
这个案例的价值很具体:模型要同时照顾安全性、运行速度和结果一致性。光把代码翻译成另一种语言远远不够,它需要通过实验找到兼顾这些要求的实现。
谷歌还在让Argon参与C/C++向Rust的大型迁移,范围从核心库的数万行代码延伸到Fuchsia操作系统超过80万行的Zircon内核。这些关键系统的重写,仍要经过自动化与人工审计、仿真测试、代码评审才会进入生产环境。模型负责推动工作,测试和审查负责决定成果能否使用——任务规模越大,这条边界越重要,因为局部改动看起来正确,和整个系统运行可靠,是两回事。
在数据中心案例中,一组Argon智能体分析整个服务器集群的性能遥测数据,自主识别并应用内存优化方案,部署后已释放超过300TiB内存,预计总节省量在500TiB到1PiB之间。此外的量子算法优化案例里,Argon在几分钟内让一个瓶颈子程序的时空资源开销相比已发表基线改进了40%。
SIMD(Single Instruction, Multiple Data,单指令多数据)是现代处理器的一类并行计算指令集,允许CPU或GPU用一条指令同时对多个数据元素执行相同操作。以视频解码为例,一帧图像由数百万像素组成,若逐像素处理效率极低;SIMD可以让处理器在单个时钟周期内同时操作8个、16个甚至32个像素值,大幅提升吞吐量。手写SIMD代码通常针对特定CPU架构(如x86的AVX2或ARM的NEON),可移植性差且容易引入安全漏洞。Argon的策略是用符合Rust安全规范的高层代码替代手写SIMD,再依靠编译器的自动向量化能力生成等效的底层指令,在保持安全性的同时接近手写优化的性能。这一路径之所以复杂,在于编译器的自动向量化并不总是最优,模型需要通过多轮实验找到能触发编译器高效优化的代码写法。
递归自我改进:乐观态度与证据之间
这些工程能力引出了一个更受关注的话题——递归自我改进(RSI)。DeepMind研究员王子瑞在发帖时表达了乐观态度,并开玩笑说模型已经超过自己,是时候去追逐咖啡师梦想了。

RSI描述的是这样一个循环:模型参与改进模型,改进后的模型又更擅长完成下一轮改进,每一轮提高的既是能力,也是继续提高能力的方法。关键问题是这个循环能不能持续下去。
目前谷歌展示的案例,是智能体在具体工程任务中寻找方案、测试结果、再优化。但“模型帮助改善工程系统”和“模型改善自身研发的循环”之间,还需要更多具体证据来连接。研究员的乐观代表他的判断,公开案例展示的是目前已披露的工程进展,两者需要分开看待。
递归自我改进(Recursive Self-Improvement,RSI)是AI安全领域的核心议题之一,最早由AI安全研究者Eliezer Yudkowsky系统阐述。其理论担忧在于:一旦AI系统具备足够能力参与改进自身的训练流程,能力提升可能形成正反馈循环,在人类难以干预的时间尺度内迅速加速。现实中,AI模型的训练涉及数据准备、架构设计、超参数调整、基础设施工程等多个环节,每个环节都有大量人类专家参与;即便模型能在某些子任务上提升效率,"完整闭环的自我改进"距离当前实际仍有相当距离。区分"模型辅助研发工程"(已有案例)与"模型驱动能力指数级增长"(尚待验证)对准确理解当前进展至关重要。
评测分裂:文本第一,网页第八
Argon在多项面向真实任务的评测上成绩亮眼:Deep SWE V1得分77.9%,衡量端到端业务执行的Automation Bench得分51.3%,长视频理解评测LV Bench得分91.7%,法律智能体评测得分19.6%(明显高于对比表中其他模型)。这些测试关注的已不是模型能否讲清概念,而是能否把任务推进到结果。

但Argon的优势分布得很不均匀。它在Deep SWE上领先,却在Frontier SWE V2上只有55%,低于GPT-6 Astra的65.5%;在Terminal Bench 4.0上得57.4%,而Claude Opus 5.5是65。
第三方评测的差异更明显。Arena公布的结果里,Argon在Text Arena以1525分排名第一,在代码、困难提示、指令遵循等文本类别表现突出,但在衡量网页开发的Code Arena只排第八。写出好文本和搭建出好网页需要不同的能力组合,后者还涉及界面细节、布局和交互。
这也让谷歌内部的分歧更容易理解:一些员工认为Gemini 4在真实编程任务中表现没有基准成绩那么亮眼,前端设计尤其薄弱;也有熟悉开发的员工认为模型已达前沿水平;谷歌则回应称“编程表现不佳”的说法不准确。对用户来说,自己的任务类型比一个总排名更有参考价值。
幻觉率与准确率:承认不知道也是一种能力
另一个值得关注的差异出现在模型面对未知问题时。在Artificial Analysis的智能指数中,高推理设置的Argon得53分,与最高推理设置的GPT-6 Astra持平。在AA Omniscience测试中,Argon的幻觉率是15%,在智能指数45分及以上的模型里最低。
但同一测试中,Argon的准确率是50%,低于Astra的63%。Artificial Analysis的解释是:Argon更倾向于承认不知道,而不是给出错误猜测。这两项成绩合在一起才构成完整表现——它答对的比例有自己的限制,但在没把握时更愿意停下来。
对法律、金融这样的知识工作,这种行为有实际意义:一个明确留下的空白可以继续查资料或交给专业人员,而一个写得流畅的错误答案可能被直接带进后续工作。用户真正需要的,是把可靠结论和待解决问题区分开。
成本账:低单价不等于低账单
Argon的首发优惠价为每百万输入Token 2美元、每百万输出Token 10美元,缓存输入价格降低95%(每百万Token 0.1美元)。对需要反复使用相同材料的任务,缓存优惠会显著影响开销。

但工作流程最终花多少钱,还和模型生成了多少内容有关。Artificial Analysis测试中,高推理设置的Argon平均每任务输出约6.2万Token,而Astra约2.7万。按优惠定价,Argon在这组任务的平均成本为1.99美元,约为Astra的60%;但按标准定价估算将是3.98美元,约为Astra的1.2倍。
也就是说,Argon目前的成本优势和首发折扣紧密相关。更长的推理轨迹给复杂任务留下空间,也会消耗更多Token。100万Token的上限是留给任务的容量,6.2万则是实际平均使用量。企业要把它接入流程,需要一起比较任务成果、用量和价格——调用单价低能不能变成最终账单低,要放到自己的工作里计算。
先开放网络安全:能力的另一面
谷歌首先开放的网络安全场景,把持续执行能力的另一面体现得很清楚。Argon能自主寻找、验证和修复漏洞。安全公司Wiz已通过Scan4Good项目使用它,为关键公共基础设施免费排查高风险暴露。在一次早期演示中,Argon发现了全球医院使用的一款医疗软件中的严重漏洞,涉及敏感个人信息暴露,此前的前沿模型没有识别出这一风险。在漏洞修复评测CWE Bench V1上,Argon以68%的成绩并列第一。
问题在于,同样的分析能力也可能被用来寻找攻击入口。谷歌因此先通过Frontier Safety相关计划向受信任的防御团队开放不带网络安全护栏的版本,同时加强防滥用、提示注入防护和运行监控。
间接提示注入指模型读取外部材料时,材料里夹带了试图指挥模型的恶意指令——如果模型把这些内容当成新命令,就会偏离原任务,对能连续行动的智能体,这种偏离会沿工作流程扩散。谷歌部署了监测推理过程和实际动作的机制,必要时停止执行,并强调避免把监控发现直接反馈进训练,以降低模型学会规避监控的风险。
间接提示注入(Indirect Prompt Injection)是针对自主AI智能体的一类特有攻击方式,与直接在对话框输入恶意指令不同,它将攻击载荷藏在模型会主动读取的外部内容中——例如网页、文档、邮件或代码注释。当模型爬取网页或分析文件时,若安全机制不足,这些隐藏指令可能被模型误判为来自用户的合法命令,从而执行数据外泄、权限提升或任务劫持等恶意操作。对于只做单轮问答的模型,此类风险影响有限;但对于能连续调用工具、访问文件系统和网络的长任务智能体,一次成功的注入可以沿整个工作流扩散,在后续多个步骤中持续产生影响。这也是谷歌在开放高自主权版本前着重强调提示注入防护的原因。
结语:竞争落到了“持续工作”上
Argon这次最有分量的部分,是它把旗舰模型的竞争落到了持续工作的能力上。代码迁移、内存优化、安全修复给出了具体方向;而不同评测的分裂、内部使用分歧和任务成本,则把仍待解决的问题如实留了下来。
对普通用户和企业而言,判断标准正在从“讲得好不好”转向“做到了哪一步、哪些结果还需要人接手”。价格可以降低尝试门槛,但稳定完成任务,才能决定它是否值得长期采用。
相关推荐

OpenAI 推出 Decisions API:让 AI 在毫秒间做决定
OpenAI 推出 Decisions API,基于 GPT-6 Luna 运行,可在毫秒级完成文本与图像的智能决策,支持销售线索分流、车道判断、机器人控制等场景,速度较传统推理提升近十倍。

AssemblyAI自研客服Joey:解决率从10%飙升至80%
AssemblyAI每天收到1000次API注册却仅有一名接入工程师,团队基于Claude Agent SDK自研AI客服Joey,一周内将端到端解决率从10%提升到80%,月成本仅700美元。本文拆解其四层架构与dogfooding方法论。

AI Agent开发入门:企业级智能体学习路径全解析
一套面向零基础的AI Agent开发系统课程解析,涵盖基础原理、提示工程、工具调用、多智能体协同,以及LangChain、CrewAI、Dify等主流框架实战,帮助开发者系统入门企业级智能体开发。