Gemini 4 Argon评测:基准亮眼实战仍逊Claude Opus 5.5

Gemini 4 Argon跑分亮眼、3D生成进步明显,但实战仍逊于Claude Opus 5.5,订阅策略也引发争议。
Google正式发布Gemini 4 Argon,官方基准成绩出色,但实测显示其在真实任务中落后于GPT-6 Astra,与Claude Opus 5.5的差距虽不大却确实存在。作者指出训练数据混入基准题目会造成跑分虚高,而新旧基准约10分的落差正暴露了泛化能力的短板。亮点集中在3D生成与创意编程:仅凭一张桌面照片即可用Blender生成完整游戏场景,一句极简提示词就能搭建苹果电脑博物馆网页。但同任务对比中,Opus 5.5成本高约三倍、视觉质量却好十倍。订阅层面同样混乱,Pro用户在Anti-Gravity编程工具中无法调用新模型,进一步削弱吸引力。
Google正式发布Gemini 4 Argon,所有用户终于可以亲自上手。官方基准测试成绩亮眼,但真实体验是否匹配?本文结合YouTube频道的一手测试,从基准跑分、真实案例、竞品对比到订阅可用性,全面拆解这款新模型。
基准测试与真实表现:分数好看,实战打折
Google发布的Gemini 4 Argon基准成绩相当漂亮,但视频作者指出,跑分与真实体感之间存在明显落差。在真实任务中,Gemini 4 Argon落后于GPT-6 Astra,与Claude Opus 5.5的差距不算大,但确实存在。
作者解释了一个行业现象:训练数据中混入大量基准题目,会让模型在跑分上“作弊”式地好看。他用Meta近期的Muse等新模型举例,称其“完全是benchmark调优”。相比之下,Gemini的情况尚可接受——旧基准(如SWE)上Gemini得分更高,但在更新的基准上落后约10分。这说明它并非完全依赖刷分,但新旧基准的差距仍然暴露了泛化能力的短板。
基准测试(Benchmark)与数据污染
基准测试是AI行业衡量模型能力的标准化考题集,常见的有SWE-bench(软件工程任务)、MMLU(多学科知识)、GPQA(专家级问答)等。厂商发布新模型时,通常会用这些公开基准的得分作为能力证明。问题在于,这些题目本身是公开的,如果训练语料中混入了基准题目及其答案,模型就可能在测试时"背出"答案而非真正推理,业内称为数据污染(data contamination)或benchmark调优。
这也是视频作者用"旧基准得分高、新基准落后"来判断模型是否刷分的逻辑:旧基准流传已久、被污染概率高;新基准发布时间短,模型尚未"见过",更能反映真实的泛化能力。新旧基准之间约10分的落差,正是这种污染效应的一个侧面信号。
真实案例:3D与创意生成是亮点
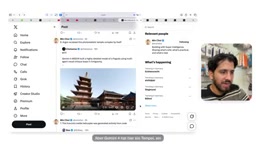
视频展示了Google AI Studios员工Min Chua(音译)等用户分享的案例。将一张桌面照片交给Gemini 4 Argon,要求用Blender生成游戏,结果相当不错——3D场景完整、视觉质量在线。作者特别对比了上一代Gemini 3.8 Flash,称其“游戏编程完全不行”,而4 Argon的进步明显。
另一个案例只用了一句极简提示词——“做一个过去50年苹果电脑博物馆”,模型就自动搜集素材、搭建网页,连配图都自行挑选。虽然个别图片裁剪不够精细,但整体完成度很高,体现了对世界知识和上下文的理解力。
DeepMind创始人Demis Hassabis和Google CEO也转发了相关案例。视频中还出现了用Gemini 4 Argon生成照片级写实神庙、多轮批判性迭代(critical loops)优化的作品,以及Kia von Bee等创作者产出的3D内容。
Blender与"一句话生成游戏"的技术含义
Blender是一款开源的三维创作软件,支持建模、材质、动画与内置Python脚本。让大模型"用Blender生成游戏",本质上要求模型同时具备三种能力:编写可运行的Python脚本调用Blender API、构造合理的三维场景几何与光照、以及设计基本的游戏逻辑。这比单纯生成一张图片或一段代码要难得多,因为它需要模型在多轮工具调用中保持对整体目标的把握。
文中提到的"批判性迭代(critical loops)"指模型生成结果后自我审视、指出问题并重新生成的循环流程,是当前提升生成质量的主流手段之一。而"极简提示词搭建博物馆网页"则考验模型自主检索素材、组织信息架构的智能体(agent)能力。
与Claude Opus 5.5正面对比:成本低但质量差距明显
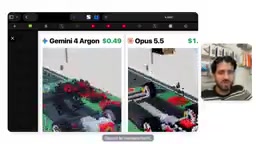
视频中最有说服力的部分,是同一任务下不同模型的直接对比。Gemini 4 Argon生成某作品仅花费19美分,而Claude Opus 5.5成本高出约三倍,但视觉效果“好十倍”。作者承认,如果优化提示词,Gemini的结果会更好,但差距依然肉眼可见。
他并非否定Gemini 4 Argon——“它不差”,只是Opus 5.5明显更强。他还提到Anthropic即将推出Fable 5.5,届时差距可能进一步拉大。
另一项值得关注的测试是把Gemini 4 Argon装入机器人,通过摄像头自主学习和迭代改进。作者认为这展示了模型的潜力,但综合来看,Gemini 4 Argon“绝对没有其他模型走得远”。
订阅可用性混乱:Pro用户被Anti-Gravity拒之门外
作者对Google的订阅策略直言“搞砸了”。免费用户现在只能使用Gemini 3.x系列(如3.6、3.7),此前可用的3.8 Flash已被收回,但日常使用尚可应付。
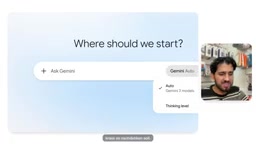
Pro订阅用户可以使用Gemini 3.8 Flash、3.1 Pro和4 Argon,并能调节“思考强度”。但关键问题在于:Pro用户在Anti-Gravity(Google对标Claude Code和Codex的编程工具)中无法调用Gemini 4 Argon。作者对此非常不满——每月20欧元的Claude Code和Codex订阅能做的事情多得多,而Google却在自家编程工具里锁住了最新模型。
视频作者表示未来将推出自己的独立基准测试,用更贴近真实场景的方式比较各模型。
Anti-Gravity与AI编程工具的订阅格局
Anti-Gravity是Google面向开发者的AI编程工具,定位对标Anthropic的Claude Code和OpenAI的Codex——这类工具以命令行或IDE插件形式存在,能读写代码库、执行命令、自动完成多步开发任务,是当前AI厂商争夺专业用户的关键入口。
这类工具的商业模式通常是订阅制,用户付费的核心诉求就是获得最新、最强的模型。因此,把最新模型锁在自家编程工具之外,等于削弱了订阅的核心价值。文中"每月20欧元"的对比正说明这一点:同等价位下,竞品订阅能提供完整的最新模型访问权限,而Google的Pro订阅在Anti-Gravity中却无法调用Gemini 4 Argon,这在用户看来是明显的价值缺口。
总结:方向对了,但还差一口气
Gemini 4 Argon在3D生成、创意编程和世界知识理解上进步明显,基准成绩也可圈可点。但真实任务中的质量仍落后于Claude Opus 5.5,新旧基准的分数落差也提醒我们跑分不等于实力。订阅层面的混乱——尤其是Anti-Gravity对Pro用户锁住新模型——进一步削弱了它的吸引力。Google走对了方向,但距离“比Claude Opus 5.5更好”还有路要走。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。